
ToolMage
Anmelden

Best 1 Text-to-Speech AI tools for KI-Audio

Popular Text-to-Speech AI tools in KI-Audio include Monet, helping you work more efficiently.

Monet
Freemium

Monet

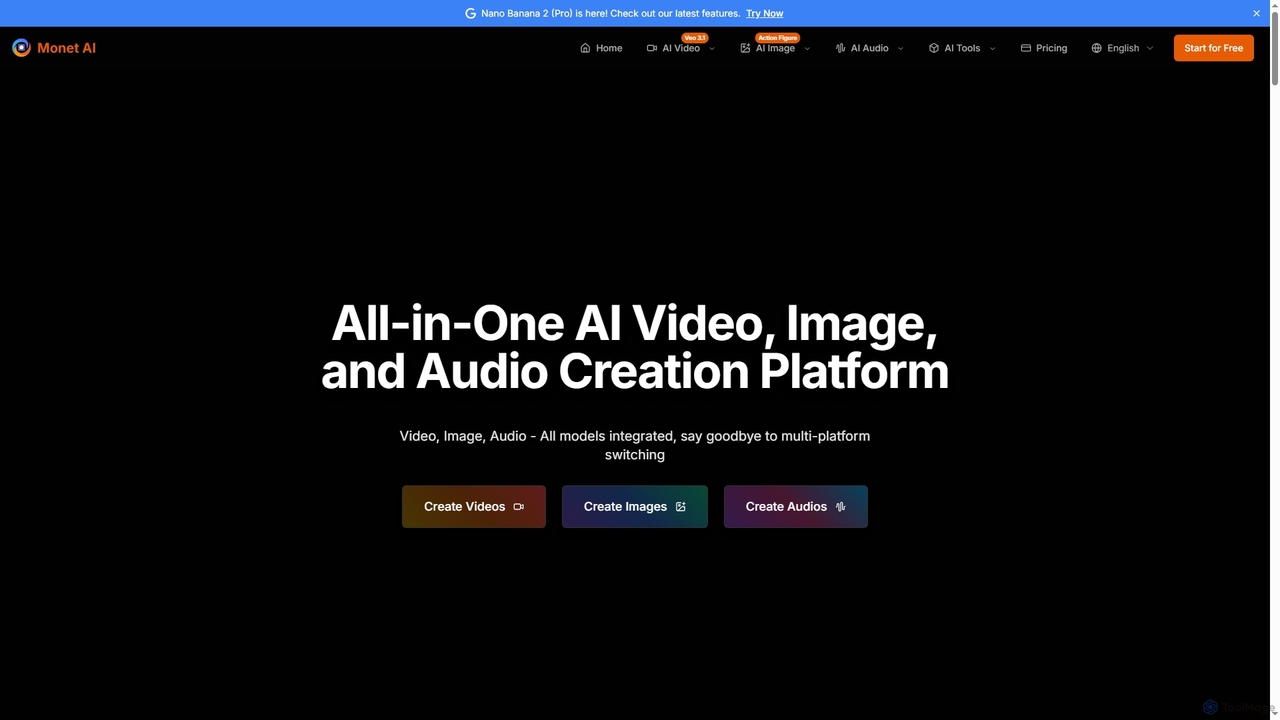
Monet ist eine All-in-One-KI-Erstellungsplattform, die führende KI-Modelle zur Generierung hochwertiger Videos, Bilder und Audios integriert. Sie bietet Text-zu-Video, Bild-zu-Video, Text-zu-Bild, Stiltransfer und Text-zu-Sprache-Funktionen, die kreative Arbeitsabläufe für verschiedene Benutzer optimieren.

Bildgenerierung
Visits 196.2KFavorites 153Likes 133

About Text-to-Speech

Text-to-Speech (TTS)-Tools sind KI-gestützte Anwendungen, die geschriebenen Text in natürlich klingende gesprochene Audioinhalte umwandeln. Diese Tools nutzen fortschrittliche Deep-Learning-Modelle und neuronale Netze, um menschenähnliche Stimmen zu synthetisieren, oft mit anpassbaren Tönen und Emotionen. Sie ermöglichen es Benutzern, Artikel, Dokumente und Skripte in ansprechende Audioinhalte zu verwandeln, wodurch die Zugänglichkeit verbessert und die Reichweite von Inhalten auf verschiedenen Plattformen erweitert wird. Diese Technologie ist ein entscheidender Bestandteil der breiteren KI-Audio-Landschaft und bietet effiziente und skalierbare Lösungen zur Stimmerzeugung.

Kernfunktionen

  • Natürliche Sprachsynthese: Erzeugt aus Text hochrealistische und menschenähnliche Sprache.
  • Mehrsprachige Unterstützung: Bietet eine breite Palette von Sprachen, Dialekten und Akzenten für globale Reichweite.
  • Stimmenanpassung: Ermöglicht die Anpassung von Tonhöhe, Geschwindigkeit, Lautstärke und emotionalen Nuancen.
  • SSML-Integration: Unterstützt die Speech Synthesis Markup Language für eine feinkörnige Kontrolle über Aussprache und Pausen.
  • API-Zugang: Bietet programmatische Schnittstellen für die nahtlose Integration in Anwendungen und Workflows.

Anwendungsfälle

Die Text-to-Speech-Technologie wird in verschiedenen Sektoren weit verbreitet eingesetzt. Content-Ersteller nutzen sie, um Audioversionen von Blogs und E-Books zu produzieren, während Pädagogen sie in E-Learning-Plattformen für zugängliche Kursmaterialien integrieren. Unternehmen setzen TTS für automatisierten Kundenservice, interaktive Sprachdialogsysteme (IVR) und dynamische Voiceovers in Marketingkampagnen ein, wodurch Produktionskosten und -zeit erheblich reduziert werden.

Auswahlkriterien

Bei der Auswahl eines Text-to-Speech-Tools sollten Sie die Sprachqualität und Natürlichkeit priorisieren, um sicherzustellen, dass sie zum Ton Ihrer Marke passt. Bewerten Sie die Bandbreite der unterstützten Sprachen und Akzente für Ihre Zielgruppe. Berücksichtigen Sie Anpassungsoptionen für Sprachparameter und emotionalen Ausdruck. Prüfen Sie die API-Verfügbarkeit für die Integration in bestehende Systeme und vergleichen Sie Preismodelle basierend auf Nutzungsvolumen und Funktionsumfang, um eine kostengünstige Lösung zu finden.

Text-to-Speech use cases

1

Erstellung von Audioversionen von Blogbeiträgen und Artikeln

Content-Ersteller und Blogger können Text-to-Speech-Tools verwenden, um ihre geschriebenen Artikel in ansprechende Audioformate umzuwandeln. Durch einfaches Einfügen von Text in das Tool können sie natürlich klingende Erzählungen generieren und Blogbeiträge in Podcasts oder Audioartikel verwandeln. Dies erweitert ihre Zielgruppe auf Personen, die lieber zuhören als lesen, wie Pendler oder Sehbehinderte, und erhöht die Inhaltskonsumation und Zugänglichkeit erheblich, ohne professionelle Sprecher zu benötigen.

2

Verbesserung von E-Learning-Modulen und Zugänglichkeit

Pädagogen und E-Learning-Entwickler können Text-to-Speech nutzen, um zugängliche und ansprechende Kursmaterialien zu erstellen. Durch die Umwandlung von Lektionstexten, Quizfragen und Anweisungen in Audio bedienen sie verschiedene Lernstile, einschließlich auditiver Lerner und Studenten mit Leseschwierigkeiten oder Sehbehinderungen. Dies stellt sicher, dass Bildungsinhalte inklusiv sind und unterwegs konsumiert werden können, wodurch das Engagement und das Verständnis der Studenten auf verschiedenen digitalen Lernplattformen verbessert werden.

3

Automatisierung von Kundenservice und IVR-Systemen

Unternehmen können die Text-to-Speech-Technologie in ihre Kundenservice-Operationen integrieren, insbesondere für interaktive Sprachdialogsysteme (IVR) und Chatbots. Anstatt sich auf vorab aufgezeichnete Nachrichten zu verlassen, ermöglicht TTS die dynamische, Echtzeit-Generierung von Antworten, die Anrufern personalisierte Informationen liefern. Dies reduziert den Bedarf an umfangreichen Sprachaufnahmen, gewährleistet Konsistenz in der Nachrichtenübermittlung und ermöglicht schnelle Aktualisierungen von Informationen, was zu effizienteren und reaktionsschnelleren Kundeninteraktionen führt.

4

Erstellung von Voiceovers für Marketingvideos und Anzeigen

Marketingfachleute und Werbetreibende können Text-to-Speech-Tools nutzen, um schnell professionelle Voiceovers für ihre Videoinhalte, Produktdemonstrationen und Social-Media-Anzeigen zu erstellen. Dies eliminiert den Zeit- und Kostenaufwand für die Anstellung von Sprechern oder die Einrichtung von Aufnahmestudios. Mit TTS können Marketingexperten verschiedene Stimmen, Sprachen und Skripte für A/B-Tests ihrer Kampagnen ausprobieren, um sicherzustellen, dass ihre Botschaft effizient und kostengünstig bei verschiedenen Zielgruppen ankommt.

5

Entwicklung dynamischer Dialoge für Spiele und virtuelle Assistenten

Spieleentwickler und Ersteller virtueller Assistenten können Text-to-Speech-APIs nutzen, um dynamische und kontextbezogene Dialoge für Nicht-Spieler-Charaktere (NPCs) oder KI-Assistenten zu generieren. Anstatt jede mögliche Zeile vorab aufzuzeichnen, ermöglicht TTS die spontane Spracherzeugung basierend auf Benutzereingaben oder Spielereignissen. Dies ermöglicht interaktivere und personalisiertere Erlebnisse, reduziert die Entwicklungszeit und den Speicherbedarf und bietet gleichzeitig eine Vielzahl von Gesprächsmöglichkeiten.

6

Erstellung von Audio-Nachrichtenbriefings und Berichten

Nachrichtenorganisationen und Medien können die Text-to-Speech-Technologie nutzen, um geschriebene Nachrichtenartikel und Berichte schnell in Audio-Briefings umzuwandeln. Dies ermöglicht es ihnen, Zuhörern eine alternative Möglichkeit zum Konsumieren von Nachrichten zu bieten, die sich an diejenigen richtet, die beim Multitasking oder Pendeln lieber zuhören. Durch die Automatisierung des Audioproduktionsprozesses können Medienunternehmen zeitnahe Nachrichten-Updates über verschiedene Plattformen, einschließlich Smart Speakern und Podcast-Kanälen, bereitstellen und so ihre Content-Bereitstellungsstrategie verbessern.

Text-to-Speech FAQ

Was sind Text-to-Speech (TTS)-Tools?

Text-to-Speech (TTS)-Tools sind KI-gestützte Anwendungen, die geschriebenen Text in gesprochene Audioinhalte umwandeln. Sie nutzen fortschrittliche Algorithmen und neuronale Netze, um menschenähnliche Stimmen zu synthetisieren, oft mit anpassbaren Tönen, Sprachen und emotionalen Nuancen. Diese Tools werden hauptsächlich eingesetzt, um die Zugänglichkeit zu verbessern, Voiceovers zu automatisieren und dynamische Audioinhalte aus jeder schriftlichen Eingabe zu erstellen, wodurch Informationen für verschiedene Zielgruppen leichter konsumierbar werden.

Wie wähle ich das richtige Text-to-Speech-Tool aus?

Um das richtige Text-to-Speech-Tool auszuwählen, sollten Sie mehrere Faktoren berücksichtigen. Erstens, bewerten Sie die Natürlichkeit und Qualität der angebotenen Stimmen, um sicherzustellen, dass sie menschenähnlich klingen und zum Ton Ihres Projekts passen. Zweitens, prüfen Sie die Bandbreite der unterstützten Sprachen und Akzente, wenn Sie mehrsprachige Inhalte benötigen. Drittens, suchen Sie nach Anpassungsoptionen wie Tonhöhe, Geschwindigkeit und emotionalem Ausdruck. Bewerten Sie schließlich die API-Integrationsmöglichkeiten für Ihren Workflow und vergleichen Sie Preismodelle basierend auf Ihrem Nutzungsvolumen und den erforderlichen Funktionen.

Was sind die Hauptvorteile der Verwendung von Text-to-Speech?

Die Hauptvorteile der Verwendung von Text-to-Speech-Tools umfassen eine verbesserte Zugänglichkeit für sehbehinderte Personen oder solche mit Leseschwierigkeiten, die es ihnen ermöglicht, schriftliche Inhalte auditiv zu konsumieren. Sie bieten erhebliche Zeit- und Kosteneinsparungen durch die Automatisierung der Voiceover-Produktion, wodurch die Notwendigkeit menschlicher Sprecher und Aufnahmestudios entfällt. TTS gewährleistet zudem Konsistenz in Stimme und Ton über große Mengen an Inhalten, unterstützt schnelle Inhaltsaktualisierungen und ermöglicht eine globale Reichweite durch mehrsprachige Funktionen, wodurch die Inhaltserstellung effizienter und inklusiver wird.

Wie unterscheidet sich Text-to-Speech von menschlichen Voiceovers?

Text-to-Speech (TTS) unterscheidet sich von menschlichen Voiceovers hauptsächlich in seiner Generierungsmethode und Skalierbarkeit. TTS verwendet KI-Algorithmen, um Stimmen aus Text zu synthetisieren, was eine sofortige, skalierbare Produktion in mehreren Sprachen und Tönen ohne menschliches Eingreifen ermöglicht. Menschliche Voiceovers hingegen beinhalten professionelle Sprecher, die Audio aufnehmen und eine einzigartige menschliche Note, nuancierte emotionale Darbietung und künstlerische Interpretation bieten. Während menschliche Voiceovers bei maßgeschneiderten, emotionsgeladenen Projekten hervorragend sind, bietet TTS eine unübertroffene Effizienz, Kosteneffizienz und Konsistenz für große, dynamische oder häufig aktualisierte Inhalte.

Können Text-to-Speech-Tools emotionale oder ausdrucksstarke Stimmen erzeugen?

Ja, moderne Text-to-Speech-Tools, insbesondere solche, die von fortschrittlichen neuronalen Netzen und Deep Learning angetrieben werden, sind zunehmend in der Lage, emotionale und ausdrucksstarke Stimmen zu erzeugen. Viele Plattformen bieten Optionen zur Anpassung von Parametern wie Tonhöhe, Sprechgeschwindigkeit und Lautstärke, und einige ermöglichen es Benutzern sogar, spezifische emotionale Töne wie glücklich, traurig, wütend oder aufgeregt auszuwählen. Diese Fähigkeit ist entscheidend, um ansprechendere und kontextuell passendere Audioinhalte zu erstellen und über monotone Roboterstimmen hinauszugehen, um ein reichhaltigeres Hörerlebnis zu bieten.