
ToolMage
Anmelden

Best 1 Modelloptimierung AI tools for KI-Infrastruktur

Popular Modelloptimierung AI tools in KI-Infrastruktur include Narrow AI, helping you work more efficiently.

Narrow AI
Paid

Narrow AI

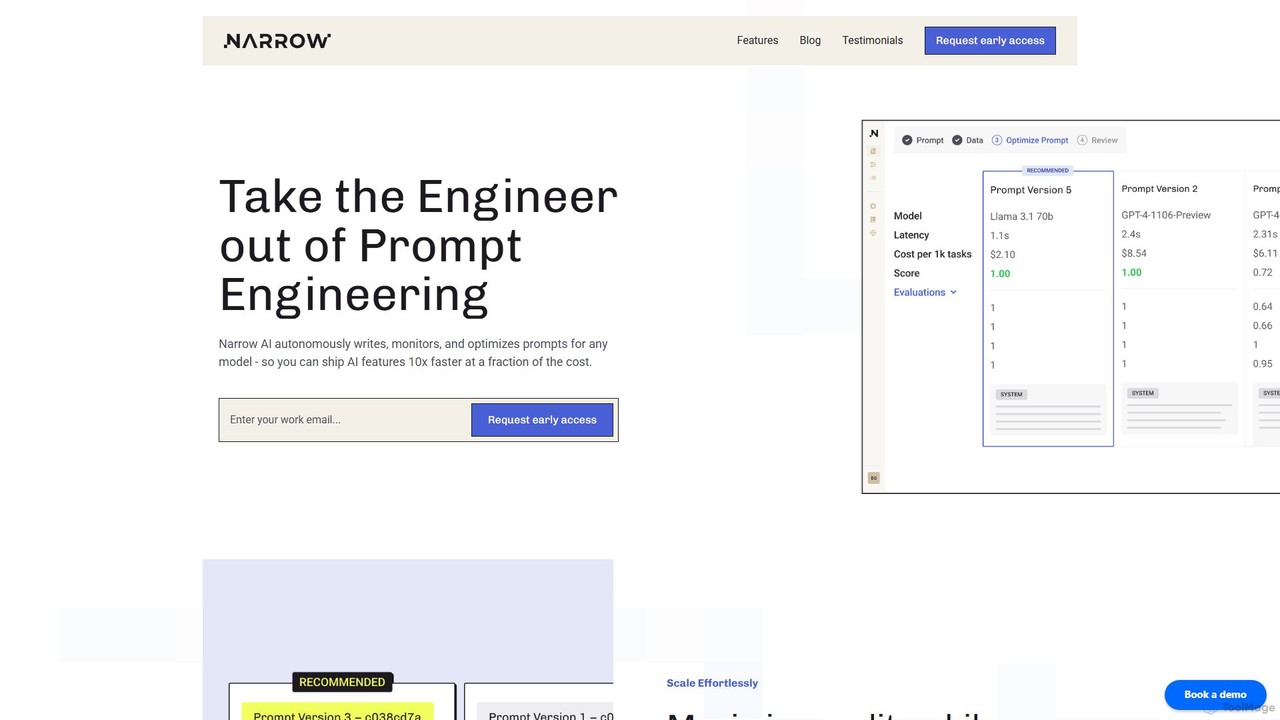
Narrow AI ist eine LLM-Optimierungsplattform für Entwickler, die das Prompt-Engineering und die Modellauswahl automatisiert, um die Betriebskosten für KI um bis zu 95 % drastisch zu senken. Sie optimiert Arbeitsabläufe, verbessert die Genauigkeit und beschleunigt die Bereitstellung hochwertiger, latenzarmer KI-Funktionen.

Modelloptimierung
Visits 8.3KFavorites 139Likes 146

About Modelloptimierung

Modelloptimierungs-Tools sind eine spezialisierte Kategorie von KI-Infrastruktursoftware, die darauf ausgelegt ist, trainierte maschinelle Lernmodelle kleiner, schneller und energieeffizienter zu machen. Diese Tools wenden Techniken wie Quantisierung, Pruning und Wissensdestillation an, um den Rechen- und Speicherbedarf eines Modells ohne signifikanten Genauigkeitsverlust zu reduzieren. Dieser Prozess ist entscheidend für den Einsatz komplexer KI auf ressourcenbeschränkter Hardware wie Mobiltelefonen oder IoT-Geräten und zur Senkung der Betriebskosten von großen KI-Diensten in der Cloud. Sie überbrücken die Lücke zwischen einem trainierten Modell und seiner praktischen Anwendung in der realen Welt.

Kernfunktionen

  • Quantisierung: Reduziert die Präzision der Modellgewichte (z. B. von 32-Bit-Float auf 8-Bit-Integer), um die Größe zu verringern und die Berechnung zu beschleunigen.
  • Pruning (Beschneidung): Entfernt systematisch weniger wichtige Gewichte oder Verbindungen aus dem neuronalen Netzwerk, um ein kleineres, dünner besetztes Modell zu erstellen.
  • Wissensdestillation: Trainiert ein kleineres, kompaktes „Schüler“-Modell, um das Verhalten eines größeren, komplexeren „Lehrer“-Modells nachzuahmen.
  • Modellkompilierung: Konvertiert ein Modell in ein hardwarespezifisches, hochoptimiertes ausführbares Format für Zielgeräte wie GPUs, TPUs oder CPUs.
  • Leistungsprofilierung: Analysiert die Ausführung eines Modells, um Leistungsengpässe in Bezug auf Geschwindigkeit, Speicher oder Stromverbrauch zu identifizieren und zu beheben.

Anwendungsfälle

Die Modelloptimierung ist für MLOps-Ingenieure, KI-Entwickler und Ingenieure für eingebettete Systeme unerlässlich. Sie wird in Branchen wie der Unterhaltungselektronik für On-Device-KI, der Automobilindustrie für Echtzeit-Wahrnehmungssysteme und im Cloud Computing zur Verwaltung der Inferenzkosten von großen Sprachmodellen (LLMs) und Empfehlungsmaschinen eingesetzt. Jede Anwendung, die eine effiziente KI-Inferenz erfordert, profitiert von diesen Tools.

Wie man wählt

Bei der Auswahl eines Modelloptimierungs-Tools sollten Sie dessen Kompatibilität mit Ihren KI-Frameworks (z. B. TensorFlow, PyTorch, ONNX) berücksichtigen. Bewerten Sie die Unterstützung für Ihre Zielhardware, von Server-GPUs bis zu mobilen NPUs. Beurteilen Sie die Bandbreite der angebotenen Optimierungstechniken und den Grad der Automatisierung im Vergleich zur manuellen Steuerung. Analysieren Sie schließlich die Fähigkeit, den Kompromiss zwischen Leistungssteigerung und potenziellem Genauigkeitsverlust zu managen.

Modelloptimierung use cases

1

Bereitstellung von KI-Modellen auf Edge-Geräten

Ein Entwickler mobiler Anwendungen muss eine Echtzeit-Objekterkennungsfunktion in seine App integrieren. Das ursprüngliche Modell ist zu groß und zu langsam, um auf einem Smartphone reibungslos zu laufen, was zu einem hohen Akkuverbrauch und einer schlechten Benutzererfahrung führt. Durch die Verwendung eines Modelloptimierungs-Tools wendet der Entwickler 8-Bit-Quantisierung und Pruning auf das Modell an. Dies reduziert seine Größe um 75 % und verdreifacht die Inferenzgeschwindigkeit, sodass die Funktion effizient auf dem Gerät mit minimalen Auswirkungen auf die Akkulaufzeit ausgeführt werden kann, was eine reaktionsschnelle und leistungsstarke Benutzererfahrung ermöglicht.

2

Reduzierung der Cloud-Inferenzkosten für LLMs

Ein Tech-Startup betreibt einen beliebten Chatbot-Dienst, der von einem großen Sprachmodell (LLM) angetrieben wird. Die hohen Kosten für GPU-Server für die Inferenz beeinträchtigen ihre Rentabilität. Das MLOps-Team verwendet eine Modelloptimierungs-Suite, um Wissensdestillation und strukturiertes Pruning anzuwenden. Sie erstellen ein kleineres, spezialisiertes Modell, das 98 % der Leistung des Originals bei ihren spezifischen Aufgaben beibehält. Dieses optimierte Modell kann 2,5-mal mehr gleichzeitige Benutzer auf derselben Hardware verarbeiten, was ihre Cloud-Infrastrukturkosten direkt um über 50 % senkt und die Skalierbarkeit des Dienstes verbessert.

3

Ermöglichung von Echtzeit-KI in Automobilsystemen

Ein Automobilingenieur entwickelt ein fortschrittliches Fahrerassistenzsystem (ADAS), das ein neuronales Netzwerk zur Fußgängererkennung verwendet. Das System hat strenge Latenzanforderungen – eine Entscheidung muss in Millisekunden getroffen werden. Der Ingenieur verwendet ein Modellkompilierungs-Tool, um sein PyTorch-Modell in eine hochoptimierte Engine für die spezifische eingebettete GPU des Autos umzuwandeln. Der Kompilierungsprozess fusioniert Schichten und optimiert den Speicherzugriff, wodurch die Inferenzlatenz um 60 % reduziert wird und sichergestellt wird, dass das System seine kritischen Echtzeit-Leistungsziele für die Sicherheit erfüllt.

4

Anpassung von Modellen für stromsparende Mikrocontroller

Ein Ingenieur für eingebettete Systeme entwirft ein Smart-Home-Gerät mit einer Keyword-Spotting-Funktion. Die Zielhardware ist ein winziger Mikrocontroller mit nur 256 KB RAM. Das ursprüngliche TensorFlow Lite-Modell ist zu groß, um darauf zu passen. Mit einem fortschrittlichen Optimierungs-Toolkit wendet der Ingenieur aggressives Gewichts-Pruning und 8-Bit-Integer-Quantisierung an. Dadurch wird die Modellgröße von 1 MB auf nur 180 KB reduziert, was eine erfolgreiche Bereitstellung auf dem Mikrocontroller ermöglicht, während eine Genauigkeit von über 95 % für die Ziel-Keywords beibehalten wird, was die intelligente Funktion realisierbar macht.

5

Beschleunigung von E-Commerce-Empfehlungsmaschinen

Ein MLOps-Team bei einem großen E-Commerce-Unternehmen verwaltet ein Deep-Learning-Empfehlungsmodell. Um Echtzeit-Vorschläge zu liefern, muss die Inferenzlatenz extrem niedrig sein. Sie verwenden ein Leistungsprofilierungs-Tool, um festzustellen, dass bestimmte Schichten in ihrem Modell Rechenengpässe auf ihren Server-GPUs darstellen. Das Optimierungs-Tool schlägt gezielte Optimierungen vor, einschließlich der Kompilierung dieser spezifischen Schichten mit einer anderen Präzision (gemischte Präzision). Nach Anwendung dieser Änderungen sinkt die End-to-End-Latenz des Empfehlungsdienstes um 40 %, was zu schnelleren Seitenladezeiten und einer messbaren Steigerung des Benutzerengagements und der Verkäufe führt.

6

Optimierung von NLP-Modellen für schnellere API-Antworten

Ein SaaS-Unternehmen bietet eine API zur Textzusammenfassung an. Kunden beschweren sich über langsame Antwortzeiten bei großen Dokumenten. Das Backend-Team identifiziert das NLP-Modell als den Engpass. Anstatt ein neues Modell von Grund auf neu zu trainieren, verwenden sie Wissensdestillation. Sie trainieren ein kleineres, schnelleres Transformer-Modell (den „Schüler“), um die Ausgabe ihres großen, genauen Modells (des „Lehrers“) zu replizieren. Das neue Schülermodell ist 4x schneller und wird in der Produktion eingesetzt, wodurch die durchschnittliche API-Antwortzeit von 3 Sekunden auf unter 700 Millisekunden reduziert wird, was die Kundenzufriedenheit erheblich verbessert.

Modelloptimierung FAQ

Was sind KI-Modelloptimierungs-Tools?

KI-Modelloptimierungs-Tools sind Software, die trainierte maschinelle Lernmodelle für den Einsatz effizienter macht. Ihr Hauptziel ist es, die Größe eines Modells zu reduzieren, seine Latenz zu verringern (die Inferenz zu beschleunigen) und seinen Stromverbrauch zu senken, oft mit minimalen Auswirkungen auf die Genauigkeit. Sie erreichen dies durch Techniken wie Quantisierung (Verwendung von weniger Bits für Zahlen), Pruning (Entfernen redundanter Teile) und Modellkompilierung für spezifische Hardware. Diese Tools sind ein entscheidender Bestandteil der MLOps-Pipeline und ermöglichen den Betrieb von KI auf allem, von leistungsstarken Cloud-Servern bis hin zu winzigen Mikrocontrollern.

Wie wähle ich das richtige Modelloptimierungs-Tool aus?

Die Wahl des richtigen Tools hängt von Ihren spezifischen Projektanforderungen ab. Berücksichtigen Sie diese Faktoren:

  • Framework-Unterstützung: Stellen Sie sicher, dass das Tool mit dem Framework kompatibel ist, das Sie für das Training verwendet haben (z. B. TensorFlow, PyTorch, JAX).
  • Hardware-Ziele: Prüfen Sie, ob es für Ihre Bereitstellungshardware optimieren kann, wie z. B. NVIDIA-GPUs, ARM-CPUs oder spezialisierte KI-Beschleuniger.
  • Verfügbarkeit von Techniken: Bietet es die spezifischen Optimierungsmethoden, die Sie benötigen, wie Post-Training-Quantisierung, Pruning oder Destillation?
  • Benutzerfreundlichkeit: Einige Tools bieten eine automatisierte Ein-Klick-Optimierung, während andere eine granulare Kontrolle für Experten ermöglichen. Wählen Sie basierend auf dem Kenntnisstand Ihres Teams.
  • Genauigkeit vs. Leistung: Bewerten Sie, wie gut das Tool es Ihnen ermöglicht, den Kompromiss zwischen Modellgenauigkeit und Leistungssteigerungen zu verwalten.
Was ist der Unterschied zwischen Modelloptimierung und Modelltraining?

Modelltraining und Modelloptimierung sind zwei unterschiedliche Phasen im Lebenszyklus eines KI-Modells. Das Modelltraining ist der Prozess, bei dem einem Modell beigebracht wird, genaue Vorhersagen zu treffen, indem es mit großen Datenmengen gefüttert wird. Das Ziel ist die Maximierung der Genauigkeit. Die Modelloptimierung findet *nach* dem Training statt. Ihr Ziel ist es nicht, die Genauigkeit zu verbessern, sondern das bereits trainierte Modell kleiner, schneller und effizienter für den realen Einsatz zu machen. Kurz gesagt, das Training erzeugt ein *genaues* Modell, während die Optimierung ein *praktisches* und *einsetzbares* Modell erzeugt.

Was sind die primären Techniken zur Modelloptimierung?

Die gebräuchlichsten Techniken, die von Modelloptimierungs-Tools verwendet werden, umfassen:

  • Quantisierung: Umwandlung der Gewichte eines Modells von hochpräzisen Formaten (wie 32-Bit-Gleitkommazahlen) in niedrigpräzisere (wie 8-Bit-Ganzzahlen). Dies reduziert die Modellgröße erheblich und kann Berechnungen auf kompatibler Hardware beschleunigen.
  • Pruning: Entfernen einzelner Gewichte oder ganzer Strukturen (wie Filter oder Neuronen) aus einem Modell, die nur geringe Auswirkungen auf dessen Ausgabe haben. Dies erzeugt ein kleineres, dünner besetztes Modell.
  • Wissensdestillation: Verwendung eines großen, genauen „Lehrer“-Modells, um ein kleineres, schnelleres „Schüler“-Modell zu trainieren, das dessen Vorhersagen nachahmt.
  • Modellkompilierung: Umwandlung eines Modells von einem allgemeinen Framework-Format in einen hochspezialisierten, hardwarespezifischen Code für maximale Leistung.
Warum ist die Modelloptimierung für reale KI-Anwendungen entscheidend?

Die Modelloptimierung ist entscheidend, weil sie theoretische KI-Modelle praktisch macht. Ein hochgenaues Modell ist nutzlos, wenn es für eine Echtzeitanwendung zu langsam, für ein mobiles Gerät zu groß oder für den Betrieb in der Cloud zu teuer ist. Die Optimierung begegnet diesen realen Einschränkungen durch:

  • Ermöglichung von Edge-KI: Sie ermöglicht die Ausführung komplexer Modelle direkt auf Geräten wie Smartphones, Autos und intelligenten Kameras, was eine geringe Latenz und den Datenschutz gewährleistet.
  • Kostensenkung: Optimierte Modelle benötigen weniger Rechenleistung, was sich direkt in niedrigeren Cloud-Computing-Rechnungen und einem geringeren Energieverbrauch niederschlägt.
  • Verbesserung der Benutzererfahrung: Schnellere Inferenz führt zu schnelleren API-Antworten und reaktionsschnelleren Anwendungen, was für die Benutzerzufriedenheit entscheidend ist.