Eine Vektordatenbank ist eine spezialisierte Datenbank, die zum Speichern, Verwalten und Abfragen von hochdimensionalen Vektoren entwickelt wurde, welche numerische Darstellungen von Daten wie Text, Bildern oder Audio sind. Diese Datenbanken verwenden fortschrittliche Indexierungsalgorithmen, um eine effiziente Ähnlichkeitssuche zu ermöglichen, wodurch KI-Systeme Datenpunkte finden können, die semantisch ähnlich sind, anstatt nur exakte Übereinstimmungen. Sie sind grundlegend für die Bereitstellung moderner KI-Anwendungen, die auf dem Verständnis von Kontext und Beziehungen innerhalb unstrukturierter Daten basieren, und dienen als entscheidende Komponente innerhalb der breiteren KI-Infrastruktur. Durch die Umwandlung komplexer Daten in Vektoren erschließen diese Datenbanken Funktionen für die intelligente Informationsbeschaffung und personalisierte Erlebnisse.
Kernfunktionen
- Effiziente Vektorindizierung: Nutzt ausgeklügelte Algorithmen wie HNSW (Hierarchical Navigable Small Worlds) oder IVF_FLAT, um Vektoren für eine schnelle und genaue Ähnlichkeitssuche zu organisieren, selbst bei massiven Datensätzen.
- Ähnlichkeitssuche: Ermöglicht Approximate Nearest Neighbor (ANN)-Abfragen, um Vektoren, die einem gegebenen Abfragevektor semantisch am ähnlichsten sind, schnell zu identifizieren und abzurufen, was für das Kontextverständnis entscheidend ist.
- Hybride Suche: Kombiniert die Leistungsfähigkeit der Vektorähnlichkeitssuche mit traditioneller Metadatenfilterung, sodass Benutzer Ergebnisse sowohl nach semantischer Relevanz als auch nach spezifischen Attributen verfeinern können.
- Skalierbarkeit & Leistung: Entwickelt, um Milliarden von Vektoren zu verwalten und einen hohen Abfragedurchsatz mit geringer Latenz aufrechtzuerhalten, unerlässlich für Echtzeit-KI-Anwendungen und wachsende Datenmengen.
- Echtzeit-Updates: Unterstützt das dynamische Hinzufügen, Löschen und Ändern von Vektoren, um sicherzustellen, dass die Datenbank aktuell und reaktionsfähig auf sich entwickelnde Datenströme bleibt.
Anwendungsfälle
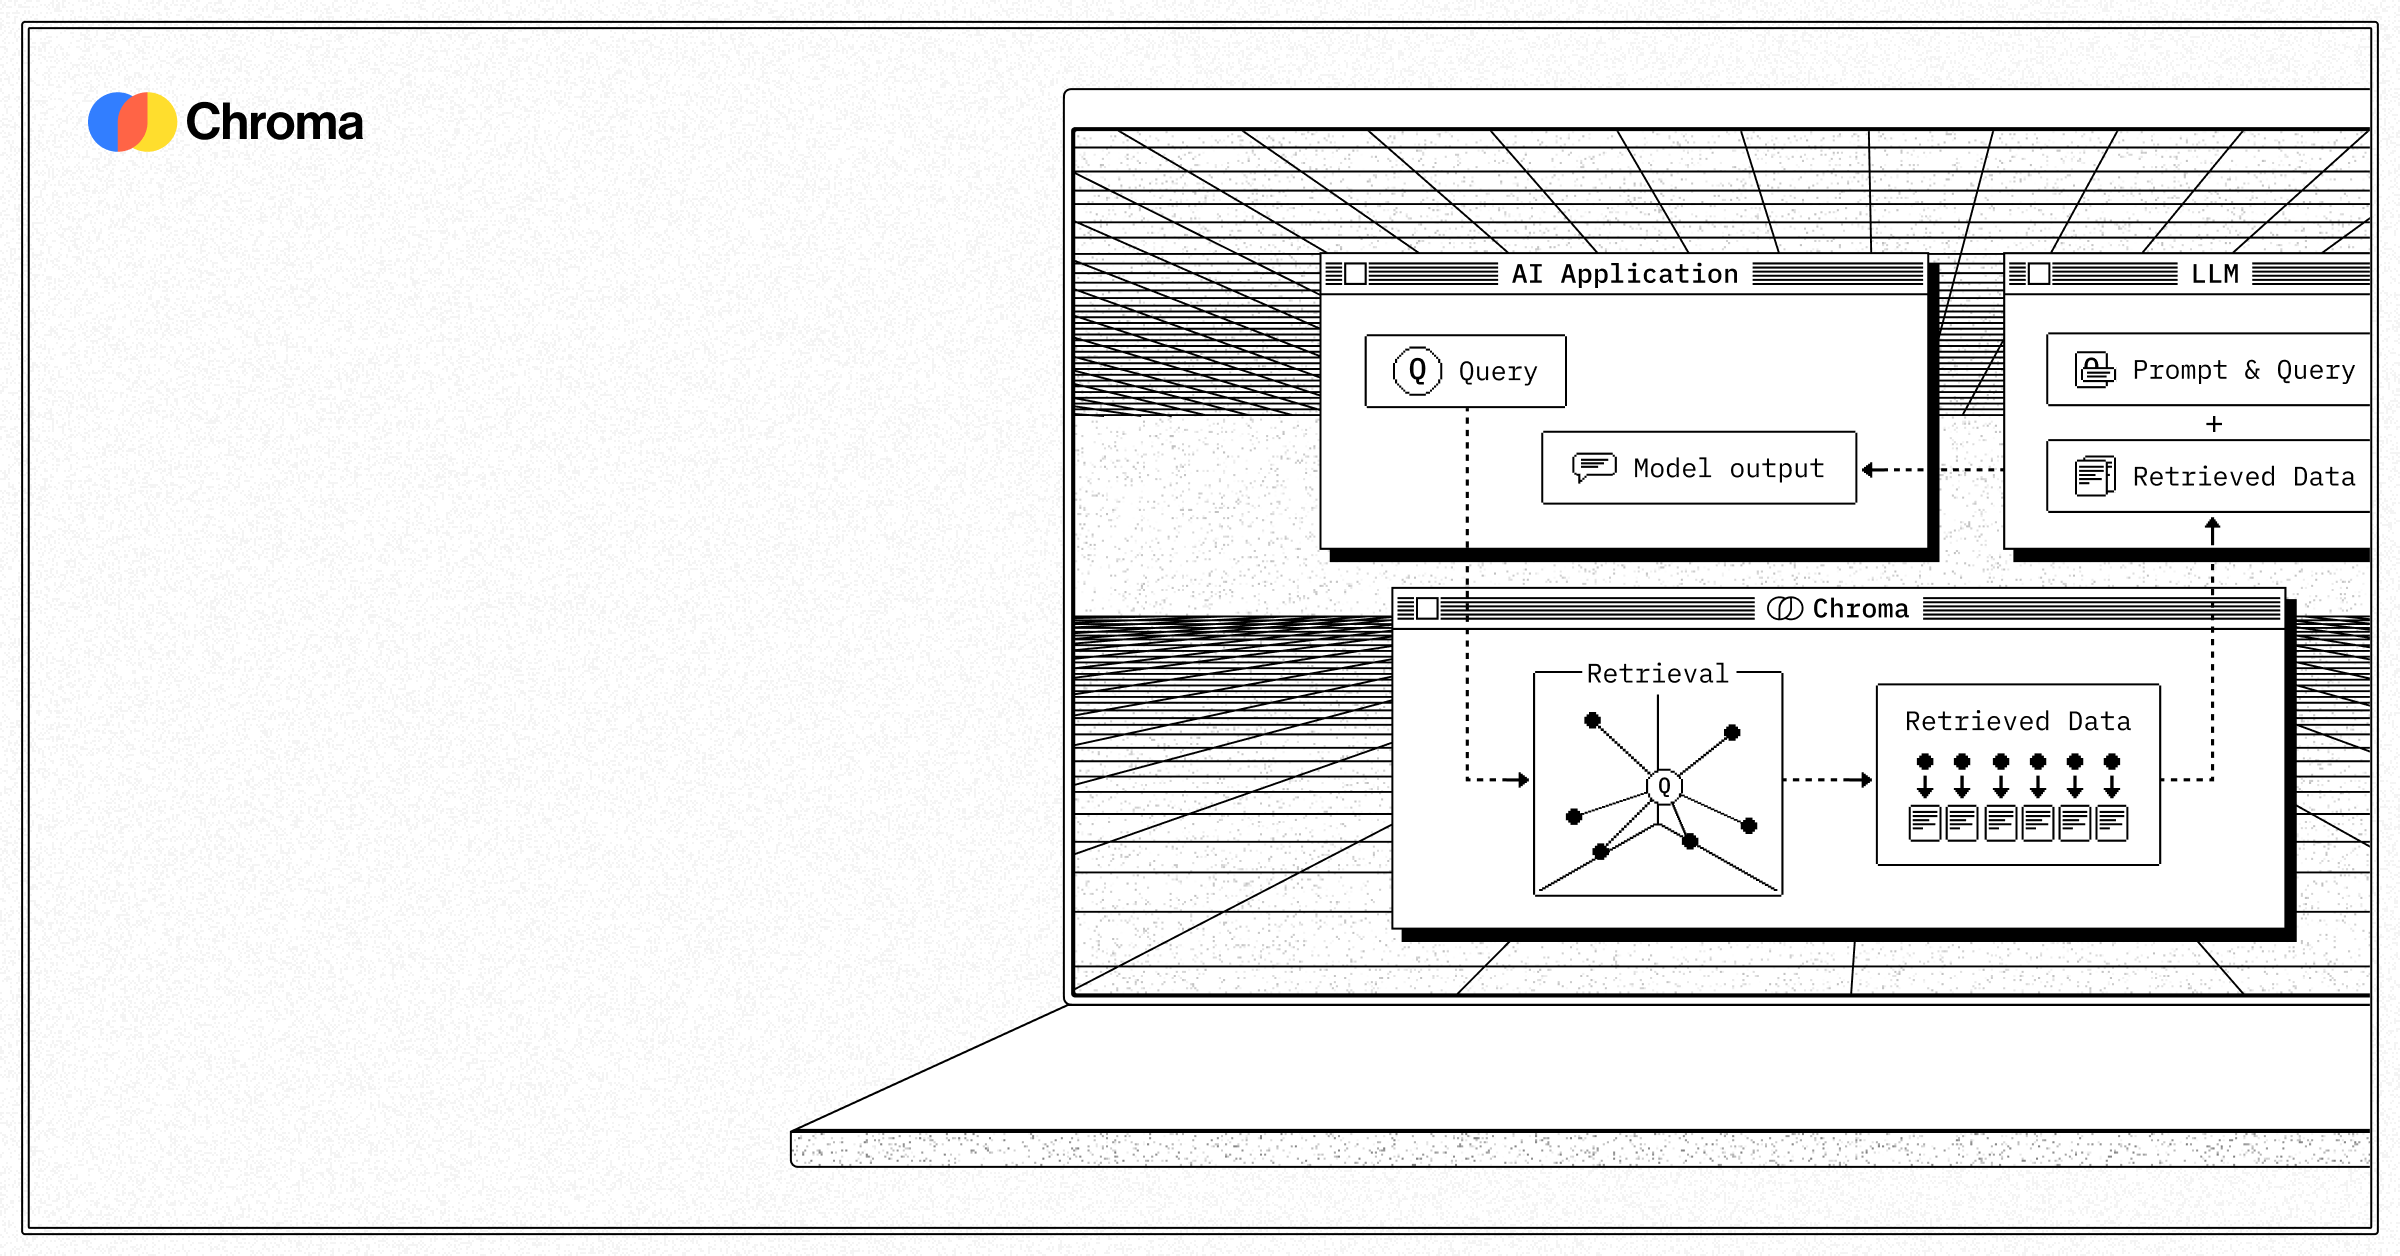
Vektordatenbanken sind unverzichtbar für Anwendungen, die ein tiefes semantisches Verständnis und kontextuelle Relevanz erfordern. Sie werden häufig beim Aufbau intelligenter Suchmaschinen eingesetzt, die über die einfache Stichwortsuche hinausgehen und es Benutzern ermöglichen, Informationen basierend auf der Bedeutung zu finden. Darüber hinaus treiben sie ausgeklügelte Empfehlungssysteme an, die hochrelevante Produkte, Inhalte oder Dienstleistungen basierend auf Benutzerpräferenzen und Artikelmerkmalen vorschlagen. Entscheidend ist, dass Vektordatenbanken zentral für Retrieval Augmented Generation (RAG)-Architekturen für große Sprachmodelle sind, die externes, aktuelles Wissen bereitstellen, um die Genauigkeit und Relevanz von KI-generierten Antworten zu verbessern. Ihre Fähigkeit, hochdimensionale Daten zu verarbeiten und zu vergleichen, macht sie zu einem Eckpfeiler für fortschrittliche KI-Funktionalitäten in verschiedenen Branchen.
Auswahlkriterien
Bei der Auswahl einer Vektordatenbank sind mehrere Schlüsselfaktoren sorgfältig zu berücksichtigen. Bewerten Sie die angebotenen Indexierungsalgorithmen (z. B. HNSW für sein Gleichgewicht aus Geschwindigkeit und Genauigkeit oder IVF_FLAT für Speichereffizienz) und stellen Sie sicher, dass sie Ihren spezifischen Leistungsanforderungen entsprechen. Bewerten Sie die Skalierbarkeit der Datenbank, um Ihr erwartetes Datenwachstum und Ihre Abfragelast zu bewältigen, sowie ihre Integrationsfähigkeiten mit Ihren vorhandenen KI/ML-Frameworks und Datenpipelines. Berücksichtigen Sie außerdem Abfrageleistungsmetriken wie Latenz und Durchsatz, erkunden Sie verfügbare Bereitstellungsoptionen (Cloud-verwaltete Dienste gegenüber selbst gehosteten Lösungen) und wägen Sie die Gesamtkosteneffizienz ab, einschließlich Lizenzierung, Betriebsaufwand und der Verfügbarkeit robuster Community-Unterstützung oder Unternehmensfunktionen.