ToolMage
Anmelden

Best 1 Multimodale Modelle AI tools for KI-Modelle

Popular Multimodale Modelle AI tools in KI-Modelle include ImageBind, helping you work more efficiently.

ImageBind
Free

ImageBind

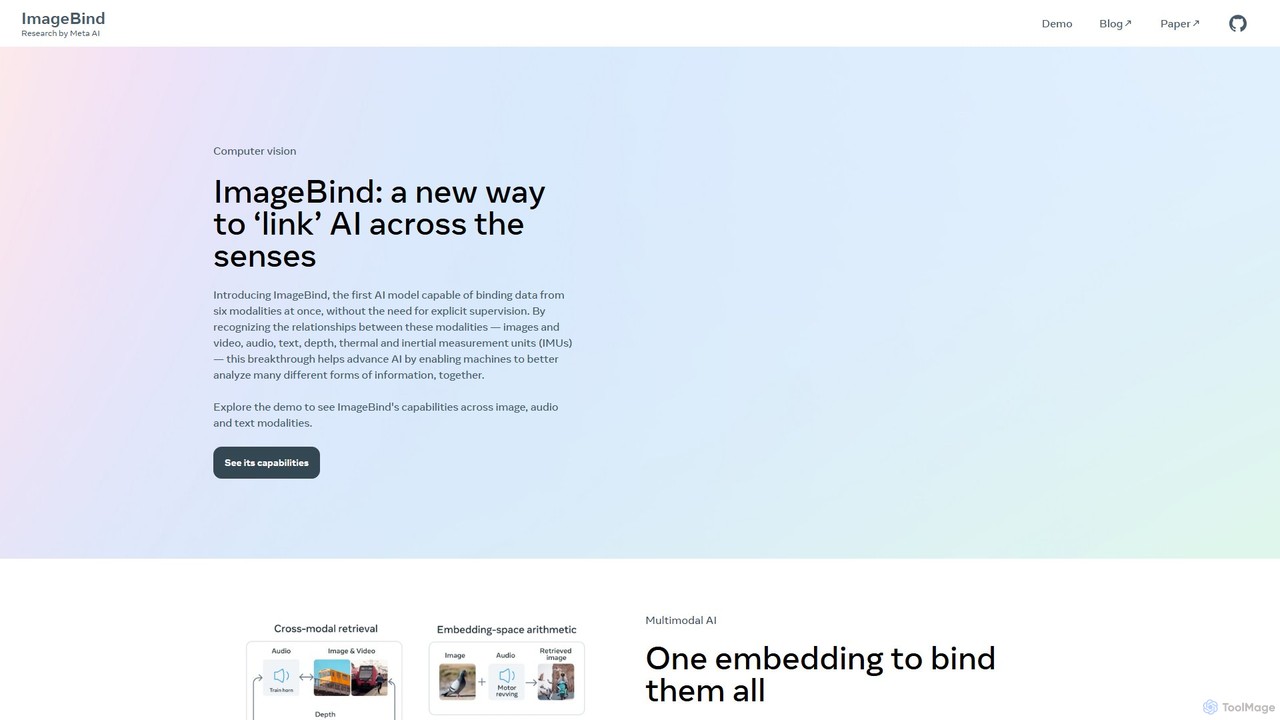
ImageBind ist ein wegweisendes KI-Modell von Meta AI, das einen einheitlichen Einbettungsraum für sechs verschiedene Datenmodalitäten schafft: Bilder, Video, Audio, Text, Tiefe und Wärme. Dieser Durchbruch ermöglicht es Maschinen, Beziehungen zwischen den Sinnen zu verstehen und erleichtert fortschrittliche crossmodale Suche, Generierung und Analyse ohne explizite Überwachung. Es ist ein Open-Source-Modell, das die Grenzen der multimodalen KI erweitern soll.

Multimodale Modelle
Visits 9.3KFavorites 145Likes 158

About Multimodale Modelle

Multimodale Modelle sind eine Klasse von KI-Modellen, die darauf ausgelegt sind, Informationen aus mehreren Datenmodalitäten gleichzeitig zu verarbeiten und zu verstehen. Diese Modelle integrieren Eingaben wie Text, Bilder, Audio und Video, was ein ganzheitlicheres Verständnis komplexer realer Szenarien ermöglicht. Sie zeichnen sich durch Aufgaben aus, die ein übermodales Denken erfordern, wie das Generieren von Bildunterschriften aus visuellen Inhalten oder das Beantworten von Fragen zu Videos. Diese Fähigkeit ermöglicht nuanciertere und kontextreichere KI-Anwendungen im Vergleich zu unimodalen Systemen.

Kernfunktionen

  • Übermodales Verständnis: Integriert und interpretiert Daten aus verschiedenen Quellen (Text, Bild, Audio), um eine einheitliche Darstellung zu bilden.
  • Multimodale Generierung: Erstellt neue Inhalte durch die Kombination von Informationen über Modalitäten hinweg, z. B. das Generieren von Videos aus Text und Audio.
  • Kontextuelles Denken: Leitet tiefere Bedeutungen und Beziehungen ab, indem Interaktionen zwischen verschiedenen Datentypen analysiert werden.
  • Einheitliches Repräsentationslernen: Lernt gemeinsame Einbettungen, die semantische Beziehungen über verschiedene Modalitäten hinweg erfassen.

Anwendungsfälle

Multimodale Modelle werden in fortgeschrittenen KI-Assistenten, intelligenter Inhaltserstellung, verbesserten Suchmaschinen und komplexer Datenanalyse in verschiedenen Branchen eingesetzt. Sie sind entscheidend für Aufgaben, bei denen das Verständnis des Zusammenspiels zwischen verschiedenen Datenformen unerlässlich ist.

Auswahlkriterien

Bei der Auswahl eines multimodalen Modells sollten die unterstützten spezifischen Modalitäten, die Integrationskomplexität mit bestehenden Systemen, die Leistung und Genauigkeit für Ihre Zielaufgaben sowie die damit verbundenen Skalierbarkeits- und Kostenimplikationen berücksichtigt werden. Bewerten Sie die Fähigkeit des Modells, Ihre spezifischen Datentypen zu verarbeiten, und seine nachgewiesene Erfolgsbilanz in ähnlichen Anwendungen.

Multimodale Modelle use cases

1

Automatische Untertitel für Bilder und Videos generieren

Content-Ersteller und Social-Media-Manager können multimodale Modelle nutzen, um automatisch beschreibende und ansprechende Untertitel für visuelle Inhalte zu generieren. Durch die Analyse von Bild-/Video-Frames und begleitendem Audio liefert das Modell kontextuell relevanten Text, was die Vorbereitungszeit für Inhalte erheblich verkürzt und die Zugänglichkeit für verschiedene Zielgruppen verbessert. Dies optimiert den Veröffentlichungsworkflow und erhöht die Auffindbarkeit von Inhalten.

2

Suche mit multimodalen Abfragen verbessern

E-Commerce-Plattformen und digitale Asset-Management-Systeme können multimodale Modelle nutzen, um Benutzern die Suche nach Artikeln mittels einer Kombination aus Textbeschreibungen, Bild-Uploads oder sogar Sprachbefehlen zu ermöglichen. Dies führt zu präziseren und intuitiveren Suchergebnissen, die Benutzern helfen, Produkte oder Assets zu finden, die komplexen Kriterien jenseits einfacher Keyword-Übereinstimmungen entsprechen, wodurch die Benutzerzufriedenheit und Konversionsraten erheblich verbessert werden.

3

Natürlichere und interaktivere KI-Assistenten entwickeln

Entwickler, die virtuelle Assistenten oder Kundendienst-Bots erstellen, können multimodale Funktionen integrieren, um menschlichere Interaktionen zu ermöglichen. Der Assistent kann gesprochene Sprache verstehen, Gesichtsausdrücke oder Gesten aus Videos analysieren und mit passendem Text, Audio oder sogar visuellen Hinweisen antworten, was zu einer reichhaltigeren, empathischeren und hochwirksamen Benutzererfahrung in verschiedenen Service- und Supportkontexten führt.

4

Medizinische Diagnose durch integrierte Datenanalyse unterstützen

Medizinisches Fachpersonal kann multimodale Modelle nutzen, um medizinische Bilder (z. B. Röntgenbilder, MRTs) in Verbindung mit klinischen Notizen, Laborergebnissen und Genomdaten von Patienten zu analysieren. Dieser integrierte Ansatz hilft bei der Identifizierung subtiler Muster, der Vorhersage des Krankheitsverlaufs und der Bereitstellung umfassenderer Diagnoseunterstützung, was potenziell zu früheren und genaueren Interventionen sowie personalisierten Behandlungsplänen für Patienten führt.

5

Verbesserung der Umfeldwahrnehmung für autonome Fahrzeuge

Im autonomen Fahren sind multimodale Modelle entscheidend für die Fusion von Daten verschiedener Sensoren wie Kameras, LiDAR und Radar. Durch die Kombination visueller Informationen mit Tiefendaten und Entfernungsmessungen schaffen diese Modelle ein robustes Verständnis der Fahrzeugumgebung, was eine sicherere Navigation, präzise Objekterkennung und genaue Vorhersage des Verhaltens anderer Verkehrsteilnehmer ermöglicht, was für die Sicherheit unerlässlich ist.

6

Adaptive und personalisierte Bildungsinhalte erstellen

Bildungstechnologieplattformen können multimodale Modelle einsetzen, um den Lernstil, das Engagement (über Video/Audio) und die Leistung eines Schülers bei textbasierten Aufgaben zu analysieren. Das Modell kann dann das Lehrmaterial anpassen, Informationen in bevorzugten Modalitäten (z. B. visuelle Erklärungen für visuelle Lerner) präsentieren und personalisiertes Feedback geben, wodurch die Lernerfahrung optimiert und die Bildungsergebnisse für einzelne Schüler verbessert werden.

Multimodale Modelle FAQ

Was sind multimodale Modelle?

Multimodale Modelle sind fortschrittliche KI-Systeme, die in der Lage sind, Informationen aus mehreren unterschiedlichen Datentypen oder „Modalitäten“ gleichzeitig zu verarbeiten und zu integrieren. Im Gegensatz zu traditionellen KI-Modellen, die sich auf einen Datentyp (wie Text oder Bilder) spezialisieren, können multimodale Modelle Inhalte über Modalitäten wie Text, Bilder, Audio und Video hinweg verstehen und generieren. Dies ermöglicht es ihnen, komplexe Kontexte zu erfassen und Aufgaben zu lösen, die übermodales Denken erfordern, was zu umfassenderen und menschenähnlicheren KI-Fähigkeiten führt.

Wie unterscheiden sich multimodale Modelle von traditionellen KI-Modellen?

Der Hauptunterschied liegt in ihrer Fähigkeit, diverse Dateneingaben zu verarbeiten. Traditionelle KI-Modelle, oft als unimodale Modelle bezeichnet, werden typischerweise für einen einzelnen Datentyp trainiert und optimiert, wie ein großes Sprachmodell (LLM) für Text oder ein Convolutional Neural Network (CNN) für Bilder. Multimodale Modelle hingegen sind darauf ausgelegt, vereinheitlichte Repräsentationen aus mehreren Modalitäten zu lernen, wodurch sie die Beziehungen und Interaktionen zwischen verschiedenen Datentypen verstehen können. Dies ermöglicht robustere und vielseitigere Anwendungen, die menschliche Wahrnehmung und Kognition nachahmen.

Was sind die wichtigsten Anwendungen multimodaler Modelle?

Multimodale Modelle haben ein breites Anwendungsspektrum in verschiedenen Branchen. Zu den wichtigsten Anwendungen gehören das Generieren beschreibender Bild- und Videountertitel, die Verbesserung von Suchmaschinen durch kombinierte Text- und visuelle Abfragen, die Bereitstellung natürlicherer und interaktiverer KI-Assistenten, die Unterstützung der medizinischen Diagnose durch die Integration von Bild- und klinischen Daten sowie die Verbesserung der Umfeldwahrnehmung in autonomen Systemen. Sie sind auch entscheidend für personalisierte Inhaltsempfehlungen und fortschrittliche Robotik, wo das Verständnis vielfältiger sensorischer Eingaben unerlässlich ist.

Welche Herausforderungen sind mit der Entwicklung und dem Einsatz multimodaler Modelle verbunden?

Die Entwicklung und der Einsatz multimodaler Modelle bringen mehrere Herausforderungen mit sich. Eine wesentliche Hürde ist die Datenerfassung und -ausrichtung, da dies große, vielfältige Datensätze erfordert, bei denen verschiedene Modalitäten genau synchronisiert und beschriftet sind. Eine weitere Herausforderung besteht darin, effektive Architekturen zu entwerfen, die Informationen aus unterschiedlichen Datentypen effizient fusionieren können, während die Rechenbarkeit erhalten bleibt. Darüber hinaus sind die Sicherstellung einer robusten Leistung über alle Modalitäten hinweg und die Minderung potenzieller Verzerrungen in einzelnen Datensätzen komplexe Aufgaben, die sorgfältige Überlegung und fortgeschrittene Forschung erfordern.

Wie wähle ich das richtige multimodale Modell für mein Projekt aus?

Die Auswahl des geeigneten multimodalen Modells erfordert die Bewertung mehrerer Faktoren. Identifizieren Sie zunächst die spezifischen Modalitäten, die Ihr Projekt verarbeiten muss (z. B. Text-zu-Bild, Video-zu-Text). Bewerten Sie zweitens die für Ihre Aufgabe relevanten Leistungsmetriken des Modells, wie die Genauigkeit bei der übermodalen Abfrage oder die Generierungsqualität. Berücksichtigen Sie drittens die für Training und Inferenz erforderlichen Rechenressourcen, da diese Modelle ressourcenintensiv sein können. Bewerten Sie schließlich die einfache Integration in Ihre bestehende Infrastruktur, verfügbare APIs und die Lizenz- oder Kostenstruktur des Modells, um sicherzustellen, dass es mit dem Budget und den technischen Fähigkeiten Ihres Projekts übereinstimmt.