ToolMage
Anmelden

Best 3 Audioverarbeitung AI tools

Popular Audioverarbeitung AI tools include TranslateMom, LipSync Studio und Bsub, helping you work more efficiently.

Bsub
Paid

Bsub

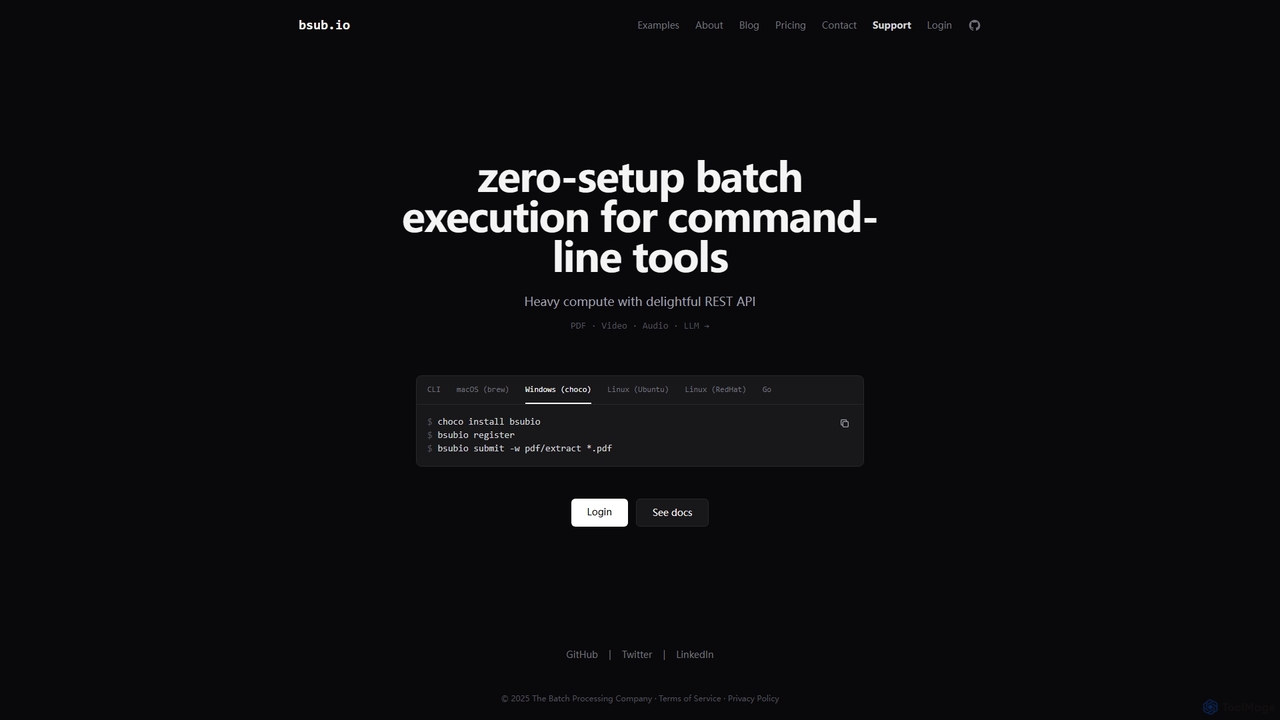
Bsub ist eine Zero-Setup-Batch-Verarbeitungsplattform, die für Entwickler entwickelt wurde, um Befehlszeilentools in großem Maßstab auszuführen. Sie vereinfacht rechenintensive Aufgaben wie PDF-Extraktion, Videotranskodierung, Audio-Transkription und Large Language Model (LLM) Batch-Inferenz über eine einfache REST-API, wodurch Infrastrukturmanagement und Skalierungsbedenken entfallen.

Transkription
Visits 8.6KFavorites 123Likes 138
TranslateMom
Paid

TranslateMom

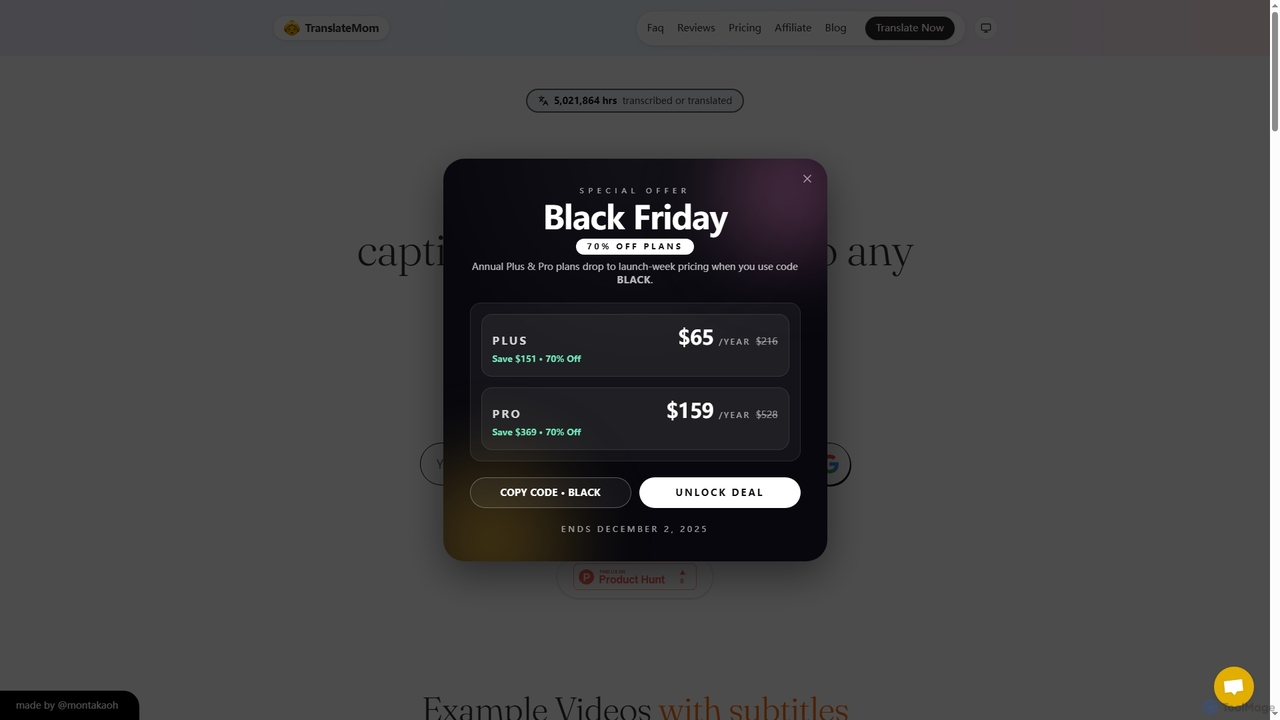
TranslateMom ist ein KI-gestütztes Tool für Videoübersetzung, Synchronisation und Untertitelung, das Content-Erstellern, Marketern und Pädagogen hilft, ein globales Publikum zu erreichen. Es unterstützt über 100 Sprachen für Untertitel und Übersetzungen sowie 29 Sprachen für KI-Synchronisation, wodurch die Videolokalisierung schnell und effizient wird.

3D
Visits 130.1KFavorites 133Likes 156
LipSync Studio
Paid

LipSync Studio

LipSync Studio ist ein fortschrittliches KI-Tool zur Erstellung professioneller Lippensynchronisationsanimationen und Charakter-Lippensynchronisationsvideos. Es unterstützt mehrsprachige Synchronisation in über 100 Sprachen, natürliche Sprach- oder Gesangssynchronisation und Multi-Charakter-Animationen für Menschen, Cartoons und Tiere. Produzieren Sie hochwertige Inhalte für Anzeigen, Trailer, Erklärvideos und Musikvideos ohne traditionelle Studiokosten.

3D
Visits 120.9KFavorites 138Likes 133

About Audioverarbeitung

KI-Audioverarbeitungstools sind eine Klasse von Software, die künstliche Intelligenz nutzt, um Audioinhalte zu analysieren, zu modifizieren und zu generieren. Diese Tools verwenden fortschrittliche maschinelle Lernmodelle, einschließlich Spracherkennung und Signalverarbeitung, um komplexe Aufgaben zu automatisieren, die traditionell manuellen Aufwand und Fachwissen erforderten. Sie sind darauf ausgelegt, die Audioqualität zu verbessern, wertvolle Erkenntnisse aus Sprache zu extrahieren, realistische synthetische Stimmen zu erzeugen und sogar Originalmusik zu komponieren. Diese Technologie bietet Content-Erstellern, Musikern, Entwicklern und Unternehmen leistungsstarke Möglichkeiten, um Arbeitsabläufe zu optimieren und neue kreative Potenziale zu erschließen.

Kernfunktionen

  • Sprach-zu-Text-Transkription: Wandelt gesprochene Sprache aus Audio- oder Videodateien präzise in geschriebenen Text um, oft mit Sprecheridentifikation.
  • Rauschunterdrückung & -verbesserung: Erkennt und entfernt intelligent unerwünschte Hintergrundgeräusche wie Rauschen, Brummen oder Gerede und verbessert die Sprachverständlichkeit.
  • Stimmsynthese & -klonung: Erzeugt menschenähnliche Sprache aus Text (Text-to-Speech) oder erstellt eine digitale Nachbildung der Stimme einer bestimmten Person.
  • Audio-Separation (Stem Splitting): Isoliert einzelne Elemente aus einer gemischten Audiospur, z. B. die Trennung von Gesang und Instrumentalteilen.
  • Musikgenerierung: Komponiert lizenzfreie Musiktitel basierend auf Benutzereingaben zu Genre, Stimmung oder Instrumentierung.

Anwendungsfälle

Diese Tools werden häufig in der Medienproduktion eingesetzt, wo Podcaster und Videoeditoren sie zur Bereinigung von Aufnahmen und zur Erstellung von Voice-Overs verwenden. In der Wirtschaft werden sie zur Transkription von Besprechungen und zur Analyse von Kundendienstanrufen zur Qualitätssicherung genutzt. Musiker und Produzenten nutzen die Audio-Separation für Remixes und Sampling, während Entwickler Sprachsynthese und -erkennung in Anwendungen und Dienste integrieren.

Wie man wählt

Bei der Auswahl eines KI-Audioverarbeitungstools identifizieren Sie zunächst Ihren primären Bedarf – sei es Transkription, Rauschunterdrückung oder Stimmerzeugung. Bewerten Sie die Genauigkeit des Tools und die Qualität seiner Ausgabe, da diese erheblich variieren kann. Berücksichtigen Sie die Benutzerfreundlichkeit und ob eine API zur Integration in Ihre bestehenden Arbeitsabläufe angeboten wird. Vergleichen Sie schließlich Preismodelle wie Abonnements oder nutzungsbasierte Abrechnung, um eine Lösung zu finden, die zu Ihrem Budget und Ihrer Nutzungshäufigkeit passt.

Audioverarbeitung use cases

1

Verbesserung der Podcast-Audioqualität

Ein Podcast-Ersteller nimmt ein Interview an einem Ort mit deutlich hörbarem Hintergrundbrummen auf. Anstatt Stunden mit manueller Bearbeitung zu verbringen, lädt er die Audiodatei in ein KI-Tool hoch. Das Tool erkennt und entfernt automatisch das Brummen, gleicht die Lautstärkepegel zwischen dem Moderator und dem Gast an und entfernt sogar lange Pausen und Füllwörter wie „äh“ und „ähm“. Das Ergebnis ist eine saubere, professionell klingende Episode, die in einem Bruchteil der Zeit produziert wird, sodass sich der Ersteller auf den Inhalt statt auf die technische Bearbeitung konzentrieren kann.

2

Automatisierung von Meeting-Transkriptionen und -Zusammenfassungen

Ein Projektmanager muss ein wichtiges Kundengespräch dokumentieren. Er nutzt einen KI-Transkriptionsdienst, der den Anruf aufzeichnet. Unmittelbar nach dem Meeting liefert das Tool ein vollständiges, nach Sprechern geordnetes Transkript. Darüber hinaus erstellen seine KI-Fähigkeiten eine prägnante Zusammenfassung, die wichtige Entscheidungen, Aktionspunkte und besprochene Fristen hervorhebt. Dieses automatisierte Protokoll wird dann mit dem Team geteilt, um sicherzustellen, dass alle auf dem gleichen Stand sind, und erspart dem Manager Stunden manueller Notizen und Zusammenfassungen.

3

Erstellung von Remixen mit KI-Stem-Separation

Ein Musikproduzent möchte einen Remix eines beliebten Songs erstellen, hat aber keinen Zugriff auf die ursprüngliche Mehrspuraufnahme. Er verwendet ein KI-Tool zur Stem-Separation, um die endgültige Songdatei hochzuladen. Die KI analysiert den Track und teilt ihn in hochwertige einzelne Stems auf: Gesang, Schlagzeug, Bass und andere Instrumente. Der Produzent kann nun die A-cappella-Version isolieren, um sie über einen neuen Beat zu legen, oder den Instrumentalteil als Begleitspur verwenden, was kreative Möglichkeiten eröffnet, die bisher nur in professionellen Studios möglich waren.

4

Erstellung realistischer Voice-Overs für Videos

Ein Marketingteam muss ein Produktdemovideo für ein globales Publikum erstellen. Anstatt mehrere Synchronsprecher für verschiedene Sprachen zu engagieren, verwenden sie ein KI-Text-zu-Sprache-Tool (TTS). Sie geben das übersetzte Skript ein, wählen ein Stimmprofil, das zu ihrer Marke passt (z. B. professionell, energisch), und passen Tempo und Betonung an. Das Tool generiert in wenigen Minuten ein natürlich klingendes Voice-Over. Sie können sogar Stimmklonung verwenden, um die Stimme ihres Haupt-Markensprechers in allen Sprachen beizubehalten, was Konsistenz gewährleistet und die Produktionskosten und -zeiten drastisch reduziert.

5

Analyse von Kundendienstanrufen zur Gewinnung von Erkenntnissen

Ein Qualitätssicherungsmanager in einem Callcenter möchte häufige Kundenprobleme und die Leistung der Mitarbeiter verstehen. Er verwendet ein KI-Audioverarbeitungstool, um Tausende von aufgezeichneten Anrufen zu transkribieren und zu analysieren. Die KI erkennt automatisch die Stimmung des Kunden (z. B. frustriert, zufrieden), identifiziert Schlüsselwörter im Zusammenhang mit Produktbeschwerden und misst die Einhaltung von Skripten durch die Mitarbeiter. Dies liefert handlungsorientierte Daten zur Verbesserung von Schulungen, zur Aktualisierung von Support-Dokumentationen und zur Behebung wiederkehrender Produktprobleme, ohne Hunderte von Stunden an Anrufen manuell anhören zu müssen.

6

Generierung von lizenzfreier Hintergrundmusik

Ein YouTuber benötigt einzigartige Hintergrundmusik für seine wöchentlichen Videos, möchte aber Urheberrechtsverwarnungen und teure Lizenzgebühren vermeiden. Er verwendet einen KI-Musikgenerator und gibt das gewünschte Genre (z. B. „Lo-Fi-Hip-Hop“), die Stimmung („entspannt“) und die Dauer (3 Minuten) an. Die KI komponiert einen völlig neuen, lizenzfreien Track, der perfekt zur Atmosphäre des Videos passt. Dies ermöglicht es dem Ersteller, einen konsistenten und originellen Soundtrack für seinen Kanal zu haben, was den Produktionswert erhöht, ohne dass musikalisches Wissen oder ein Budget für individuelle Kompositionen erforderlich ist.

Audioverarbeitung FAQ

Was sind KI-Audioverarbeitungstools?

KI-Audioverarbeitungstools sind Softwareanwendungen, die künstliche Intelligenz verwenden, um fortgeschrittene Aufgaben mit Audiodaten durchzuführen. Im Gegensatz zu herkömmlichen Editoren automatisieren sie Prozesse wie die Transkription von Sprache in Text, die Entfernung komplexer Hintergrundgeräusche, die Trennung von Musikinstrumenten aus einem Lied oder die Erzeugung völlig neuer Audioinhalte wie Voice-Overs und Musik. Ihr Hauptziel ist es, komplexe Audiobearbeitung für eine breite Palette von Benutzern zugänglich, schnell und effizient zu machen.

Wie wähle ich das richtige KI-Audioverarbeitungstool aus?

Um das richtige Tool auszuwählen, berücksichtigen Sie diese Faktoren:

  • Hauptfunktion: Identifizieren Sie Ihre Hauptaufgabe. Benötigen Sie Transkription, Rauschunterdrückung, Stimmklonung oder Musikgenerierung? Verschiedene Tools sind auf unterschiedliche Bereiche spezialisiert.
  • Genauigkeit und Qualität: Suchen Sie nach Beispielen oder nutzen Sie eine kostenlose Testversion, um die Ausgabe zu bewerten. Bei der Transkription überprüfen Sie die Wortfehlerrate. Bei der Audioverbesserung achten Sie auf Artefakte.
  • Benutzerfreundlichkeit: Wählen Sie ein Tool mit einer Benutzeroberfläche, die Ihrem technischen Kenntnisstand entspricht. Einige sind einfache webbasierte Uploader, während andere komplexe Plugins oder APIs sind.
  • Preismodell: Vergleichen Sie die Kosten. Einige berechnen pro Audiominute, andere haben monatliche Abonnements. Wählen Sie ein Modell, das Ihrer erwarteten Nutzung und Ihrem Budget entspricht.
Was ist der Unterschied zwischen KI-Audioverarbeitung und traditionellen Audio-Editoren?

Traditionelle Audio-Editoren (wie Adobe Audition oder Audacity) bieten ein manuelles Toolkit zur Klangbearbeitung. Benutzer benötigen technische Fähigkeiten, um Aufgaben wie Rauschunterdrückung oder Stimmenkorrektur durchzuführen. KI-Audioverarbeitungstools hingegen automatisieren diese komplexen Aufgaben. Anstatt Atemgeräusche manuell zu finden und zu schneiden, kann ein KI-Tool dies mit einem Klick erledigen. Darüber hinaus ermöglicht KI generative Fähigkeiten – wie die Erstellung einer Stimme aus Text oder das Komponieren von Musik – die grundsätzlich außerhalb des Rahmens traditioneller Editoren liegen.

Was sind die Hauptfunktionen von KI-Audioverarbeitungstools?

Die Hauptfunktionen drehen sich um Analyse, Verbesserung und Generierung. Wichtige Beispiele sind:

  • Sprache-zu-Text: Umwandlung von gesprochenen Wörtern in Text für Untertitel, Notizen oder Analysen.
  • Rauschunterdrückung: Bereinigung von Audio durch Entfernen unerwünschter Geräusche wie Wind, Brummen oder Klicks.
  • Text-zu-Sprache (TTS): Synthese künstlicher Stimmen aus geschriebenem Text für Voice-Overs oder Barrierefreiheit.
  • Stem-Separation: Zerlegung eines Songs in seine Bestandteile (Gesang, Bass, Schlagzeug).
  • Stimmklonung: Erstellung eines digitalen Modells einer bestimmten Stimme, um neue Sprache in dieser Stimme zu erzeugen.
Wer kann von der Nutzung von KI-Audioverarbeitungstools profitieren?

Eine breite Palette von Fachleuten und Kreativen kann davon profitieren. Content-Ersteller (Podcaster, YouTuber) nutzen sie zur Verbesserung der Produktionsqualität. Musiker und Produzenten setzen sie für kreative Aufgaben wie Sampling und Remixing ein. Unternehmen verwenden sie zur Transkription von Besprechungen und zur Analyse von Kundeninteraktionen. Entwickler integrieren ihre APIs, um sprachgesteuerte Anwendungen zu erstellen. Schließlich nutzen Studenten und Forscher sie zur Transkription von Vorlesungen und zur Analyse von Audiodaten für ihre Arbeit.