ToolMage
Anmelden

Best 1 Audioinhalte AI tools for Content-Erstellung

Popular Audioinhalte AI tools in Content-Erstellung include PodcastShodcast, helping you work more efficiently.

PodcastShodcast
Freemium

PodcastShodcast

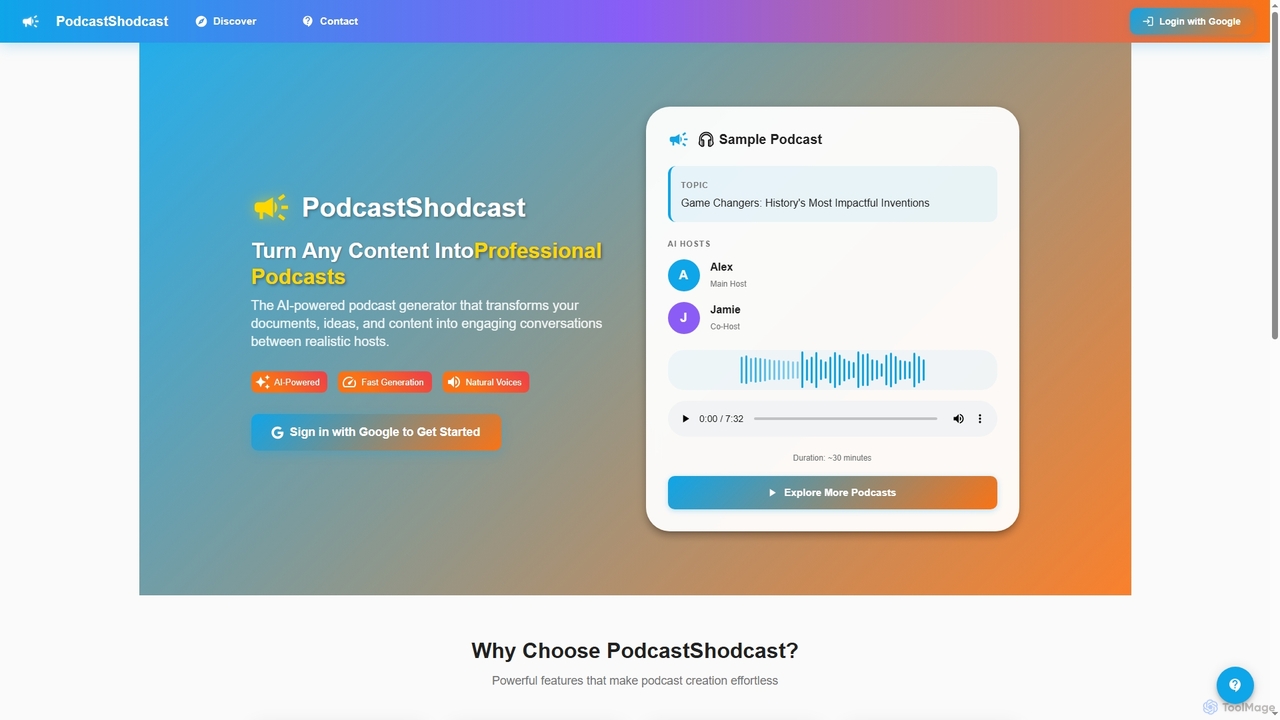
PodcastShodcast ist ein KI-gestützter Podcast-Generator, der verschiedene Inhalte wie Dokumente, Texte und URLs in professionelle, ansprechende Audiogespräche mit realistischen KI-Moderatoren umwandelt. Er bietet schnelle Generierung und natürliche Sprachsynthese für vielfältige Anwendungen.

3D
Visits 7.2KFavorites 163Likes 151

About Audioinhalte

KI-Audioinhalte-Tools sind eine Klasse von Software, die künstliche Intelligenz zur Erzeugung, Bearbeitung und Verbesserung von Audioinhalten einsetzt. Diese Tools verwenden fortschrittliche Modelle wie Text-to-Speech (TTS), Stimmklonen und generative Audiosynthese, um aus einfachen Textaufforderungen oder Dateneingaben realistische menschliche Sprache, originelle Musik und Soundeffekte zu erstellen. Sie ermöglichen es Kreativen, hochwertige Audioinhalte für Podcasts, Videos und Anwendungen zu produzieren, ohne teure Aufnahmestudios oder professionelle Sprecher zu benötigen. Viele Plattformen enthalten auch Funktionen zur Audio-Bereinigung, wie Rauschunterdrückung und Dialogverbesserung, was die professionelle Audioproduktion zugänglicher und effizienter macht.

Kernfunktionen

  • Text-to-Speech (TTS)-Generierung: Wandelt geschriebenen Text in natürlich klingende menschliche Sprache in verschiedenen Sprachen, Akzenten und emotionalen Stilen um.
  • Stimmklonen: Erstellt eine digitale Nachbildung einer bestimmten Stimme aus einer kurzen Audioprobe, was die Generierung neuer Sprache in dieser Stimme ermöglicht.
  • KI-Musik- & Sound-Generierung: Komponiert lizenzfreie Hintergrundmusik, Jingles oder Soundeffekte basierend auf Genre, Stimmung oder beschreibenden Anweisungen.
  • Audioverbesserung & -wiederherstellung: Entfernt automatisch Hintergrundgeräusche, korrigiert Lautstärkepegel und repariert Mängel in bestehenden Audioaufnahmen.
  • Speech-to-Speech (STS)-Konvertierung: Transformiert die Eigenschaften einer Stimme (z. B. Emotion, Akzent) in eine andere, während der ursprüngliche Sprachinhalt erhalten bleibt.

Anwendungsfälle

Diese Tools werden häufig von Podcastern zur Erstellung von Intros und zur Bearbeitung von Interviews, von Videoproduzenten zum Hinzufügen von Voice-Overs und Hintergrundmusik und von Entwicklern zur Integration dynamischer Sprachantworten in Anwendungen verwendet. E-Learning-Profis nutzen sie zur Erstellung von Kurs-Narrationen, während Marketer Audio-Anzeigen und Markenstimmen für virtuelle Assistenten erstellen.

Wie man wählt

Bei der Auswahl eines KI-Audioinhalte-Tools sollten Sie die Qualität und Natürlichkeit der erzeugten Stimmen oder Musik berücksichtigen. Bewerten Sie die Auswahl an verfügbaren Sprachen, Akzenten und Anpassungsoptionen (z. B. Tonhöhe, Geschwindigkeit, Emotion). Für Entwickler sind die Verfügbarkeit einer API und die Dokumentation entscheidend. Überprüfen Sie auch die Preismodelle (z. B. pro Zeichen, Abonnement) und die Nutzungsrechte für kommerzielle Projekte, um sicherzustellen, dass sie Ihren Anforderungen entsprechen.

Audioinhalte use cases

1

Automatisierte Hörbuch- und Artikel-Narration

Content-Publisher und Blogger können KI-Audio-Tools verwenden, um ihre geschriebenen Werke wie Bücher, Artikel und Newsletter in ansprechende Audioformate umzuwandeln. Durch einfache Eingabe des Textes erzeugt eine Text-to-Speech (TTS)-Engine eine hochwertige Narration in einer gewählten Stimme und Sprache. Dieser Prozess automatisiert die Erstellung von Hörbüchern und „Diesen Artikel anhören“-Funktionen und macht Inhalte für sehbehinderte Zielgruppen und diejenigen, die Inhalte unterwegs konsumieren möchten, zugänglicher. Es reduziert die Kosten und die Zeit im Vergleich zur Beauftragung eines professionellen Sprechers und der Buchung eines Aufnahmestudios erheblich.

2

Podcast-Produktion und Audioverbesserung

Podcaster können KI-Audio-Tools in ihrem gesamten Produktionsworkflow nutzen. Ein KI-Musikgenerator kann einzigartige, lizenzfreie Intro- und Outro-Musik erstellen, die auf das Thema des Podcasts zugeschnitten ist. Während der Bearbeitung können KI-gestützte Audioverbesserungsfunktionen automatisch Hintergrundgeräusche entfernen, die Lautstärke zwischen verschiedenen Sprechern ausgleichen und Füllwörter wie „äh“ und „ähm“ herausschneiden. Für Kreative, die kamerascheu sind oder anonym bleiben möchten, kann eine realistische KI-Stimme zur Erzählung ganzer Episoden verwendet werden, um einen konsistenten und professionellen Klang zu gewährleisten, ohne jemals vor ein Mikrofon treten zu müssen.

3

Mehrsprachige Video-Synchronisation und Voice-Overs

Videoproduzenten, die ein globales Publikum ansprechen, können KI-Audio-Tools verwenden, um ihre Inhalte schnell und kostengünstig in mehrere Sprachen zu synchronisieren. Anstatt für jede Sprache Synchronsprecher zu engagieren, können sie ein Text-to-Speech-Tool verwenden, das verschiedene Sprachen unterstützt. Der Prozess umfasst die Transkription des Original-Audios, die Übersetzung des Skripts und die anschließende Generierung eines neuen Voice-Overs in der Zielsprache. Einige fortschrittliche Tools bieten sogar Stimmklonen und Speech-to-Speech-Funktionen, um den Ton und die Kadenz des ursprünglichen Sprechers zu erhalten, was zu einer natürlicheren und authentischeren Synchronisation führt, die bei internationalen Zuschauern besser ankommt.

4

Erstellung einer einzigartigen Markenstimme für das Marketing

Marketingteams können KI-Stimmklonen verwenden, um eine konsistente und wiedererkennbare Audio-Markenidentität zu etablieren. Durch das Klonen der Stimme eines CEOs, eines Markenbotschafters oder eines professionell ausgewählten Sprechers kann ein Unternehmen eine einzigartige „Markenstimme“ schaffen. Diese KI-generierte Stimme kann dann über alle Audio-Kontaktpunkte hinweg verwendet werden, einschließlich interaktiver Sprachdialogsysteme (IVR), Videoanzeigen, Schulungsmaterialien für Unternehmen und Social-Media-Inhalte. Dies gewährleistet ein einheitliches Markenerlebnis für Kunden und eliminiert die logistischen Herausforderungen und Kosten, die mit der wiederholten Planung von Aufnahmesitzungen mit einer bestimmten Person verbunden sind.

5

Schnelles Prototyping für Game- und App-Sounddesign

Spieleentwickler und App-Designer können KI-Audio-Tools verwenden, um Sounddesigns schnell zu prototypisieren und zu iterieren. Anstatt darauf zu warten, dass Synchronsprecher ihre Zeilen liefern, können Entwickler ein Text-to-Speech-Tool verwenden, um Platzhalterdialoge für Charaktere zu generieren, was es ihnen ermöglicht, Spielmechaniken und den narrativen Fluss früh im Entwicklungszyklus zu testen. In ähnlicher Weise kann ein KI-Soundeffekt-Generator eine Vielzahl von Geräuschen (z. B. Schritte, Explosionen, Interface-Klicks) basierend auf Textbeschreibungen erstellen. Dies ermöglicht es Designern, schnell die richtige Audioästhetik für ihr Projekt zu finden, ohne große Soundbibliotheken durchsuchen oder kundenspezifische Arbeiten in Auftrag geben zu müssen.

6

Erstellung barrierefreier Inhalte für sehbehinderte Benutzer

Pädagogen, Webentwickler und Organisationen können KI-Audio-Tools verwenden, um die Barrierefreiheit zu verbessern. Durch die Umwandlung von Bildschirmtext, Website-Inhalten und Lehrmaterialien in klares, gesprochenes Audio können sie Benutzer mit Sehbehinderungen oder Leseschwächen unterstützen. KI-TTS-Stimmen können in Bildschirmleser integriert oder zur Erstellung von Audioversionen von Dokumenten und Webseiten verwendet werden. Diese Anwendung der KI-Audiotechnologie fördert die digitale Inklusion und hilft Organisationen, Barrierefreiheitsstandards wie die WCAG (Web Content Accessibility Guidelines) einzuhalten, um sicherzustellen, dass Informationen für alle zugänglich sind, unabhängig von ihren körperlichen Fähigkeiten.

Audioinhalte FAQ

Was sind KI-Audioinhalte-Tools?

KI-Audioinhalte-Tools sind Softwareanwendungen, die künstliche Intelligenz zur Erzeugung und Bearbeitung von Audio verwenden. Sie können Text in lebensechte Sprache umwandeln (Text-to-Speech), eine digitale Kopie der Stimme einer Person erstellen (Stimmklonen), Originalmusik komponieren oder verrauschte Aufnahmen bereinigen. Diese Tools machen die hochwertige Audioproduktion schneller, kostengünstiger und für Benutzer ohne spezielle Fähigkeiten oder Ausrüstung zugänglich.

Wie wählt man das richtige KI-Audio-Tool aus?

Die Wahl des richtigen Tools hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie die folgenden Faktoren:

  • Audioqualität: Hören Sie sich Beispiele an. Klingt die Stimme natürlich und nicht roboterhaft? Ist die Musik von hoher Klangtreue?
  • Funktionen: Benötigen Sie grundlegende Text-to-Speech-Funktionen oder erweiterte Funktionen wie Stimmklonen, Emotionssteuerung oder API-Zugriff?
  • Sprach- und Akzentunterstützung: Stellen Sie sicher, dass das Tool die Sprachen und regionalen Akzente unterstützt, die Sie für Ihre Zielgruppe benötigen.
  • Nutzungsrechte: Überprüfen Sie die Nutzungsbedingungen, um zu bestätigen, ob Sie das generierte Audio für kommerzielle Zwecke verwenden können.
  • Preisgestaltung: Vergleichen Sie die Preismodelle. Einige berechnen pro Zeichen/Wort, während andere monatliche Abonnements mit unterschiedlichen Nutzungsstufen anbieten.
Was ist der Unterschied zwischen KI-Stimmgeneratoren und traditionellem Text-to-Speech (TTS)?

Obwohl beide Text in Audio umwandeln, stellen KI-Stimmgeneratoren einen erheblichen Fortschritt gegenüber traditionellem TTS dar. Traditionelles TTS klingt oft roboterhaft und monoton, da es auf der Verkettung vorab aufgezeichneter Klangschnipsel beruht. Moderne KI-Stimmgeneratoren verwenden Deep Learning, um Sprache von Grund auf zu synthetisieren, was es ihnen ermöglicht, sehr naturalistische Stimmen mit realistischer Intonation, Emotion und Geschwindigkeit zu erzeugen. Sie können auch spezifische Stimmen lernen und replizieren (Stimmklonen), eine Fähigkeit, die traditionellem TTS fehlt.

Kann KI-generiertes Audio für kommerzielle Zwecke verwendet werden?

Dies hängt vollständig von den Nutzungsbedingungen des spezifischen KI-Tools ab, das Sie verwenden. Die meisten seriösen Dienste bieten kommerzielle Lizenzen an, oft als Teil ihrer kostenpflichtigen Abonnementpläne, die Ihnen das Recht einräumen, das generierte Audio in gewinnorientierten Projekten wie Werbung, Hörbüchern oder monetarisierten Videos zu verwenden. Kostenlose oder Testversionen können jedoch Einschränkungen haben. Lesen Sie die Lizenzvereinbarung immer sorgfältig durch, bevor Sie KI-generiertes Audio in einem kommerziellen Kontext verwenden, um Urheberrechtsprobleme zu vermeiden. Einige Plattformen haben möglicherweise auch spezifische Regeln bezüglich des Stimmklonens, um Missbrauch zu verhindern.

Wer kann von der Nutzung von KI-Audioinhalte-Tools profitieren?

Eine breite Palette von Fachleuten und Kreativen kann von diesen Tools profitieren. Dazu gehören:

  • Content-Ersteller: Podcaster, YouTuber und Social-Media-Influencer, die Voice-Overs, Hintergrundmusik oder Audio-Bereinigung benötigen.
  • Marketer: Zur Erstellung von Audio-Anzeigen, Markenstimmen für virtuelle Assistenten und zur Vertonung von Werbevideos.
  • Pädagogen & Trainer: Zur Erstellung von E-Learning-Modulen, Hörbüchern und barrierefreien Lehrmaterialien.
  • Entwickler: Zur Integration dynamischer Sprachantworten in Apps, Spiele und IVR-Systeme.
  • Autoren & Verleger: Zur kostengünstigen Umwandlung von Büchern und Artikeln in Audioformate.