ToolMage
Anmelden

Best 1 Data Science AI tools for Data Engineering

Popular Data Science AI tools in Data Engineering include DevBlogs, helping you work more efficiently.

DevBlogs

DevBlogs

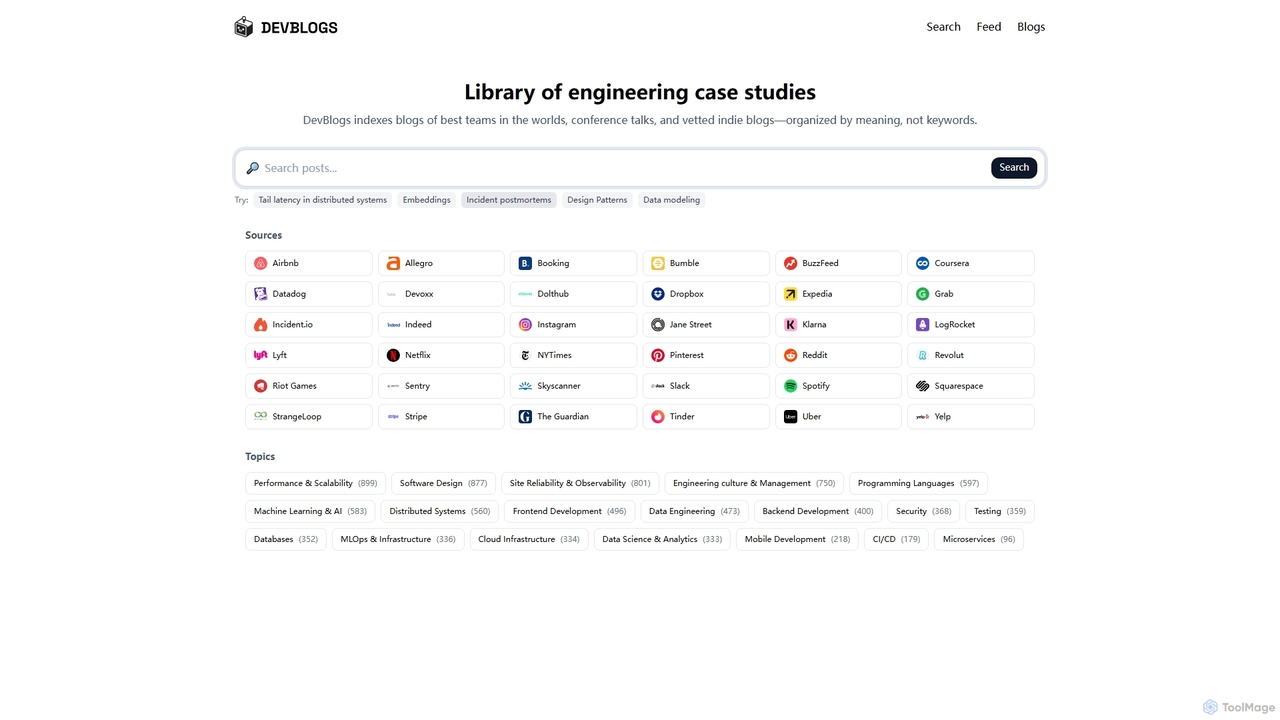
DevBlogs ist eine kuratierte Bibliothek, die technische Fallstudien, Tech-Blogs und Konferenzvorträge von führenden globalen Teams indexiert. Es organisiert Inhalte nach Bedeutung und spezifischen technischen Themen und bietet eine wertvolle Ressource für Entwickler und Ingenieure, um Einblicke und Best Practices zu entdecken.

Infrastruktur
Visits 6.3KFavorites 132Likes 144

About Data Science

Data-Science-Tools sind eine spezialisierte Kategorie von Software, die für die Analyse komplexer Daten, die Erstellung von Vorhersagemodellen und die Gewinnung handlungsorientierter Erkenntnisse entwickelt wurde. Diese Tools integrieren statistische Algorithmen, Bibliotheken für maschinelles Lernen (ML) und interaktive Visualisierungsfunktionen, um Muster und Trends aufzudecken. Sie ermöglichen es Datenwissenschaftlern und Analysten, über einfaches Datenreporting hinauszugehen, zukünftige Ergebnisse vorherzusagen, Informationen zu klassifizieren und datengesteuerte Entscheidungen zu unterstützen. Als Schlüsselkomponente des Data-Engineering-Lebenszyklus arbeiten sie mit bereinigten und aufbereiteten Daten, um fortgeschrittene Analysen durchzuführen.

Kernfunktionen

  • Modellentwicklung & Training: Erstellen, Trainieren und Validieren von Modellen des maschinellen Lernens wie Regression, Klassifikation und Clustering.
  • Interaktive Datenexploration: Nutzung von Notebooks (z.B. Jupyter) und Visualisierungsbibliotheken für tiefgehende Datenanalyse und -entdeckung.
  • Statistische Analyse: Durchführung komplexer statistischer Tests, Hypothesentests und Wahrscheinlichkeitsmodellierung.
  • Feature Engineering: Erstellen, Auswählen und Transformieren von Variablen zur Verbesserung der Genauigkeit und Leistung von Vorhersagemodellen.
  • Bereitstellung & Überwachung: Verpacken und Bereitstellen von Modellen in Produktionsumgebungen und Überwachen ihrer Leistung im Zeitverlauf.

Anwendungsfälle

Data-Science-Tools sind in Branchen wie dem Finanzwesen zur Betrugserkennung, dem E-Commerce zum Aufbau von Empfehlungsmaschinen, dem Gesundheitswesen zur Krankheitsprognose und dem Marketing zur Analyse der Kundenabwanderung von entscheidender Bedeutung. Sie werden hauptsächlich von Datenwissenschaftlern, Ingenieuren für maschinelles Lernen, quantitativen Analysten und akademischen Forschern zur Lösung komplexer Datenprobleme eingesetzt.

Wie man wählt

Bei der Auswahl eines Data-Science-Tools sollten Sie die Bandbreite der unterstützten Algorithmen und Bibliotheken (z.B. TensorFlow, PyTorch, scikit-learn), die Integration mit Datenquellen und MLOps-Plattformen, die Skalierbarkeit für große Datensätze, Kollaborationsfunktionen und die Eignung der Benutzeroberfläche für sowohl Programmier- als auch Low-Code-Workflows berücksichtigen.

Data Science use cases

1

Vorhersage der Kundenabwanderung bei Abonnementdiensten

Ein Marketinganalyst bei einem SaaS-Unternehmen verwendet eine Data-Science-Plattform, um das Nutzerverhalten zu analysieren, einschließlich Anmeldehäufigkeit, Funktionsnutzung und Support-Ticket-Verlauf. Er erstellt ein binäres Klassifikationsmodell (wie logistische Regression oder Gradient Boosting), um Kunden mit hohem Abwanderungsrisiko zu identifizieren. Die Ausgabe des Modells liefert einen Wahrscheinlichkeitsscore für jeden Nutzer, der es dem Marketingteam ermöglicht, proaktiv gezielte Bindungskampagnen für Hochrisikosegmente zu starten und so die monatliche Abwanderungsrate um einen messbaren Prozentsatz zu senken.

2

Erstellung einer Produktempfehlungs-Engine für den E-Commerce

Ein Ingenieur für maschinelles Lernen bei einem Online-Einzelhandelsunternehmen nutzt ein Data-Science-Toolkit, um historische Kauf- und Browserdaten zu verarbeiten. Mithilfe von Algorithmen wie kollaborativem Filtern erstellt er ein Modell, das vorhersagt, an welchen Produkten ein Nutzer wahrscheinlich interessiert ist. Diese Empfehlungs-Engine wird dann in die Produktseiten und den Checkout-Prozess der Website integriert, um das Einkaufserlebnis zu personalisieren und zu einer signifikanten Steigerung des durchschnittlichen Bestellwerts und der Kundenbindung zu führen.

3

Analyse der Stimmung in Kundenbewertungen

Ein Produktmanager möchte die öffentliche Meinung zu einer neuen Funktion verstehen. Er verwendet ein Data-Science-Tool mit Funktionen zur Verarbeitung natürlicher Sprache (NLP), um Tausende von Online-Bewertungen und Social-Media-Kommentaren zu analysieren. Das Tool klassifiziert automatisch die Stimmung jedes Textes als positiv, negativ oder neutral und verwendet Themenmodellierung, um Schlüsselthemen und Schwachstellen zu identifizieren. Dies liefert handlungsorientiertes Feedback zur Produktverbesserung, ohne wochenlanges manuelles Lesen und Kategorisieren zu erfordern.

4

Echtzeit-Finanzbetrugserkennung

Ein Datenwissenschaftler bei einem Finanzinstitut entwickelt ein Anomalieerkennungsmodell unter Verwendung eines Stroms von Transaktionsdaten. Die Data-Science-Plattform ermöglicht es ihm, das Modell an Millionen von historischen Transaktionen zu trainieren, um normale Ausgabenmuster zu lernen. Nach der Bereitstellung bewertet das Modell eingehende Transaktionen in Echtzeit. Transaktionen, die erheblich vom normalen Verhalten eines Nutzers abweichen, werden als verdächtig markiert, was automatisch Warnungen für Betrugsanalysten auslöst und potenziell betrügerische Aktivitäten blockiert, wodurch finanzielle Verluste minimiert werden.

5

Optimierung von Marketingkampagnen durch Kundensegmentierung

Ein Marketingteam verwendet eine Data-Science-Plattform zur Durchführung der Kundensegmentierung. Durch die Anwendung von Clustering-Algorithmen (wie K-Means) auf Kundendaten – einschließlich Demografie, Kaufhistorie und Website-Interaktionen – identifizieren sie unterschiedliche Kundengruppen. Zum Beispiel könnten sie Segmente wie „hochwertige Loyale“, „preisbewusste Käufer“ und „neue Interessenten“ finden. Diese Erkenntnisse ermöglichen es ihnen, Marketingbotschaften, Werbeaktionen und Produktempfehlungen für jedes Segment anzupassen, was den ROI der Kampagne und die Kundenbindung erheblich verbessert.

6

Medizinische Bildanalyse zur Krankheitsdiagnose

Ein medizinischer Forscher verwendet ein Data-Science-Framework mit Deep-Learning-Fähigkeiten zur Unterstützung der Diagnostik. Er trainiert ein Convolutional Neural Network (CNN) an einem großen, beschrifteten Datensatz von medizinischen Bildern wie Röntgenaufnahmen oder MRTs, um Anzeichen einer bestimmten Krankheit zu erkennen. Das resultierende Modell kann neue Bilder analysieren und potenzielle Problembereiche für einen Radiologen zur Überprüfung hervorheben. Dieses Tool fungiert als leistungsstarker Assistent, der hilft, die diagnostische Genauigkeit zu verbessern und den Überprüfungsprozess für große Mengen von Scans zu beschleunigen.

Data Science FAQ

Was sind Data-Science-Tools?

Data-Science-Tools sind Softwareanwendungen, die eine integrierte Umgebung für Datenwissenschaftler zur Analyse von Daten, zur Erstellung von maschinellen Lernmodellen und zur Gewinnung von Erkenntnissen bieten. Sie kombinieren Funktionalitäten wie Datenmanipulation, statistische Analyse, Modelltraining und Visualisierung. Im Gegensatz zu allgemeinen Business-Intelligence-(BI)-Tools, die sich auf historische Berichte konzentrieren, sind Data-Science-Tools auf prädiktive und präskriptive Analysen ausgerichtet, um zukünftige Ereignisse vorherzusagen und Maßnahmen zu empfehlen.

Was ist der Unterschied zwischen Data-Science- und Data-Engineering-Tools?

Data-Engineering-Tools konzentrieren sich auf die Infrastruktur zum Verschieben und Vorbereiten von Daten. Sie übernehmen Aufgaben wie ETL (Extrahieren, Transformieren, Laden), den Aufbau von Datenpipelines und die Verwaltung von Data Warehouses. Ihr Ziel ist es, saubere, zuverlässige Daten bereitzustellen. Im Gegensatz dazu verwenden Data-Science-Tools diese aufbereiteten Daten, um Analysen durchzuführen, Vorhersagemodelle zu erstellen und Experimente durchzuführen. In einem typischen Arbeitsablauf geht das Data Engineering der Data Science voraus und schafft die Grundlage, auf der Analysen und Modellierungen durchgeführt werden können.

Wie wähle ich das richtige Data-Science-Tool aus?

Die Wahl des richtigen Tools hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie diese Schlüsselfaktoren:

  • Sprach- und Bibliotheksunterstützung: Unterstützt es Ihre bevorzugten Sprachen (z.B. Python, R) und wesentliche Bibliotheken (z.B. TensorFlow, PyTorch, Scikit-learn)?
  • Skalierbarkeit: Kann es die Größe Ihrer Datensätze und die Rechenanforderungen Ihrer Modelle effizient bewältigen?
  • Kollaborationsfunktionen: Ermöglicht es Teams, Projekte, Code und Ergebnisse einfach zu teilen?
  • Benutzeroberfläche: Bietet es eine geeignete Oberfläche für Ihr Team, wie z.B. interaktive Notebooks, eine Drag-and-Drop-GUI oder eine leistungsstarke IDE?
  • Integration: Wie gut lässt es sich mit Ihren bestehenden Datenquellen, Cloud-Speichern und Bereitstellungsplattformen (MLOps) verbinden?
Welche gängigen Bibliotheken werden in Data-Science-Tools verwendet?

Die meisten Data-Science-Plattformen integrieren oder basieren auf beliebten Open-Source-Bibliotheken. Für Python sind die gebräuchlichsten:

  • Pandas: Zur Datenmanipulation und -analyse.
  • NumPy: Zur numerischen Berechnung mit Arrays und Matrizen.
  • Matplotlib & Seaborn: Zur Datenvisualisierung.
  • Scikit-learn: Für eine breite Palette von Algorithmen des maschinellen Lernens.
  • TensorFlow & PyTorch: Für Deep Learning und den Aufbau neuronaler Netze.

Für R gehören zu den beliebten Bibliotheken dplyr, ggplot2 und caret.

Wer sind die Hauptnutzer von Data-Science-Tools?

Diese Tools sind hauptsächlich für Fachleute mit analytischen und programmiertechnischen Fähigkeiten konzipiert. Zu den Hauptnutzern gehören:

  • Datenwissenschaftler: Für die End-to-End-Modellentwicklung, von der Datenexploration bis hin zu Experimenten und Validierung.
  • Ingenieure für maschinelles Lernen: Zum Erstellen, Bereitstellen und Warten von produktionsreifen Modellen.
  • Datenanalysten: Zur Durchführung fortgeschrittener statistischer Analysen und zur Erstellung komplexer Visualisierungen.
  • Quantitative Analysten (Quants): Zur Entwicklung von Finanzmodellen in Branchen wie dem Bank- und Investmentwesen.
  • Akademische Forscher: Zur Durchführung quantitativer Forschung und zum Testen von Hypothesen mit Daten.