ToolMage
Anmelden

Best 2 Vektorsuche AI tools for Daten

Popular Vektorsuche AI tools in Daten include Milvus und Ducky, helping you work more efficiently.

Milvus
Freemium

Milvus

Milvus ist eine leistungsstarke Open-Source-Vektordatenbank, die für KI-Anwendungen entwickelt wurde. Sie ermöglicht Entwicklern, Milliarden von hochdimensionalen Vektoren mit minimaler Latenz zu verwalten und zu durchsuchen. Ideal für den Aufbau skalierbarer Systeme wie Retrieval-Augmented Generation (RAG), Empfehlungssysteme und semantische Suche, bietet Milvus flexible Bereitstellungsoptionen vom lokalen Prototyping bis hin zu großen verteilten Clustern.

Maschinelles Lernen
Visits 536.9KFavorites 122Likes 143
Ducky
Freemium

Ducky

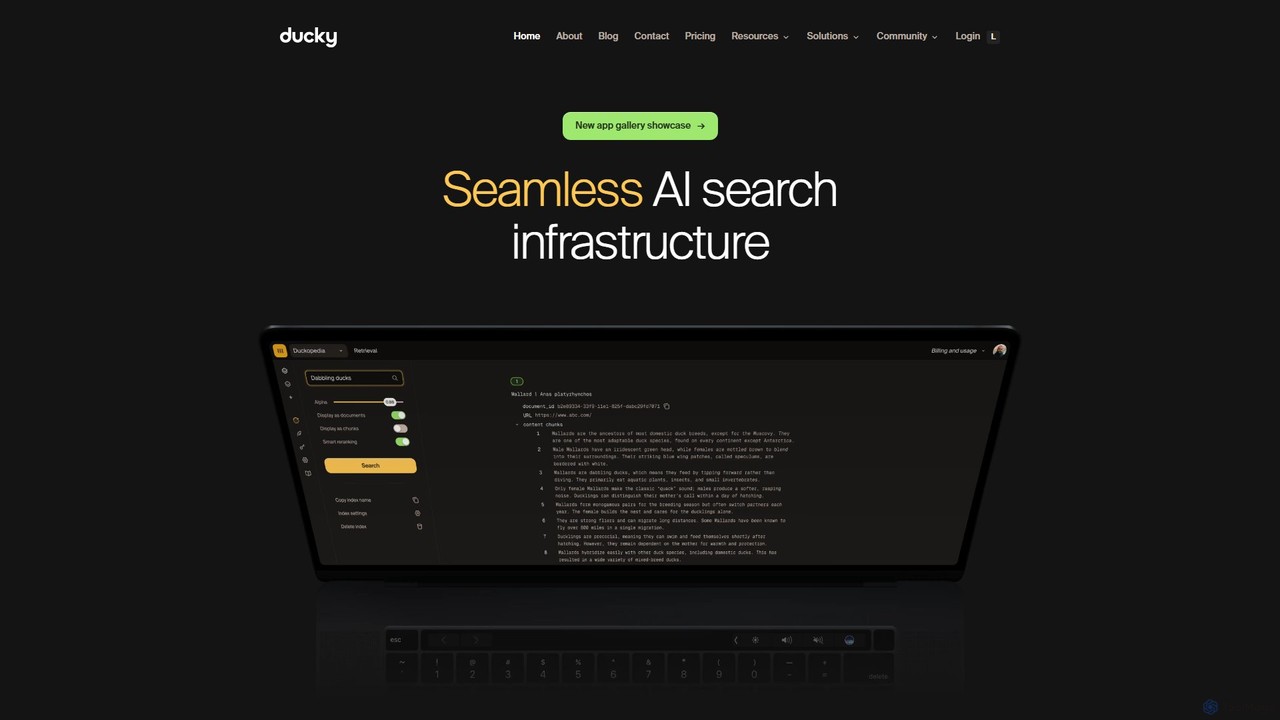
Ducky ist eine vollständig verwaltete KI-Suchinfrastruktur für Entwickler. Es vereinfacht die Implementierung von Retrieval-Augmented Generation (RAG), indem es komplexe Aufgaben wie Daten-Chunking, Embedding und Reranking übernimmt. Mit einem einfachen Python-SDK ermöglicht Ducky Entwicklern, schnell präzise und skalierbare semantische Suchfunktionen in ihre Anwendungen zu integrieren und kontextbezogene, halluzinationsfreie Antworten von LLMs zu liefern.

Retrieval-Augmentierte Generierung
Visits 8.8KFavorites 108Likes 112

About Vektorsuche

Vektorsuchwerkzeuge sind eine spezialisierte Klasse von Datenabrufsystemen, die Informationen basierend auf semantischer Ähnlichkeit und nicht nur auf exakten Schlüsselwortübereinstimmungen finden. Sie funktionieren, indem sie Daten wie Text, Bilder oder Audio in numerische Darstellungen, sogenannte Vektoren, umwandeln und dann in einem hochdimensionalen Raum nach den nächstgelegenen Vektoren suchen. Dies ermöglicht es Anwendungen, Kontext und Bedeutung zu verstehen, was zu intuitiveren Sucherlebnissen, Empfehlungsmaschinen und KI-gesteuerten Wissensdatenbanken führt. Im Gegensatz zur traditionellen Suche eignet sich die Vektorsuche hervorragend für die Verarbeitung komplexer Abfragen und unstrukturierter Daten.

Kernfunktionen

  • Semantische Ähnlichkeitssuche: Identifiziert konzeptionell verwandte Elemente, auch wenn sie keine Schlüsselwörter teilen.
  • Hochdimensionale Indizierung: Verwendet spezialisierte Algorithmen (wie HNSW) für einen schnellen Abruf aus Milliarden von Vektoren.
  • Multimodale Fähigkeiten: Unterstützt die Suche über verschiedene Datentypen hinweg, z. B. die Verwendung eines Bildes, um relevanten Text zu finden.
  • Echtzeit-Skalierbarkeit: Entwickelt, um massive Datensätze und hohe Abfragelasten mit geringer Latenz zu bewältigen.
  • Hybride Suche: Kombiniert Vektorähnlichkeit mit traditioneller Metadaten- oder Schlüsselwortfilterung für präzisere Ergebnisse.

Anwendungsfälle

Die Vektorsuche ist für Entwickler und Datenwissenschaftler, die moderne KI-Anwendungen erstellen, von entscheidender Bedeutung. Sie bildet das Rückgrat von Retrieval-Augmented Generation (RAG)-Systemen für KI-Chatbots, visuellen Empfehlungsmaschinen im E-Commerce und Plattformen zur Erkennung doppelter Inhalte. Sie wird auch in der Sicherheit zur Anomalieerkennung und in der wissenschaftlichen Forschung zum Mustervergleich in komplexen Datensätzen eingesetzt.

Wie man wählt

Bei der Auswahl eines Vektorsuchwerkzeugs sollten Sie dessen Skalierbarkeit und Leistung unter der erwarteten Last berücksichtigen. Bewerten Sie die unterstützten Indizierungsalgorithmen und deren Kompromisse zwischen Geschwindigkeit und Genauigkeit. Beurteilen Sie die Integrationsfähigkeiten mit Embedding-Modellen und bestehender Dateninfrastruktur. Vergleichen Sie außerdem die Bereitstellungsoptionen (Cloud-verwaltet, selbst gehostet) sowie die damit verbundenen Preismodelle und den technischen Aufwand.

Vektorsuche use cases

1

Wissensdatenbanken für KI-Chatbots betreiben (RAG)

Ein KI-Entwickler hat die Aufgabe, einen Kundensupport-Chatbot zu erstellen, der komplexe Fragen auf der Grundlage einer großen Bibliothek technischer Dokumente beantworten kann. Anstatt ein großes Sprachmodell zu verfeinern, verwendet er ein Vektorsuchsystem. Zuerst werden alle Dokumente in Abschnitte unterteilt und in Vektor-Embeddings umgewandelt. Wenn ein Benutzer eine Frage stellt, wird die Frage ebenfalls in einen Vektor umgewandelt. Das System führt dann eine Vektorsuche durch, um die semantisch ähnlichsten Dokumentenabschnitte zu finden. Diese relevanten Abschnitte werden einem Sprachmodell als Kontext zur Verfügung gestellt, das dann eine genaue, quellenbasierte Antwort generiert. Dieser Ansatz, bekannt als Retrieval-Augmented Generation (RAG), verbessert die Antwortgenauigkeit erheblich und reduziert Halluzinationen.

2

Visuelle Produktempfehlung für den E-Commerce

Eine E-Commerce-Plattform möchte ihre Funktion „ähnliche Produkte“ verbessern. Traditionelle Methoden, die auf Tags und Kategorien basieren, erfassen oft keine visuellen Nuancen. Durch die Implementierung einer Vektorsuchmaschine wandeln sie jedes Produktbild in ein Vektor-Embedding um. Wenn ein Kunde ein Produkt ansieht, wird dessen Bildvektor verwendet, um die Datenbank nach den nächsten Nachbarn abzufragen. Das Ergebnis ist eine Liste von Produkten, die in Stil, Farbe und Muster visuell ähnlich sind, auch wenn ihre Metadatenbeschreibungen völlig unterschiedlich sind. Dies führt zu einem ansprechenderen Benutzererlebnis, einer erhöhten Produktentdeckung und höheren Konversionsraten, da Kunden leicht Alternativen finden können, die ihren ästhetischen Vorlieben entsprechen.

3

Inhaltsdeduplizierung und -entdeckung

Ein großes Medienunternehmen verwaltet Millionen von Artikeln und Bildern. Sie stehen vor zwei Herausforderungen: das Hochladen doppelter Inhalte zu verhindern und den Benutzern zu helfen, verwandte Artikel zu entdecken. Sie verwenden eine Vektorsuchdatenbank, um Embeddings all ihrer Inhalte zu speichern. Wenn ein neuer Artikel eingereicht wird, wird sein Inhalt in einen Vektor umgewandelt und mit der Datenbank abgeglichen. Wenn bereits ein sehr naher Vektor existiert, wird der Artikel als potenzielles Duplikat markiert, was redaktionelle Zeit spart. Für die Leser wird, wenn sie einen Artikel zu Ende gelesen haben, dessen Vektor verwendet, um andere Artikel mit ähnlichem semantischem Inhalt zu finden, was relevantere „Als Nächstes lesen“-Vorschläge liefert als einfache kategoriebasierte Links.

4

Anomalieerkennung in der Cybersicherheit

Ein Cybersicherheitsanalyst muss den Netzwerkverkehr auf ungewöhnliche Aktivitäten überwachen, die auf eine Bedrohung hindeuten könnten. Er verwendet ein Vektorsuchsystem, um das normale Netzwerkverhalten zu modellieren. Jedes Netzwerkereignis (wie ein Anmeldeversuch oder eine Datenübertragung) wird basierend auf seinen Attributen in einen Vektor umgewandelt. Im Laufe der Zeit bilden diese Vektoren Cluster, die den normalen Betrieb darstellen. Das System wandelt kontinuierlich neue Ereignisse in Vektoren um und sucht nach deren nächsten Nachbarn. Wenn der Vektor eines neuen Ereignisses weit von jedem bestehenden Cluster entfernt ist (d. h. keine nahen Nachbarn hat), wird er zur sofortigen Untersuchung als Anomalie gekennzeichnet. Dies ermöglicht die Erkennung neuartiger Zero-Day-Bedrohungen, die signaturbasierte Systeme übersehen würden.

5

Umgekehrte Bildsuchmaschinen

Ein Journalist muss die Echtheit eines Fotos überprüfen, das in den sozialen Medien kursiert. Er verwendet ein Tool für die umgekehrte Bildsuche, das auf Vektorsuche basiert. Der Journalist lädt das Bild hoch, das vom Tool sofort in ein Vektor-Embedding umgewandelt wird. Dieser Vektor wird dann verwendet, um eine riesige, vorindizierte Datenbank mit Bildern aus dem gesamten Web zu durchsuchen. Die Suche liefert in Millisekunden visuell ähnliche Bilder zurück, sodass der Journalist die ursprüngliche Quelle, den Kontext und das Datum des Fotos identifizieren kann. Dieser Prozess hilft bei der Bekämpfung von Fehlinformationen, indem gefälschte oder aus dem Kontext gerissene Bilder schnell entlarvt werden – eine Aufgabe, die mit einer schlüsselwortbasierten Suche unmöglich wäre.

6

Beschleunigung der Wirkstoffentdeckung und Genomik

Ein Bioinformatiker sucht nach chemischen Verbindungen mit ähnlichen Eigenschaften wie ein neu entdecktes Molekül. Die Darstellung von Molekülen als Vektor-Embeddings auf der Grundlage ihrer strukturellen und chemischen Eigenschaften ermöglicht Ähnlichkeitssuchen in massivem Maßstab. Der Forscher gibt den Vektor des neuen Moleküls in eine Vektorsuchdatenbank ein, die Millionen bekannter Verbindungen enthält. Das System gibt eine Rangliste der ähnlichsten Moleküle zurück, was die Kandidaten für Labortests drastisch eingrenzt. Dasselbe Prinzip gilt für die Genomik, wo die Vektorsuche Gensequenzen mit ähnlichen funktionellen Mustern identifizieren und so die Forschung zu Krankheiten und Behandlungen beschleunigen kann.

Vektorsuche FAQ

Was ist Vektorsuche?

Die Vektorsuche ist eine Methode zum Abrufen von Informationen, die auf semantischer Bedeutung und Kontext basiert, anstatt auf exakten Schlüsselwortübereinstimmungen. Sie funktioniert, indem unstrukturierte Daten – wie Text, Bilder oder Audio – in numerische Darstellungen umgewandelt werden, die als „Vektor-Embeddings“ bezeichnet werden. Diese Vektoren werden dann in einer spezialisierten Datenbank gespeichert. Wenn eine Abfrage gestellt wird, wird diese ebenfalls in einen Vektor umgewandelt, und das System findet die Vektoren in der Datenbank, die dem Abfragevektor im hochdimensionalen Raum am nächsten sind. Dies ermöglicht das Auffinden konzeptionell ähnlicher Elemente, auch wenn sie unterschiedliche Formulierungen oder visuelle Darstellungen verwenden.

Wie unterscheidet sich die Vektorsuche von der traditionellen Schlüsselwortsuche?

Der Hauptunterschied liegt darin, wie sie Abfragen und Daten interpretieren. Die traditionelle Schlüsselwortsuche beruht auf exakten oder teilweisen Übereinstimmungen von Textzeichenfolgen. Sie findet Dokumente, die die von Ihnen eingegebenen spezifischen Wörter enthalten. Die Vektorsuche hingegen versteht die semantische Bedeutung oder das Konzept hinter der Abfrage. Sie findet Daten, die kontextuell und konzeptionell ähnlich sind, auch wenn sie nicht die exakten Schlüsselwörter enthalten. Zum Beispiel wird eine Schlüsselwortsuche nach „Auto“ kein Dokument über ein „Kraftfahrzeug“ finden, eine Vektorsuche jedoch schon, da sie versteht, dass es sich um semantisch verwandte Konzepte handelt.

Wie wählt man ein Vektorsuchwerkzeug oder eine Datenbank aus?

Die Wahl des richtigen Vektorsuchwerkzeugs hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie die folgenden Faktoren:

  • Skalierbarkeit: Wie viele Vektoren müssen Sie speichern und wie viele Abfragen pro Sekunde erwarten Sie? Wählen Sie eine Lösung, die mit Ihrem Wachstum skalieren kann.
  • Leistung: Bewerten Sie die Latenz (Abfragegeschwindigkeit) und den Recall (Genauigkeit) des Systems. Einige Systeme bieten einstellbare Parameter, um einen Kompromiss zwischen Geschwindigkeit und Genauigkeit zu finden.
  • Bereitstellungsmodell: Bevorzugen Sie einen vollständig verwalteten Cloud-Dienst (einfacher einzurichten) oder eine selbst gehostete Lösung (mehr Kontrolle und potenziell niedrigere Kosten)?
  • Integrationen: Überprüfen Sie die Kompatibilität mit Ihren bestehenden Datenpipelines, Programmiersprachen und den Embedding-Modellen, die Sie verwenden möchten.
  • Funktionen: Suchen Sie nach erweiterten Funktionen wie Metadatenfilterung (hybride Suche), Echtzeit-Indizierung und Datenverwaltungsfunktionen.
Was ist ein „Embedding“ im Kontext der Vektorsuche?

Ein „Embedding“ ist der numerische Vektor, der ein Datenelement in der Vektorsuche darstellt. Es ist eine Liste von Zahlen (oft Hunderte oder Tausende), die die semantische Essenz der ursprünglichen Daten (wie ein Wort, ein Satz, ein Bild oder ein Audioclip) erfasst. Diese Embeddings werden von Deep-Learning-Modellen (wie BERT für Text oder CLIP für Bilder) erstellt, die auf riesigen Datenmengen trainiert wurden. Die Schlüsseleigenschaft von Embeddings ist, dass semantisch ähnliche Elemente Vektoren haben, die im hochdimensionalen Vektorraum nahe beieinander liegen, was die Vektorsuche erst möglich macht.

Wer sollte Vektorsuchwerkzeuge verwenden?

Vektorsuchwerkzeuge sind hauptsächlich für Entwickler, Datenwissenschaftler und Ingenieure für maschinelles Lernen gedacht, die Anwendungen erstellen, die das Verständnis unstrukturierter Daten erfordern. Zu den Hauptnutzern gehören:

  • KI-Anwendungsentwickler: Diejenigen, die Chatbots, Frage-Antwort-Systeme oder andere Anwendungen mit Retrieval-Augmented Generation (RAG) erstellen.
  • E-Commerce-Plattformen: Teams, die erweiterte visuelle Suche oder semantische Produktempfehlungen implementieren möchten.
  • Content-Plattformen: Unternehmen, die große Medienbibliotheken verwalten, verwandte Inhalte empfehlen oder Duplikate erkennen müssen.
  • Cybersicherheitsfirmen: Analysten und Ingenieure, die Systeme zur Anomalieerkennung oder Bedrohungsanalyse entwickeln.
  • Forschungseinrichtungen: Wissenschaftler in Bereichen wie Bioinformatik oder Materialwissenschaften, die Muster in komplexen, hochdimensionalen Daten finden müssen.