ToolMage
Anmelden

Best 1 Stapelverarbeitung AI tools for Entwicklertools

Popular Stapelverarbeitung AI tools in Entwicklertools include Bsub, helping you work more efficiently.

Bsub
Paid

Bsub

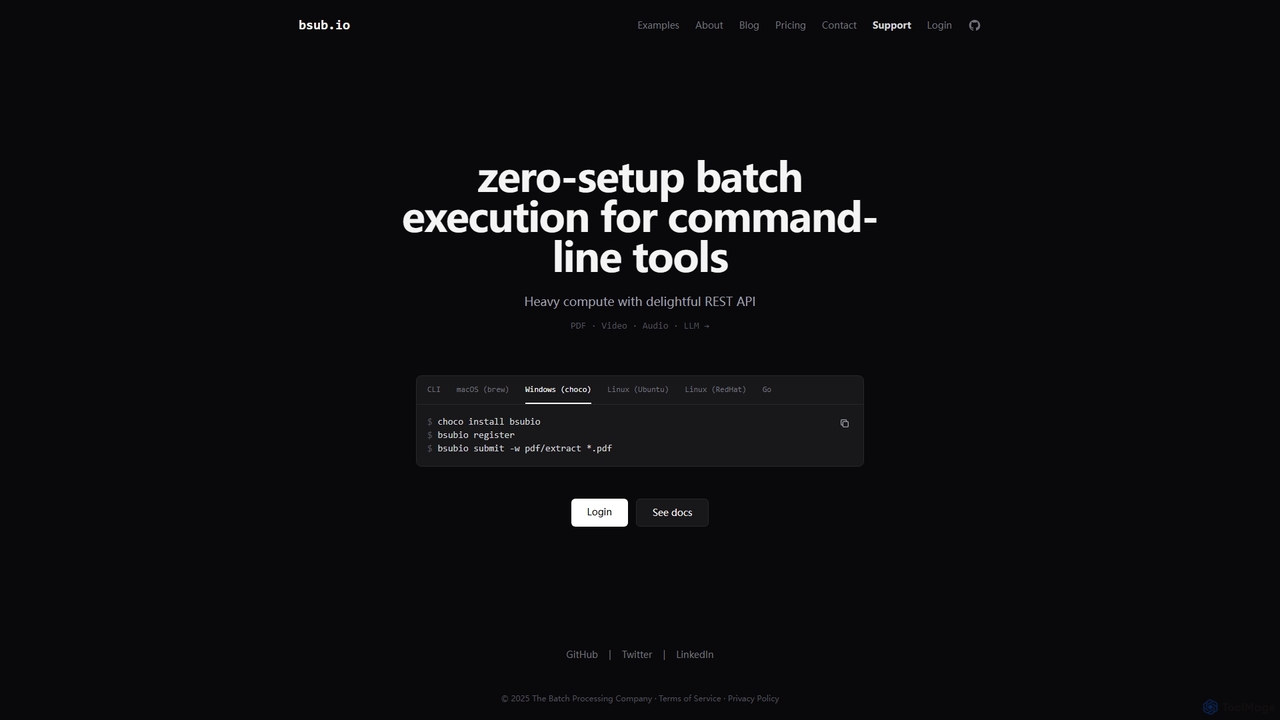
Bsub ist eine Zero-Setup-Batch-Verarbeitungsplattform, die für Entwickler entwickelt wurde, um Befehlszeilentools in großem Maßstab auszuführen. Sie vereinfacht rechenintensive Aufgaben wie PDF-Extraktion, Videotranskodierung, Audio-Transkription und Large Language Model (LLM) Batch-Inferenz über eine einfache REST-API, wodurch Infrastrukturmanagement und Skalierungsbedenken entfallen.

Transkription
Visits 8.6KFavorites 124Likes 138

About Stapelverarbeitung

Stapelverarbeitungs-Tools sind eine spezialisierte Kategorie innerhalb der Entwickler-Tools, die KI nutzen, um die Ausführung repetitiver, hochvolumiger Aufgaben ohne kontinuierliche menschliche Intervention zu automatisieren und zu optimieren. Diese Tools sind darauf ausgelegt, große Datensätze effizient zu verarbeiten, komplexe Workflows auszuführen oder mehrere Operationen in einer vordefinierten Reihenfolge durchzuführen, wodurch Produktivität und Ressourcennutzung erheblich gesteigert werden. Durch die Integration von KI können sie sich an unterschiedliche Datenstrukturen anpassen, aus früheren Operationen lernen und sogar optimale Verarbeitungsstrategien vorhersagen, was sie für die moderne Softwareentwicklung und Daten-Engineering unverzichtbar macht.

Kernfunktionen

  • Automatisierte Aufgabenplanung: Startet und verwaltet automatisch Abfolgen von Operationen basierend auf vordefinierten Triggern oder Zeitplänen.
  • Großskalige Datentransformation: Verarbeitet, bereinigt und transformiert effizient riesige Datenmengen für Analysen, Migration oder das Training von KI-Modellen.
  • Fehlerbehandlung & Resilienz: Enthält Mechanismen zur Erkennung, Protokollierung und oft automatischen Wiederherstellung von Verarbeitungsfehlern, um die Kontinuität des Workflows zu gewährleisten.
  • Parallele Verarbeitung & Skalierbarkeit: Verteilt Aufgaben auf mehrere Rechenressourcen, um die Ausführung zu beschleunigen und wachsende Arbeitslasten zu bewältigen.
  • Integration mit CI/CD-Pipelines: Verbindet sich nahtlos mit Continuous Integration- und Deployment-Systemen für automatisierte Build-, Test- und Deployment-Aufgaben.

Anwendungsfälle

Entwickler, Dateningenieure und DevOps-Teams nutzen KI-Stapelverarbeitung häufig für Aufgaben, die einen hohen Durchsatz und minimale manuelle Überwachung erfordern. Dazu gehören die Automatisierung nächtlicher Datensicherungen, das Ausführen umfangreicher Testsuiten nach Code-Commits oder die Durchführung großskaliger Inhaltsmoderation von benutzergenerierten Daten. Diese Tools sind entscheidend für die Aufrechterhaltung der Betriebseffizienz und die Sicherstellung der Datenkonsistenz in komplexen Systemen.

Auswahlkriterien

Bei der Auswahl eines KI-Stapelverarbeitungs-Tools sollten Sie dessen Skalierbarkeit für zukünftige Datenmengen, Integrationsfähigkeiten mit Ihrem bestehenden Tech-Stack (z. B. Cloud-Plattformen, Datenbanken, CI/CD-Tools) und die Flexibilität seiner Workflow-Definitions- und Planungsfunktionen berücksichtigen. Bewerten Sie die Robustheit der Fehlerbehandlung, die Überwachungsfunktionen und das Niveau der KI-gesteuerten Optimierung, die es bietet, wie z. B. intelligente Ressourcenzuweisung oder adaptive Verarbeitungslogik, um sicherzustellen, dass es spezifische Projektanforderungen und Budgetbeschränkungen erfüllt.

Stapelverarbeitung use cases

1

Automatisierte Code-Analyse und Refactoring

Rolle: Softwareentwickler, DevOps-Ingenieure
Szenario: Eine große Codebasis erfordert regelmäßige statische Analyse, Sicherheitsprüfungen und Refactoring-Vorschläge, um die Qualität zu erhalten und Schwachstellen zu identifizieren. Das manuelle Ausführen dieser Tools über Tausende von Dateien ist zeitaufwendig.
Aktion: Ein KI-Stapelverarbeitungs-Tool wird konfiguriert, um Code-Analyse-Tools (z. B. SonarQube, Linter) bei neuen Commits oder nächtlichen Builds automatisch auszulösen. KI kann kritische Probleme priorisieren und Refactoring-Muster vorschlagen.
Ergebnis: Gewährleistet konsistente Code-Qualität, reduziert technische Schulden und identifiziert potenzielle Fehler oder Sicherheitslücken frühzeitig im Entwicklungszyklus, wodurch Hunderte von Stunden manueller Überprüfung eingespart werden.

2

Automatisierung der Bildgrößenänderung für E-Commerce

Ein E-Commerce-Manager muss täglich Tausende von Produktbildern für verschiedene Plattformanforderungen (Thumbnails, hochauflösend, mobiloptimiert) verarbeiten. Mit einem Stapelverarbeitungstool kann er einen Workflow definieren, um Bilder automatisch in der Größe anzupassen, zu komprimieren und mit Wasserzeichen zu versehen. Dies spart unzählige Stunden manueller Arbeit und gewährleistet eine konsistente visuelle Qualität über alle Angebote hinweg.

3

Massenhafte Datenmigration und -transformation

Ein Dateningenieur hat die Aufgabe, Petabytes an Altdaten von einer alten Datenbank in ein neues Cloud-basiertes Data Warehouse zu migrieren. Stapelverarbeitungstools ermöglichen es ihm, diesen riesigen Datensatz in geplanten, verwaltbaren Blöcken zu extrahieren, zu bereinigen, zu transformieren und zu laden, wodurch die Datenintegrität gewährleistet und Ausfallzeiten während des Übergangs minimiert werden.

4

Großskalige Datenmigration und -transformation

Rolle: Dateningenieure, Datenbankadministratoren
Szenario: Migration von Petabytes historischer Daten von einem lokalen Altsystem in ein neues Cloud-basiertes Data Warehouse, was komplexe Transformationen, Schema-Mapping und Datenbereinigung erfordert.
Aktion: Eine KI-Stapelverarbeitungs-Pipeline wird eingerichtet, um Daten zu extrahieren, KI-gesteuerte Datenqualitätsprüfungen (z. B. Anomalieerkennung, Datentypinferenz) anzuwenden, sie gemäß neuen Schema-Regeln zu transformieren und in das Zielsystem zu laden. Die KI lernt Transformationsmuster.
Ergebnis: Beschleunigt Datenmigrationsprojekte, minimiert manuelle Datenbereinigungsaufwände und gewährleistet die Datenintegrität während des Übergangs, wodurch Projektzeitpläne um bis zu 50 % verkürzt werden.

5

Stapelverarbeitung von KI-Modell-Trainingsdaten

Rolle: Machine Learning Ingenieure, Datenwissenschaftler
Szenario: Vorbereitung riesiger Datensätze (Bilder, Text, Audio) für das Training neuer KI-Modelle, was Aufgaben wie Größenänderung, Normalisierung, Augmentierung und Etikettenprüfung umfasst.
Aktion: Ein KI-Stapelverarbeitungssystem automatisiert die gesamte Datenvorbereitungs-Pipeline. Es kann Daten intelligent basierend auf Modellbedürfnissen augmentieren, Inkonsistenzen in Etiketten erkennen und die verarbeiteten Daten an Trainingscluster verteilen.
Ergebnis: Beschleunigt die Datenvorbereitungsphase erheblich, gewährleistet qualitativ hochwertige Trainingsdaten und ermöglicht es ML-Ingenieuren, sich auf die Modellentwicklung statt auf die Datenaufbereitung zu konzentrieren, was zu schnelleren Modell-Iterationszyklen führt.

6

Geplante Finanzberichtserstellung

Ein Finanzanalyst benötigt tägliche, wöchentliche und monatliche Berichte, die Transaktionsdaten, Markttrends und Compliance-Metriken zusammenfassen. Ein Stapelverarbeitungssystem kann so konfiguriert werden, dass es automatisch Daten aus verschiedenen Quellen abruft, komplexe Berechnungen durchführt und diese Berichte in bestimmten Formaten (z. B. PDF, CSV) generiert, um sie den Stakeholdern pünktlich und ohne manuelles Eingreifen zu liefern.

7

Automatisierte Code-Kompilierung und -Bereitstellung

Softwareentwicklungsteams nutzen die Stapelverarbeitung, um ihre Continuous Integration/Continuous Deployment (CI/CD)-Pipelines zu automatisieren. Nach Code-Commits kompiliert das Tool den Code automatisch, führt Unit-Tests aus, erstellt Artefakte und stellt diese in Staging- oder Produktionsumgebungen bereit, wodurch eine schnelle und konsistente Softwarebereitstellung gewährleistet wird.

8

Automatisierte Bereitstellung und Tests von Microservices

Rolle: DevOps-Ingenieure, SREs
Szenario: Verwaltung Hunderter von Microservices, die jeweils unabhängige Build-, Test- und Bereitstellungszyklen in verschiedenen Umgebungen (Entwicklung, Staging, Produktion) erfordern.
Aktion: KI-Stapelverarbeitungs-Tools integrieren sich in CI/CD-Pipelines, um das parallele Erstellen, Ausführen von Integrationstests und die gestaffelte Bereitstellung von Microservices zu orchestrieren. KI kann optimale Bereitstellungsfenster und Rollback-Strategien basierend auf Leistungsmetriken identifizieren.
Ergebnis: Ermöglicht eine schnelle, zuverlässige und konsistente Bereitstellung von Microservices, reduziert menschliche Fehler in komplexen Release-Prozessen und verbessert die Systemstabilität durch die Automatisierung von Rollbacks bei Problemerkennung.

9

Massenverarbeitung von Bildern/Videos für KI-Vision-Aufgaben

Rolle: Computer-Vision-Ingenieure, Content-Plattformen
Szenario: Eine Content-Plattform muss täglich Millionen von benutzergenerierten Bildern und Videos für Objekterkennung, Inhaltsmoderation, Thumbnail-Generierung und Metadatenextraktion verarbeiten.
Aktion: Eine KI-Stapelverarbeitungs-Pipeline nimmt neue Medien automatisch auf, wendet verschiedene Computer-Vision-Modelle an (z. B. für NSFW-Erkennung, Objekterkennung), generiert optimierte Thumbnails und extrahiert relevante Metadaten, alles parallel.
Ergebnis: Automatisiert die arbeitsintensive Medienverarbeitung, gewährleistet die Einhaltung von Inhaltsrichtlinien und reichert Medien mit durchsuchbaren Metadaten an, was ein effizientes Content-Management und eine Entdeckung in großem Maßstab ermöglicht.

10

Großflächige Protokolldateianalyse

Ein DevOps-Team muss täglich Terabytes an Serverprotokollen analysieren, um Anomalien zu erkennen, die Systemleistung zu überwachen und Probleme zu beheben. Stapelverarbeitungstools können diese riesigen Protokolldateien aufnehmen, parsen, wichtige Metriken extrahieren und sie in Analyse-Dashboards einspeisen, wodurch kritische Einblicke in die Systemgesundheit und -sicherheit ohne Überlastung der manuellen Überprüfung gewonnen werden.

11

Automatisierte Protokollanalyse und Anomalieerkennung

Rolle: Systemadministratoren, Sicherheitsanalysten
Szenario: Überwachung riesiger Protokollströme von Servern, Anwendungen und Netzwerkgeräten, um Sicherheitsbedrohungen, Leistungsengpässe oder Betriebsabweichungen zu identifizieren.
Aktion: Ein KI-Stapelverarbeitungssystem nimmt Protokolldaten kontinuierlich auf, wendet maschinelle Lernalgorithmen an, um ungewöhnliche Muster oder Abweichungen vom Basisverhalten zu erkennen, und generiert Warnungen für kritische Vorfälle. Es kann Ereignisse über verschiedene Protokollquellen hinweg korrelieren.
Ergebnis: Identifiziert proaktiv potenzielle Systemausfälle oder Sicherheitsverletzungen, reduziert die mittlere Erkennungszeit (MTTD) und die mittlere Lösungszeit (MTTR) von Problemen und entlastet menschliche Analysten vom Durchsuchen riesiger Mengen von Protokolldaten.

12

Video-Kodierung und -Transkodierung für Medienplattformen

Ein Medienunternehmen muss Hunderte von Videodateien in verschiedene Formate und Auflösungen für unterschiedliche Geräte und Streaming-Qualitäten konvertieren. Stapelverarbeitungstools ermöglichen es, diese Videos in eine Warteschlange zu stellen, spezifische Kodierungsprofile anzuwenden und sie automatisch zu transkodieren, wodurch sichergestellt wird, dass Inhalte effizient für die Bereitstellung auf einer Vielzahl von Plattformen optimiert sind.

Stapelverarbeitung FAQ

Was ist Stapelverarbeitung?

Stapelverarbeitung ist eine Methode zur Ausführung einer Reihe von Programmen oder Jobs auf einem Computersystem ohne manuelle Intervention, typischerweise an großen Datensätzen oder mehreren Dateien. Sie ist für Aufgaben konzipiert, die unabhängig voneinander ausgeführt werden können und keine Echtzeit-Interaktion erfordern, wie z. B. Datentransformationen, Berichterstellung oder Massendateioperationen. Ihr Hauptziel ist es, den Systemdurchsatz und die Effizienz für wiederkehrende, ressourcenintensive Operationen zu maximieren.

Was sind KI-Stapelverarbeitungs-Tools?

KI-Stapelverarbeitungs-Tools sind eine Untergruppe von Entwickler-Tools, die künstliche Intelligenz nutzen, um die Ausführung großer Mengen repetitiver Aufgaben oder Datenoperationen zu automatisieren und zu optimieren. Im Gegensatz zur traditionellen Stapelverarbeitung können KI-gesteuerte Tools aus Daten lernen, sich an wechselnde Bedingungen anpassen und während der Ausführung intelligente Entscheidungen treffen, wie z. B. die Optimierung der Ressourcenzuweisung oder die dynamische Anpassung von Workflows. Sie sind darauf ausgelegt, Aufgaben wie Datentransformation, Code-Analyse und Inhaltsverarbeitung effizient und in großem Maßstab zu bewältigen, wodurch der manuelle Eingriff minimiert wird.

Wie unterscheiden sich Stapelverarbeitungstools von der Echtzeitverarbeitung?

Die Stapelverarbeitung verarbeitet Daten in großen Blöcken zu geplanten Intervallen und optimiert den Durchsatz und die Effizienz gegenüber einer sofortigen Reaktion. Die Echtzeitverarbeitung hingegen verarbeitet Daten, sobald sie eintreffen, und liefert sofortiges Feedback oder Aktionen, was für interaktive Anwendungen wie Online-Transaktionen oder Live-Analysen entscheidend ist. Die Stapelverarbeitung eignet sich für die Analyse historischer Daten und Hintergrundaufgaben, während die Echtzeitverarbeitung für sofortige betriebliche Anforderungen gedacht ist.

Wie unterscheiden sich KI-Stapelverarbeitungs-Tools von der traditionellen Stapelverarbeitung?

Der Hauptunterschied liegt in der Integration von KI. Die traditionelle Stapelverarbeitung folgt vordefinierten, statischen Regeln und Skripten und führt Aufgaben in einer festen Reihenfolge aus. Die KI-Stapelverarbeitung hingegen integriert maschinelle Lernfähigkeiten, die es Tools ermöglichen, sich dynamisch anzupassen, aus Mustern zu lernen und intelligente Entscheidungen zu treffen. Dies ermöglicht es ihnen, komplexere, variable Daten zu verarbeiten, die Leistung autonom zu optimieren, potenzielle Probleme vorherzusagen und sich in bestimmten Szenarien sogar selbst zu heilen, was eine größere Flexibilität und Effizienz als ihre regelbasierten Gegenstücke bietet.

Was sind die Hauptvorteile der Nutzung von KI für die Stapelverarbeitung in der Entwicklung?

Die Integration von KI in die Stapelverarbeitung bietet Entwicklern mehrere wesentliche Vorteile. Erstens erhöht sie die Effizienz drastisch, indem sie komplexe, repetitive Aufgaben automatisiert, die sonst einen erheblichen manuellen Aufwand erfordern würden. Zweitens kann KI die Ressourcennutzung optimieren, was zu Kosteneinsparungen und schnelleren Ausführungszeiten führt. Drittens verbessert sie die Genauigkeit und Konsistenz, wodurch menschliche Fehler bei der Datenverarbeitung und Codequalitätsprüfungen reduziert werden. Schließlich können KI-gesteuerte Erkenntnisse die Entscheidungsfindung verbessern und adaptivere und widerstandsfähigere Entwicklungs-Workflows ermöglichen, von der Datenvorbereitung bis zur Bereitstellung.

Was sind die Hauptvorteile der Verwendung von Stapelverarbeitungstools?

Die Hauptvorteile umfassen erhebliche Effizienzsteigerungen durch die Automatisierung wiederkehrender Aufgaben, die Reduzierung menschlicher Fehler durch standardisierte Workflows und die Optimierung der Ressourcennutzung durch die Planung von Jobs außerhalb der Spitzenzeiten. Sie bieten auch Skalierbarkeit für die Verarbeitung riesiger Datenmengen, verbesserte Datenkonsistenz und robuste Fehlerbehandlungsmechanismen, was sie für große Datenoperationen unerlässlich macht.

Welche Arten von Aufgaben können KI-Stapelverarbeitungs-Tools für Entwickler automatisieren?

KI-Stapelverarbeitungs-Tools können eine Vielzahl von Entwickleraufgaben automatisieren. Dazu gehören die großskalige Datenmanipulation und -bereinigung für maschinelle Lernmodelle, automatisierte Codequalitätsprüfungen und Sicherheitsscans über gesamte Codebasen hinweg sowie die Orchestrierung komplexer CI/CD-Pipelines für Microservices. Sie werden auch für die Massenverarbeitung von Inhalten (z. B. Bildgrößenänderung, Videokodierung), die automatisierte Protokollanalyse zur Anomalieerkennung und die Verwaltung großskaliger Infrastrukturprovisionierung oder -aktualisierungen eingesetzt, wodurch Entwickler sich auf Innovation konzentrieren können.

Wer profitiert am meisten von Stapelverarbeitungstools?

Entwickler, Dateningenieure, Systemadministratoren und Business Analysten gehören zu den Hauptnutznießern. Entwickler verwenden sie für CI/CD-Pipelines und Skriptausführung. Dateningenieure verlassen sich auf sie für ETL-Prozesse und Data Warehousing. Systemadministratoren nutzen sie für Systemwartung und Protokollanalyse. Business Analysten verwenden sie für die automatisierte Berichterstellung und Datenaggregation.

Wie integrieren sich KI-Stapelverarbeitungs-Tools in bestehende Entwickler-Workflows und -Plattformen?

KI-Stapelverarbeitungs-Tools sind typischerweise für die nahtlose Integration in gängige Entwickler-Workflows und -Plattformen konzipiert. Sie bieten oft APIs, SDKs und Konnektoren für beliebte Cloud-Dienste (AWS, Azure, GCP), Versionskontrollsysteme (Git), CI/CD-Plattformen (Jenkins, GitLab CI) und Datenspeicherlösungen (Datenbanken, Data Lakes). Dies ermöglicht es Entwicklern, Stapelverarbeitungsaufgaben direkt in ihre bestehenden Skripte, Pipelines und Anwendungen einzubetten, wodurch eine kohärente und automatisierte Entwicklungsumgebung ohne größere Re-Architektur gewährleistet wird.

Welche Faktoren sollte ich bei der Auswahl einer Stapelverarbeitungslösung berücksichtigen?

Bei der Auswahl einer Stapelverarbeitungslösung sollten Sie deren Skalierbarkeit mit Ihrem Datenvolumen, ihre Integrationsfähigkeiten mit Ihrem bestehenden Technologie-Stack (Datenbanken, Cloud-Dienste) und ihre Unterstützung für verschiedene Datenformate berücksichtigen. Bewerten Sie die Funktionen zur Fehlerbehandlung und -wiederherstellung, die Überwachungs- und Alarmfunktionen sowie die Flexibilität der Planungsoptionen. Kosteneffizienz und Community-Support sind ebenfalls wichtige Überlegungen.