ToolMage
Anmelden

Best 1 Datenverarbeitung AI tools for Entwicklertools

Popular Datenverarbeitung AI tools in Entwicklertools include JSON Formatter, helping you work more efficiently.

JSON Formatter
Free

JSON Formatter

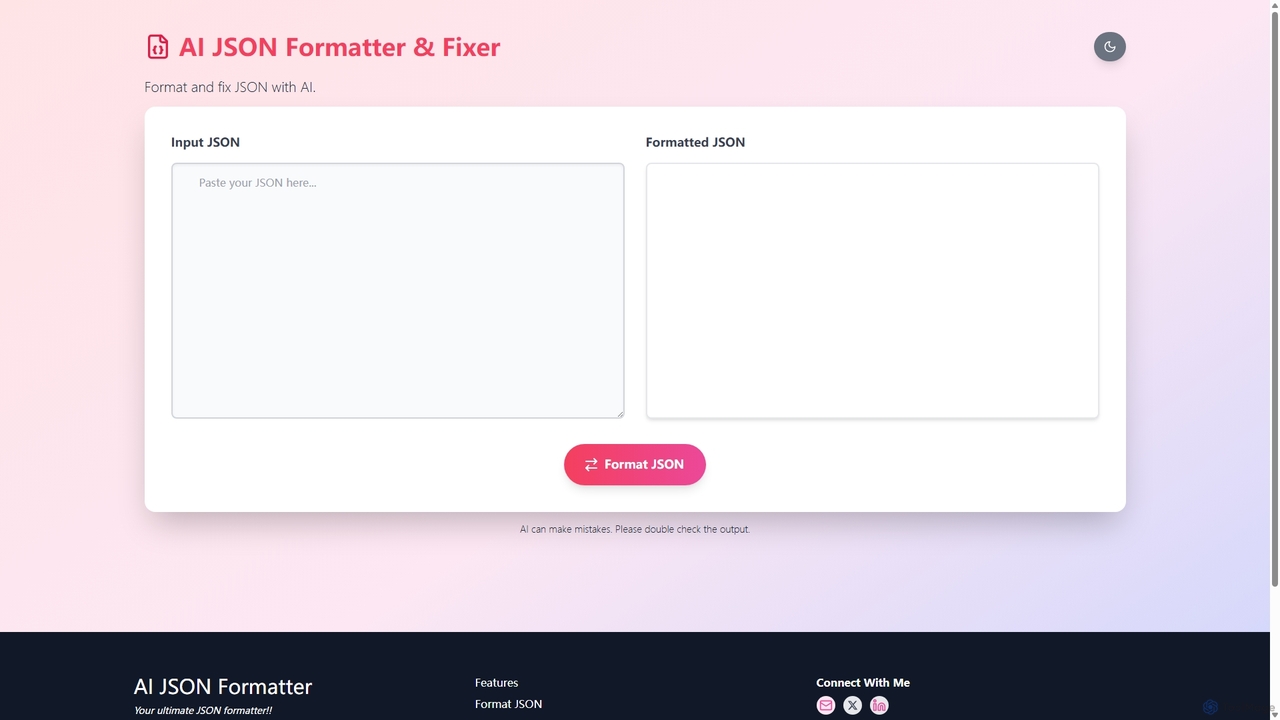
Ein KI-gestütztes Online-Tool zum Formatieren, Validieren und Reparieren von JSON-Daten. Es bietet sofortige Formatierung, intelligente Fehlerkorrektur und Datei-Upload-Funktionen und ist somit für Entwickler unerlässlich, um JSON effizient zu debuggen und zu verwalten.

Code-Assistent
Visits 7.3KFavorites 132Likes 135

About Datenverarbeitung

KI-Datenverarbeitungstools sind eine spezialisierte Kategorie von Entwickler-Utilities, die darauf ausgelegt sind, die Verarbeitung komplexer Datensätze zu automatisieren und zu optimieren. Sie nutzen Algorithmen des maschinellen Lernens für Aufgaben wie Datenbereinigung, -transformation, Feature-Engineering und -validierung und bilden einen entscheidenden Teil des MLOps-Lebenszyklus. Diese Tools sind unerlässlich für die Vorbereitung hochwertiger Daten für Modelle des maschinellen Lernens, die Beschleunigung von Entwicklungszyklen und die Gewährleistung der Datenintegrität in KI-gesteuerten Anwendungen. Durch die intelligente Erkennung von Mustern und Anomalien reduzieren sie den manuellen Aufwand, der typischerweise bei der Datenvorbereitung erforderlich ist, erheblich.

Kernfunktionen

  • Automatisierte Datenbereinigung: Identifiziert und korrigiert intelligent Fehler, Inkonsistenzen und fehlende Werte in Datensätzen.
  • Intelligente Datentransformation: Konvertiert Datenformate, normalisiert Werte und kodiert kategoriale Variablen basierend auf dem Datenkontext.
  • KI-gestütztes Feature-Engineering: Generiert und wählt automatisch relevante Merkmale aus Rohdaten aus, um die Leistung von Machine-Learning-Modellen zu verbessern.
  • Anomalieerkennung: Nutzt KI-Modelle, um Ausreißer und ungewöhnliche Muster zu erkennen, die auf Datenqualitätsprobleme oder kritische Ereignisse hinweisen könnten.
  • Generierung synthetischer Daten: Erstellt künstliche, statistisch repräsentative Datensätze für Tests, Training und den Schutz der Privatsphäre.

Anwendungsfälle

Diese Tools werden hauptsächlich von Datenwissenschaftlern, Ingenieuren für maschinelles Lernen und Dateningenieuren verwendet. Gängige Szenarien umfassen die Vorbereitung von Trainingsdaten für ein neues Vorhersagemodell, den Aufbau robuster und anpassungsfähiger Datenpipelines für Echtzeitanwendungen oder die Bereinigung großer unstrukturierter Textdaten für Aufgaben der natürlichen Sprachverarbeitung (NLP).

Auswahlkriterien

Bei der Auswahl eines KI-Datenverarbeitungstools sollten Sie die Kompatibilität mit Datenquellen (Datenbanken, APIs, Dateiformate), die Skalierbarkeit zur Verarbeitung Ihres Datenvolumens und die Integrationsfähigkeiten mit Ihrem bestehenden MLOps-Stack (z. B. TensorFlow, PyTorch, Cloud-Plattformen) berücksichtigen. Bewerten Sie auch den Automatisierungsgrad im Vergleich zur Notwendigkeit der Definition benutzerdefinierter Regeln, um sicherzustellen, dass es zum Arbeitsablauf und zur technischen Expertise Ihres Teams passt.

Datenverarbeitung use cases

1

Vorbereitung von Trainingsdaten für ein Machine-Learning-Modell

Ein Machine-Learning-Ingenieur hat die Aufgabe, ein Betrugserkennungsmodell zu erstellen. Die rohen Transaktionsdaten sind inkonsistent, mit fehlenden Werten, unterschiedlichen Währungsformaten und verrauschten Textfeldern. Mit einem KI-Datenverarbeitungstool automatisiert der Ingenieur den Prozess der Imputation fehlender Werte auf der Grundlage statistischer Muster, der Standardisierung aller Geldbeträge auf eine einzige Währung und der Bereinigung von Textbeschreibungen. Das Tool schlägt auch neue Merkmale wie die „Transaktionshäufigkeit pro Stunde“ vor und generiert diese. Dies führt zu einem sauberen, hochwertigen Datensatz, der in Stunden statt in Tagen erstellt wird, was die Genauigkeit des endgültigen Modells erheblich verbessert und den manuellen Vorverarbeitungsaufwand um über 80 % reduziert.

2

Automatisierung robuster Datenpipelines

Ein Dateningenieur ist für die Wartung einer ETL/ELT-Pipeline verantwortlich, die Daten von verschiedenen Drittanbieter-APIs in ein Data Warehouse einspeist. Diese APIs weisen häufig Schema-Drifts auf oder liefern Daten in unerwarteten Formaten. Anstatt fragile, regelbasierte Skripte zu schreiben, setzt der Ingenieur ein KI-Datenverarbeitungstool ein. Das Tool erkennt automatisch Schemaänderungen, passt die Transformationslogik im laufenden Betrieb an und verwendet Anomalieerkennung, um fehlerhafte Daten unter Quarantäne zu stellen, bevor sie das Warehouse kontaminieren. Dies schafft eine robustere, selbstheilende Pipeline, die deutlich weniger manuelle Eingriffe erfordert und eine höhere Datenzuverlässigkeit für nachgelagerte Analysen gewährleistet.

3

Bereinigung von unstrukturiertem Text für die NLP-Analyse

Ein Datenwissenschaftler muss Tausende von Kundenbewertungen analysieren, um Stimmungen und Schlüsselthemen zu extrahieren. Der Rohtext ist voller Tippfehler, Umgangssprache und irrelevanter HTML-Tags. Die manuelle Bereinigung dieser Daten wäre extrem zeitaufwändig. Durch die Verwendung eines KI-Datenverarbeitungstools wenden sie vorgefertigte Modelle für Aufgaben wie Rechtschreibkorrektur, Entfernung von Stoppwörtern und Erkennung benannter Entitäten an. Das Tool verarbeitet den gesamten Korpus der Bewertungen und gibt strukturierten, sauberen Text aus, der für die Eingabe in ein Stimmungsanalysemodell bereit ist. Dies beschleunigt den Projektzeitplan von Wochen auf Tage und verbessert die Genauigkeit der NLP-Erkenntnisse.

4

Generierung synthetischer Daten für datenschutzkonforme Tests

Ein Entwicklungsteam in einem Gesundheitstechnologie-Unternehmen muss seine neue Patientenmanagement-Software testen. Die Verwendung echter Patientendaten ist aufgrund strenger Datenschutzbestimmungen wie HIPAA keine Option. Das Team verwendet ein KI-Datenverarbeitungstool mit Funktionen zur Generierung synthetischer Daten. Sie stellen dem Tool das Schema und die statistischen Eigenschaften ihrer realen Daten zur Verfügung. Das Tool generiert dann einen großen, künstlichen Datensatz von Patientenakten, der die realen Verteilungen und Beziehungen nachahmt, ohne tatsächliche persönliche Informationen zu enthalten. Dies ermöglicht dem QA-Team, robuste, groß angelegte Tests durchzuführen und dabei die Datenschutzgesetze vollständig einzuhalten.

5

Standardisierung unterschiedlicher E-Commerce-Produktdaten

Ein E-Commerce-Datenanalyst muss Produktkataloge von mehreren Lieferanten zusammenführen. Jeder Lieferant liefert Daten in unterschiedlichen Formaten, mit inkonsistenten Namenskonventionen (z. B. „Color“ vs. „Colour“) und unterschiedlichen Attributstrukturen. Mit einem KI-Datenverarbeitungstool kann der Analyst diese unterschiedlichen Felder intelligent zuordnen und standardisieren. Die KI des Tools erkennt semantische Ähnlichkeiten, um Attribute korrekt zusammenzuführen, und verwendet Clustering-Algorithmen, um ähnliche Produkte zu gruppieren und potenzielle Duplikate zu identifizieren. Dieser Prozess erstellt einen einheitlichen, sauberen Master-Produktkatalog, der die Genauigkeit der Suche vor Ort direkt verbessert und das Browsing-Erlebnis des Kunden verbessert.

6

Validierung von Echtzeit-IoT-Sensordatenströmen

Ein IoT-Entwickler baut ein vorausschauendes Wartungssystem für Industriemaschinen, das auf einem konstanten Strom von Sensordaten (Temperatur, Vibration, Druck) basiert. Diese Daten können aufgrund von Sensorfehlfunktionen verrauscht sein oder fehlerhafte Messwerte enthalten. Ein KI-Datenverarbeitungstool wird im Datenstrom implementiert, um eine Echtzeitvalidierung durchzuführen. Es verwendet trainierte Modelle, um anomale Messwerte zu identifizieren, die außerhalb der erwarteten Betriebsbereiche oder -muster liegen. Das Tool kann diese Ausreißer automatisch markieren, filtern oder sogar korrigieren, bevor sie in das Vorhersagemodell eingespeist werden, um Fehlalarme zu vermeiden und die Zuverlässigkeit von Wartungswarnungen zu gewährleisten.

Datenverarbeitung FAQ

Was sind KI-Datenverarbeitungstools?

KI-Datenverarbeitungstools sind spezialisierte Software für Entwickler, die künstliche Intelligenz nutzen, um Datenaufbereitungsaufgaben zu automatisieren und zu verbessern. Im Gegensatz zu herkömmlichen Skripten oder ETL-Tools, die auf expliziten Regeln basieren, können diese Tools Datenmuster lernen, um komplexe Datensätze intelligent zu bereinigen, zu transformieren, zu validieren und sogar Merkmale daraus zu generieren. Sie sind darauf ausgelegt, den zeitaufwändigsten Teil des maschinellen Lernworkflows zu beschleunigen: die Vorbereitung hochwertiger Daten.

Wie unterscheiden sich KI-Datenverarbeitungstools von traditionellen ETL-Tools?

Der Hauptunterschied liegt in der Intelligenz und Anpassungsfähigkeit. Traditionelle ETL-Tools (Extrahieren, Transformieren, Laden) arbeiten nach starren, vordefinierten Regeln, die von einem Entwickler festgelegt werden. Wenn sich das Datenformat ändert, brechen die Regeln. KI-Datenverarbeitungstools sind dynamischer. Sie nutzen maschinelles Lernen, um:

  • Regeln abzuleiten: Transformationen basierend auf dem Dateninhalt automatisch vorzuschlagen.
  • Sich an Drift anzupassen: Änderungen im Datenschema oder in Mustern ohne manuellen Eingriff zu bewältigen.
  • Subtile Anomalien zu erkennen: Komplexe Ausreißer zu finden, die einfache regelbasierte Systeme übersehen würden.
  • Feature-Engineering zu automatisieren: Neue prädiktive Variablen zu erstellen, eine Aufgabe, die über den Umfang der meisten ETL-Tools hinausgeht.
Im Wesentlichen wechseln sie von einem befehlsbasierten zu einem lernbasierten Ansatz und reduzieren so den manuellen Wartungsaufwand.

Wer sind die Hauptnutzer von KI-Datenverarbeitungstools?

Die Hauptnutzer sind technische Fachleute, die direkt mit Daten arbeiten, um Anwendungen oder Modelle zu erstellen. Dazu gehören:

  • Datenwissenschaftler: Zur Datenbereinigung und Durchführung von Feature-Engineering zur Verbesserung der Modellgenauigkeit.
  • Ingenieure für maschinelles Lernen: Zur Erstellung robuster, automatisierter Datenpipelines als Teil von MLOps-Praktiken.
  • Dateningenieure: Zum Aufbau widerstandsfähiger und anpassungsfähiger ETL/ELT-Prozesse, die weniger Wartung erfordern.
  • Softwareentwickler: Zur Generierung synthetischer Daten für Tests oder zur Handhabung komplexer Datenvalidierungen innerhalb von Anwendungen.
Diese Tools sind im Allgemeinen nicht für nicht-technische Geschäftsanalysten konzipiert, da sie oft ein gewisses Verständnis von Datenstrukturen und Entwicklungsworkflows erfordern.

Wie wähle ich das richtige KI-Datenverarbeitungstool aus?

Die Wahl des richtigen Tools hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie diese Schlüsselfaktoren:

  • Datenquellen und -formate: Stellen Sie sicher, dass das Tool Konnektoren für Ihre Datenbanken, APIs und die von Ihnen verwendeten Dateitypen (z. B. Parquet, JSON, CSV) unterstützt.
  • Skalierbarkeit: Kann das Tool das Volumen und die Geschwindigkeit Ihrer Daten bewältigen? Prüfen Sie, ob es verteilte Verarbeitung (wie Spark) unterstützt.
  • Integration: Wie gut passt es in Ihr bestehendes Entwickler-Ökosystem? Suchen Sie nach Integrationen mit MLOps-Plattformen, Cloud-Diensten (AWS, GCP, Azure) und Code-Repositorys.
  • Anwendungsfall-Fokus: Einige Tools zeichnen sich durch die Verarbeitung unstrukturierter Texte aus, während andere besser für tabellarische Daten oder die Generierung synthetischer Daten geeignet sind. Passen Sie die Stärken des Tools an Ihre Hauptaufgabe an.
Beginnen Sie mit der Bewertung von Tools anhand einer spezifischen, repräsentativen Datenaufbereitungsaufgabe aus einem Ihrer Projekte.

Können KI-Datenverarbeitungstools mit unstrukturierten Daten wie Text und Bildern arbeiten?

Ja, viele fortschrittliche KI-Datenverarbeitungstools sind speziell für die Verarbeitung unstrukturierter oder semistrukturierter Daten konzipiert. Für Text bieten sie Funktionen wie NLP-basierte Bereinigung (Tippfehlerkorrektur, Entfernung von Stoppwörtern), Entitätserkennung und Themenmodellierung. Bei Bildern können sie bei Aufgaben wie automatischem Tagging, Größenänderung oder der Identifizierung von Qualitätsproblemen (z. B. Unschärfe) helfen. Diese Fähigkeit ist ein wesentlicher Vorteil gegenüber herkömmlichen Daten-Tools, die oft auf strukturierte, tabellarische Daten beschränkt sind. Bei der Auswahl eines Tools sollten Sie dessen spezifische Fähigkeiten für die Art der unstrukturierten Daten, mit denen Sie arbeiten, überprüfen.