
ToolMage
Anmelden

Best 1 Lokale LLMs AI tools for Entwicklertools

Popular Lokale LLMs AI tools in Entwicklertools include Offeline, helping you work more efficiently.

Offeline
Free

Offeline

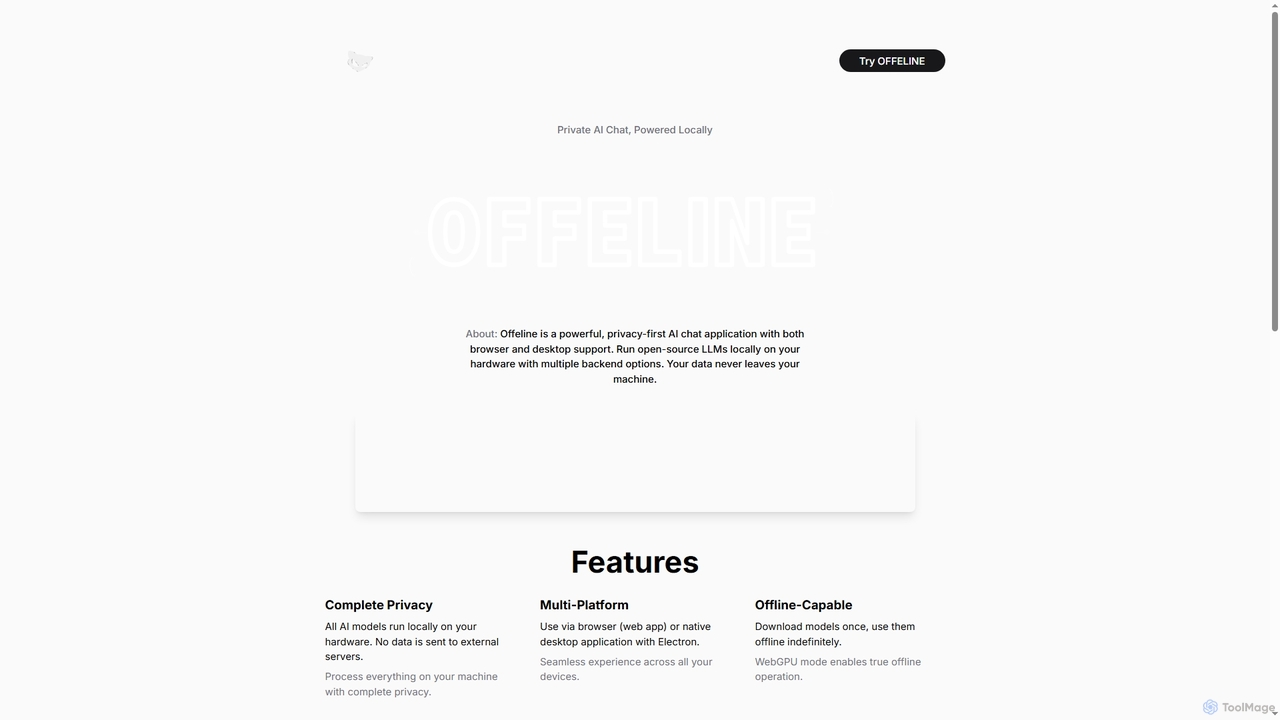
Offeline ist eine leistungsstarke, datenschutzorientierte KI-Chat-Anwendung, die quelloffene Large Language Models (LLMs) lokal auf Ihrer Hardware ausführt. Sie unterstützt sowohl Browser- als auch native Desktop-Nutzung und stellt sicher, dass Ihre Daten niemals Ihr Gerät verlassen. Genießen Sie Offline-Funktionen, Web-Suchintegration, Dokumentenanalyse und Sprachunterstützung.

Lokale LLMs
Visits 7.2KFavorites 172Likes 180

About Lokale LLMs

Lokale LLMs sind große Sprachmodelle, die darauf ausgelegt sind, direkt auf lokaler Hardware wie Personalcomputern oder Edge-Geräten ausgeführt zu werden, ohne eine Internetverbindung zu externen Cloud-Servern zu benötigen. Dieser Ansatz ermöglicht eine verbesserte Datenprivatsphäre, reduzierte Betriebskosten und Echtzeit-Inferenzfunktionen. Sie sind besonders wertvoll für Entwickler, die Anwendungen erstellen, bei denen Datenhoheit, geringe Latenz oder Offline-Funktionalität von größter Bedeutung sind.

Kernfunktionen

  • Offline-Betrieb:Ermöglicht die Inferenz von KI-Modellen ohne Internetverbindung, ideal für Remote- oder sichere Umgebungen.
  • Datenprivatsphäre:Verarbeitet sensible Informationen lokal und stellt sicher, dass Daten das Gerät des Benutzers niemals verlassen.
  • Kosteneffizienz:Eliminiert wiederkehrende API-Aufrufkosten, die mit Cloud-basierten LLMs verbunden sind, und reduziert langfristige Ausgaben.
  • Geringe Latenz:Bietet nahezu sofortige Antworten, da Berechnungen direkt auf dem Gerät stattfinden und Netzwerkverzögerungen umgangen werden.
  • Anpassung & Feinabstimmung:Ermöglicht Entwicklern, Modelle mit proprietären Daten lokal feinabzustimmen, wodurch die domänenspezifische Leistung verbessert wird.

Anwendungsszenarien

Entwickler und Unternehmen nutzen Lokale LLMs für Anwendungen, die eine strenge Datenverwaltung erfordern, wie die Analyse interner Dokumente im Finanz- oder Gesundheitswesen. Sie sind auch entscheidend für Edge-Computing-Szenarien, wie Smart-Home-Geräte oder industrielles IoT, wo Echtzeitverarbeitung und Offline-Fähigkeiten unerlässlich sind. Darüber hinaus können einzelne Benutzer sie für persönliche KI-Assistenten nutzen, die den Datenschutz priorisieren.

Auswahlkriterien

Bei der Auswahl eines Lokalen LLM sollten Sie die Größe und Leistungsanforderungen des Modells im Verhältnis zu Ihren Hardwarefähigkeiten berücksichtigen. Bewerten Sie die einfache Integration in Ihren bestehenden Entwicklungs-Stack, verfügbare Quantisierungsoptionen für Effizienz und die Community-Unterstützung für spezifische Frameworks (z. B. Llama.cpp, Ollama). Datenprivatsphäre-Funktionen und die Möglichkeit zur lokalen Feinabstimmung sind ebenfalls kritische Faktoren.

Lokale LLMs use cases

1

Erstellung datenschutzorientierter KI-Assistenten

Entwickler erstellen persönliche KI-Assistenten oder Chatbots, die Benutzeranfragen verarbeiten und Antworten vollständig auf dem Gerät des Benutzers generieren. Dies stellt sicher, dass sensible persönliche Daten wie Gesundheitsinformationen oder Finanzdetails privat bleiben und niemals die lokale Umgebung verlassen, was für Benutzer mit starken Datenschutzbedenken attraktiv ist.

2

Offline-Dokumentenanalyse und -Zusammenfassung

Forscher oder Juristen verwenden Lokale LLMs, um große Mengen vertraulicher Dokumente (z. B. juristische Schriftsätze, Krankenakten) auf ihren Laptops zu analysieren, ohne sie in Cloud-Dienste hochzuladen. Das LLM kann Inhalte zusammenfassen, Schlüsselinformationen extrahieren oder Fragen beantworten und so Einblicke liefern, während strenge Datensicherheit und Compliance gewahrt bleiben.

3

Edge-KI für industrielles IoT

Hersteller setzen Lokale LLMs auf Edge-Geräten in Fabriken ein, um Maschinen zu überwachen, Wartungsbedürfnisse vorherzusagen oder Sensordaten in Echtzeit zu analysieren. Dies ermöglicht sofortige Entscheidungen, ohne auf potenziell unzuverlässige oder latenzintensive Cloud-Verbindungen angewiesen zu sein, wodurch die Betriebseffizienz und Sicherheit in entfernten oder kritischen Infrastrukturen verbessert wird.

4

Lokale Codegenerierung und Refactoring

Softwareentwickler integrieren Lokale LLMs in ihre IDEs, um bei der Codegenerierung, Refactoring oder Fehlerbehebung zu helfen. Dies ermöglicht es ihnen, Codevorschläge zu erhalten und Aufgaben zu erledigen, ohne proprietären Code an externe Server zu senden, wodurch die Produktivität gesteigert und das geistige Eigentum sicher in ihrer lokalen Entwicklungsumgebung gehalten wird.

5

Personalisierte Inhaltserstellung für Kreative

Content-Ersteller oder Marketingfachleute verwenden Lokale LLMs, um personalisierte Marketingtexte, Social-Media-Beiträge oder kreative Schreibaufforderungen direkt auf ihren Workstations zu generieren. Dies liefert sofortige, maßgeschneiderte Inhaltsvorschläge basierend auf ihren lokalen Daten und Präferenzen und bietet kreative Unterstützung, ohne Cloud-API-Kosten oder Datenschutzrisiken zu verursachen.

6

Bildungstools für das KI-Lernen

Studenten und Pädagogen nutzen Lokale LLMs, um mit KI-Modellen zu experimentieren, deren Mechanismen zu verstehen und Anwendungen zu entwickeln, ohne eine leistungsstarke Cloud-Infrastruktur zu benötigen oder Kosten zu verursachen. Dies bietet eine praktische Lernumgebung für die Verarbeitung natürlicher Sprache, die sicheres Experimentieren und die Entwicklung von KI-Fähigkeiten ermöglicht.

Lokale LLMs FAQ

Was sind Lokale LLMs?

Lokale LLMs sind große Sprachmodelle, die darauf ausgelegt sind, direkt auf dem persönlichen Gerät eines Benutzers, wie einem Computer oder Smartphone, anstatt auf entfernten Cloud-Servern ausgeführt zu werden. Sie verarbeiten Informationen lokal und bieten Vorteile wie verbesserte Datenprivatsphäre, reduzierte Betriebskosten und die Fähigkeit, vollständig offline zu funktionieren. Sie sind ideal für Anwendungen, bei denen Datenhoheit und geringe Latenz kritisch sind.

Warum sollte man ein Lokales LLM gegenüber einem Cloud-basierten LLM wählen?

Lokale LLMs bieten deutliche Vorteile gegenüber Cloud-basierten Alternativen, hauptsächlich in Bezug auf Datenprivatsphäre (Daten verlassen Ihr Gerät niemals), Kosteneffizienz (keine wiederkehrenden API-Gebühren) und Offline-Zugänglichkeit. Sie bieten auch geringere Latenz für Echtzeitanwendungen und eine größere Kontrolle über die Modell-Anpassung. Cloud-LLMs bieten jedoch typischerweise eine überlegene Leistung für sehr große Modelle und erfordern weniger lokale Hardware.

Welche Hardware wird benötigt, um Lokale LLMs auszuführen?

Die Hardwareanforderungen für die Ausführung Lokaler LLMs variieren erheblich je nach Größe und Komplexität des Modells. Im Allgemeinen ist eine moderne CPU mit ausreichend RAM (oft 16 GB oder mehr empfohlen) ein guter Ausgangspunkt. Für eine bessere Leistung, insbesondere bei größeren Modellen, wird eine dedizierte GPU mit ausreichend VRAM (8 GB+ ist vorteilhaft) dringend empfohlen. Quantisierte Modelle können auf weniger leistungsstarker Hardware ausgeführt werden.

Können Lokale LLMs mit benutzerdefinierten Daten feinabgestimmt werden?

Ja, viele Lokale LLMs können direkt auf dem Gerät des Benutzers mit benutzerdefinierten, proprietären Daten feinabgestimmt werden. Dieser Prozess ermöglicht es Entwicklern, das Wissen und Verhalten des Modells an spezifische Domänen oder Aufgaben anzupassen, wodurch seine Relevanz und Genauigkeit für bestimmte Anwendungen verbessert wird. Die lokale Feinabstimmung stellt sicher, dass sensible Trainingsdaten sicher und privat bleiben.

Wie unterscheiden sich Lokale LLMs von traditionellen „Entwickler-Tools“ im KI-Bereich?

Obwohl Lokale LLMs eine Untergruppe der „Entwickler-Tools“ im KI-Bereich sind, liegt ihr einzigartiges Merkmal in der Betonung der Ausführung auf dem Gerät. Traditionelle KI-Entwickler-Tools könnten sich auf Cloud-API-Integration, Modelltrainingsplattformen oder MLOps für Cloud-Bereitstellungen konzentrieren. Lokale LLMs hingegen bieten die Tools und Frameworks (wie Llama.cpp oder Ollama) speziell für die Bereitstellung und Verwaltung von KI-Modellen direkt auf lokaler Hardware, um datenschutzsensible oder Offline-First-Entwicklungsanforderungen zu erfüllen.