
ToolMage
Anmelden

Best 1 Datengenerierung AI tools for Produktivität

Popular Datengenerierung AI tools in Produktivität include AI Placeholder, helping you work more efficiently.

AI Placeholder
Free

AI Placeholder

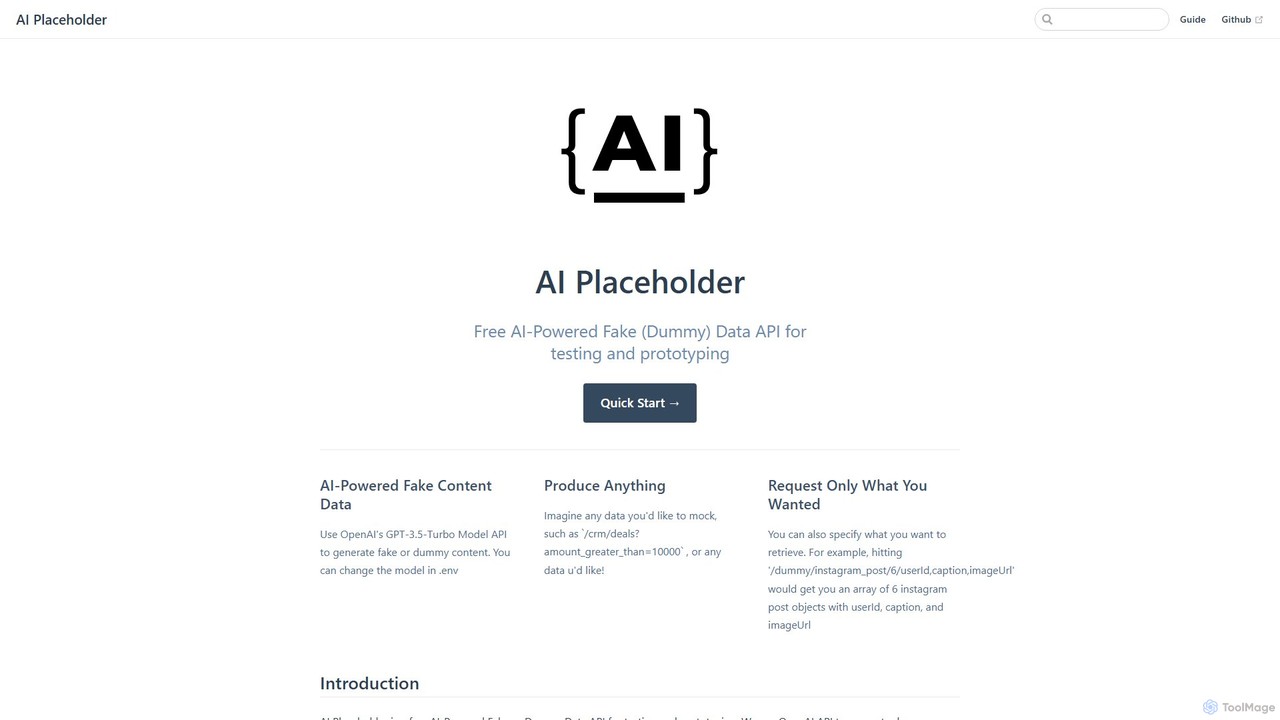
AI Placeholder ist eine kostenlose Open-Source-API, die OpenAI's GPT-3.5-Turbo nutzt, um realistische Fake- oder Dummy-Daten für Tests und Prototyping zu generieren. Entwickler können hochgradig angepasste Datensätze on-the-fly erstellen, von einfachen Benutzerlisten bis hin zu komplexen CRM-Deal-Daten, indem sie einfach eine API-Anfrage strukturieren. Es bietet sowohl eine gehostete Version zur sofortigen Nutzung als auch die Möglichkeit zum Self-Hosting für mehr Kontrolle.

API & Testen
Visits 11.2KFavorites 145Likes 141

About Datengenerierung

Datengenerierungs-Tools sind eine Klasse von KI-Anwendungen, die dazu dienen, synthetische, strukturierte oder Mock-Daten programmatisch zu erstellen. Diese Tools nutzen generative Modelle, statistische Algorithmen und benutzerdefinierte Regeln, um hochwertige Datensätze zu erzeugen, die die Eigenschaften von realen Informationen nachahmen. Ihr Hauptwert liegt in der Beschleunigung von Softwaretests, dem Training von maschinellen Lernmodellen ohne sensible Daten und dem Schutz der Privatsphäre der Nutzer. Durch den bedarfsgerechten Zugriff auf realistische Daten beseitigen sie kritische Engpässe in Entwicklungs- und Forschungsworkflows.

Kernfunktionen

  • Erstellung synthetischer Daten: Generiert statistisch genaue tabellarische, Text- oder Bilddaten basierend auf realen Datenmustern oder benutzerdefinierten Schemata.
  • Datenanonymisierung: Erstellt datenschutzfreundliche Datensätze, indem personenbezogene Informationen (PII) durch realistische synthetische Werte ersetzt werden.
  • Testdatenmanagement: Produziert spezifische Datenmengen und -formate, die für Datenbank-Lasttests, API-Validierung und Qualitätssicherung erforderlich sind.
  • Anpassbare Schemata: Ermöglicht Benutzern die Definition von Datentypen, Beziehungen und Einschränkungen, um hochspezifische und strukturierte Datensätze zu generieren.
  • Datenerweiterung: Erweitert bestehende kleine Datensätze durch die Erstellung neuer, vielfältiger Datenpunkte, um die Robustheit von maschinellen Lernmodellen zu verbessern.

Anwendungsfälle

Diese Tools werden häufig von Softwareentwicklungsteams zur Erstellung umfassender Testumgebungen und von Datenwissenschaftlern zum Trainieren von KI-Modellen verwendet, wenn reale Daten knapp, unausgewogen oder durch Datenschutzbestimmungen geschützt sind. Finanzinstitute nutzen sie beispielsweise zur Generierung synthetischer Transaktionsdaten für die Entwicklung von Betrugserkennungsmodellen, während Forscher im Gesundheitswesen anonymisierte Patientendaten für Analysen erstellen, ohne die Vertraulichkeit zu gefährden.

Auswahlkriterien

Bei der Auswahl eines Datengenerierungs-Tools sollten Sie die erforderlichen Datentypen (z. B. tabellarisch, Text, Zeitreihen) berücksichtigen. Bewerten Sie die Genauigkeit der generierten Daten – wie gut sie die statistischen Eigenschaften realer Daten erfassen. Beurteilen Sie die Skalierbarkeit zur Erzeugung großer Informationsmengen und die Integrationsfähigkeiten mit Ihren bestehenden Datenbanken und APIs. Schließlich sollten Sie bei sensiblen Anwendungen die Unterstützung des Tools für formale Datenschutzgarantien wie Differential Privacy überprüfen.

Datengenerierung use cases

1

Testdaten für die Softwareentwicklung generieren

Ein Qualitätssicherungsingenieur (QS) hat die Aufgabe, die Datenbankleistung einer neuen E-Commerce-Anwendung unter hoher Last zu testen. Anstatt sensible echte Kundendaten zu verwenden, nutzt er ein Datengenerierungstool, um eine Million realistische, aber vollständig gefälschte Benutzerprofile zu erstellen. Dies umfasst die Generierung konsistenter Namen, E-Mail-Adressen, Lieferadressen und Bestellhistorien, die dem Datenbankschema entsprechen. Der resultierende Datensatz ermöglicht umfassende Stresstests und die Identifizierung von Fehlern in einer sicheren, datenschutzkonformen Umgebung, was den QS-Zyklus vor der Veröffentlichung erheblich beschleunigt.

2

Ein Machine-Learning-Modell mit synthetischen Daten trainieren

Ein Datenwissenschaftler entwickelt ein Betrugserkennungsmodell, verfügt jedoch über einen unausgeglichenen Datensatz mit sehr wenigen Beispielen für betrügerische Transaktionen. Diese Knappheit erschwert das Training eines präzisen Modells. Durch den Einsatz eines KI-Datengenerierungstools können die Muster der wenigen echten Betrugsfälle analysiert und Tausende neuer, vielfältiger und realistischer synthetischer Betrugsbeispiele generiert werden. Dieser als Datenerweiterung bekannte Prozess schafft einen ausgewogenen Trainingsdatensatz, der es dem maschinellen Lernmodell ermöglicht, die Merkmale von Betrug effektiver zu erlernen und seine Erkennungsgenauigkeit in realen Szenarien erheblich zu verbessern.

3

Anonymisierte Datensätze für die Forschung erstellen

Eine Forschungseinrichtung im Gesundheitswesen muss Patientendaten für eine gemeinsame Studie mit externen Partnern teilen, ist aber an strenge Datenschutzbestimmungen wie HIPAA gebunden. Um dies zu überwinden, verwenden sie ein Datengenerierungstool, um einen synthetischen Datensatz zu erstellen. Das Tool analysiert die ursprünglichen, privaten Patientendaten, um deren statistische Eigenschaften, Verteilungen und Korrelationen zu lernen. Anschließend generiert es einen völlig neuen Datensatz, der diese statistischen Merkmale widerspiegelt, aber keine echten Patienteninformationen enthält. Dies ermöglicht es Forschern, wertvolle Erkenntnisse zu teilen und frei zusammenzuarbeiten, ohne die Vertraulichkeit der Patienten zu gefährden, und gewährleistet die vollständige rechtliche und ethische Einhaltung.

4

Produktdemos und Prototypen mit Daten füllen

Ein Produktmanager bereitet eine Präsentation eines neuen Analyse-Dashboards für potenzielle Investoren vor. Ein leeres Dashboard ohne Daten kann den Wert des Produkts nicht demonstrieren. Mit einem Datengenerierungstool erstellt der Manager schnell Tausende von Zeilen realistisch aussehender Verkaufsdaten, Nutzerinteraktionsmetriken und Lagerbestände. Diese Mock-Daten werden verwendet, um die Diagramme und Tabellen des Dashboards zu füllen und eine überzeugende und dynamische Demonstration zu schaffen. Es ermöglicht den Stakeholdern, die Fähigkeiten des Produkts sofort zu erfassen und sich vorzustellen, wie es mit ihren eigenen Daten funktionieren würde, was den Pitch weitaus effektiver macht.

5

Realistische Mock-API-Antworten generieren

Ein Frontend-Entwicklungsteam erstellt eine mobile App, die von einer Backend-API abhängt, aber die API ist noch nicht fertiggestellt. Um Verzögerungen zu vermeiden, verwendet das Team ein Datengenerierungstool, um einen Mock-API-Server zu erstellen. Sie definieren die erwartete JSON-Struktur für verschiedene Endpunkte, wie z. B. Benutzerprofile oder Produktlisten. Das Tool füllt diese Struktur dann mit großen Mengen realistischer, vielfältiger Daten. Dies ermöglicht es dem Frontend-Team, die Benutzeroberfläche gegen eine funktionale, datenreiche Mock-API zu erstellen und zu testen, wodurch sichergestellt wird, dass die Entwicklung parallel verlaufen kann und Integrationsprobleme frühzeitig erkannt werden.

6

Vielfältige Datensätze zur Minderung von KI-Voreingenommenheit erstellen

Ein KI-Ethik-Team stellt fest, dass der Einstellungsalgorithmus ihres Unternehmens, der auf historischen Daten trainiert wurde, eine Voreingenommenheit gegenüber bestimmten demografischen Gruppen aufweist. Um dies zu korrigieren, verwenden sie ein Datengenerierungstool, um einen neuen, ausgewogenen Trainingsdatensatz zu erstellen. Das Tool wird so konfiguriert, dass es synthetische Kandidatenprofile generiert, die die Repräsentation unterrepräsentierter Gruppen erhöhen, während realistische Qualifikations- und Erfahrungsverteilungen beibehalten werden. Durch das erneute Training des Algorithmus mit diesem erweiterten und entzerrten Datensatz kann das Team die algorithmische Voreingenommenheit erheblich reduzieren und fairere Einstellungsergebnisse fördern, wodurch die Leistung der KI mit den Diversitäts- und Inklusionszielen des Unternehmens in Einklang gebracht wird.

Datengenerierung FAQ

Was sind KI-Datengenerierungstools?

KI-Datengenerierungstools sind Anwendungen, die künstliche Intelligenz, insbesondere generative Modelle, verwenden, um neue, synthetische Daten von Grund auf zu erstellen. Im Gegensatz zu einfachen Zufallsdatengeneratoren lernen diese Tools die statistischen Muster, Verteilungen und Korrelationen aus realen Daten, um künstliche Datensätze zu erzeugen, die sehr realistisch und strukturell solide sind. Sie werden hauptsächlich verwendet, um Testdaten für Software zu erstellen, maschinelle Lernmodelle zu trainieren, wenn reale Daten sensibel oder knapp sind, und datenschutzsichere Datensätze für Forschung und Analyse zu generieren.

Wie wählt man das richtige Datengenerierungstool aus?

Die Wahl des richtigen Tools hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie die folgenden Faktoren:

  • Unterstützung von Datentypen: Stellen Sie sicher, dass das Tool das von Ihnen benötigte Format generieren kann, z. B. tabellarische Daten (CSV, SQL), Text, Bilder oder Zeitreihendaten.
  • Datentreue: Bewerten Sie, wie gut die synthetischen Daten die statistischen Eigenschaften und Korrelationen der realen Daten beibehalten. Einige Tools bieten Berichte zur Messung dieser Qualität.
  • Skalierbarkeit: Stellen Sie fest, ob das Tool die von Ihnen benötigte Datenmenge in angemessener Zeit generieren kann.
  • Datenschutzgarantien: Wenn Sie mit sensiblen Informationen umgehen, suchen Sie nach Tools, die formale Datenschutzmethoden wie Differential Privacy anbieten.
  • Benutzerfreundlichkeit: Wählen Sie zwischen No-Code-Plattformen für eine schnelle Generierung oder Bibliotheken (z. B. für Python), die Entwicklern mehr Kontrolle bieten.
Was ist der Unterschied zwischen Datengenerierung und Datenerweiterung?

Obwohl sie verwandt sind, dienen sie unterschiedlichen Zwecken. Die Datengenerierung erstellt völlig neue, synthetische Daten von Grund auf, oft basierend auf statistischen Modellen, die aus realen Daten gelernt wurden. Sie wird verwendet, wenn Sie einen vollständigen Datensatz benötigen, zum Beispiel zum Testen oder wenn keine realen Daten verfügbar sind. Die Datenerweiterung hingegen beginnt mit einem bestehenden Datensatz und erstellt kleine, modifizierte Kopien der Datenpunkte, um dessen Größe und Vielfalt zu erhöhen. Zum Beispiel das Drehen eines Bildes oder das Paraphrasieren eines Satzes. Kurz gesagt, die Generierung erstellt einen neuen Datensatz, während die Erweiterung einen bestehenden vergrößert.

Sind synthetische Daten so gut wie echte Daten?

Hochwertige synthetische Daten können äußerst effektiv und in einigen Fällen sogar besser als echte Daten sein. Sie zeichnen sich dadurch aus, dass sie die statistischen Muster und Beziehungen eines realen Datensatzes erfassen, was sie für das Training von maschinellen Lernmodellen und Softwaretests sehr geeignet macht. Ihre Hauptvorteile sind, dass sie datenschutzsicher sind, bei Bedarf in großen Mengen generiert werden können und zur Korrektur von Verzerrungen oder Ungleichgewichten in realen Daten verwendet werden können. Sie erfassen jedoch möglicherweise nicht jede seltene Anomalie oder jeden Ausreißer aus dem ursprünglichen Datensatz. Die Qualität hängt letztendlich von der Komplexität des Generierungsmodells und dem spezifischen Anwendungsfall ab.

Wer sind die Hauptnutzer von Datengenerierungstools?

Datengenerierungstools dienen einer Vielzahl von Fachleuten in der Technologiebranche. Zu den Hauptnutzern gehören:

  • Softwareentwickler und QS-Ingenieure: Sie verwenden diese Tools, um realistische Mock-Daten zum Testen von Anwendungen, APIs und Datenbanken zu erstellen, ohne auf Produktionsdaten angewiesen zu sein.
  • Datenwissenschaftler und Ingenieure für maschinelles Lernen: Sie nutzen synthetische Daten, um KI-Modelle zu trainieren und zu validieren, insbesondere wenn reale Daten begrenzt, unausgewogen oder sensibel sind.
  • Datenanalysten und Business-Intelligence-Experten: Sie verwenden generierte Daten, um Dashboards und Berichte zu Demonstrationszwecken zu füllen oder Szenarien zu untersuchen, ohne Live-Daten zu beeinträchtigen.
  • Datenschutz- und Sicherheitsbeauftragte: Sie verwenden diese Tools, um anonymisierte Versionen von Datensätzen für die sichere Weitergabe und Analyse zu erstellen.