
ToolMage
Anmelden

Best 1 Sprachausgabe AI tools for Produktivität

Popular Sprachausgabe AI tools in Produktivität include AITalk, helping you work more efficiently.

AITalk
Freemium

AITalk

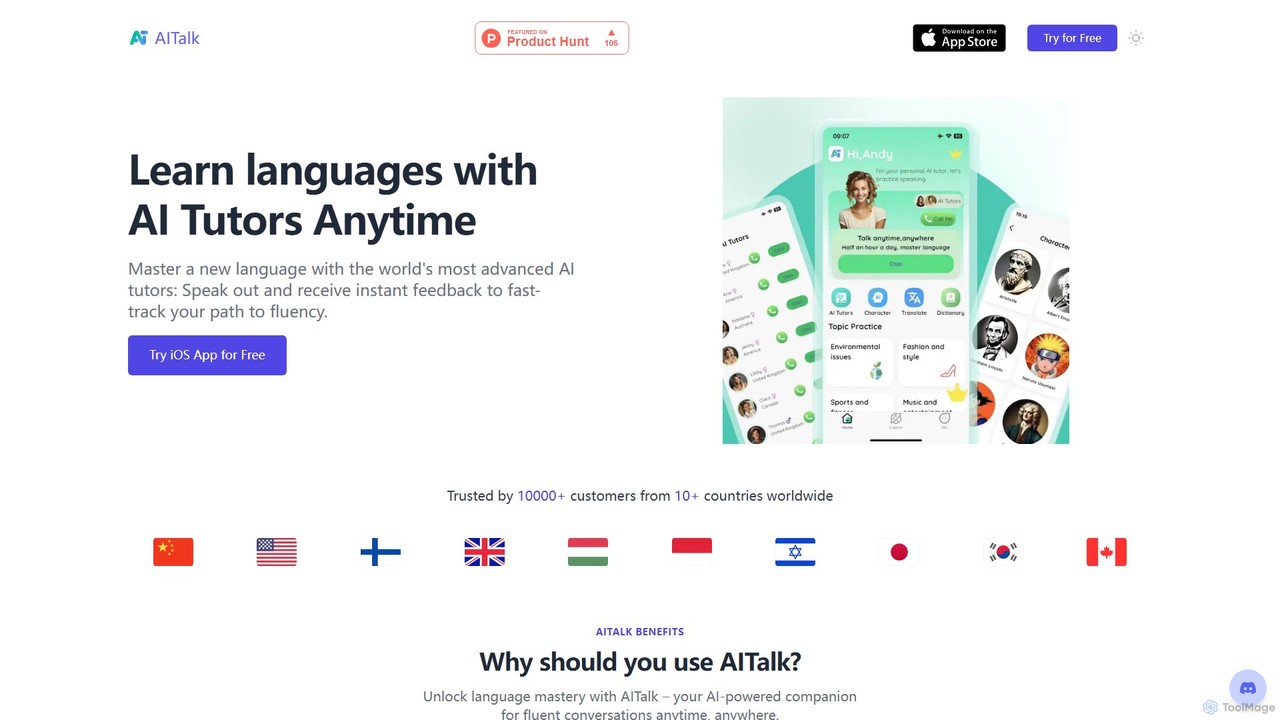
AITalk ist eine KI-gestützte Sprachlern-App, die Ihnen hilft, neue Sprachen durch Konversation zu meistern. Üben Sie das Sprechen jederzeit und überall mit fortschrittlichen KI-Tutoren und erhalten Sie sofortiges Feedback, um Ihren Weg zur Sprachgewandtheit zu beschleunigen. Es enthält auch Werkzeuge zur IELTS-Vorbereitung und Schreibunterstützung.

Sprachenlernen
Visits 11.5KFavorites 215Likes 189

About Sprachausgabe

KI-Sprachausgabe-Tools sind eine Klasse von Software, die geschriebenen Text in natürlich klingende, menschenähnliche Sprache umwandelt. Durch den Einsatz fortschrittlicher Text-to-Speech (TTS)- und Sprachsynthesetechnologien können diese Tools hochwertige Audioinhalte in verschiedenen Sprachen, Akzenten und emotionalen Tönen erzeugen. Ihr Hauptwert liegt in der Automatisierung der Erstellung von Audioinhalten, der Verbesserung der Zugänglichkeit digitaler Inhalte und der Bereitstellung skalierbarer Sprachlösungen für Anwendungen. Dies macht sie zu einem leistungsstarken Werkzeug in der Kategorie Produktivität für Kreative und Entwickler, die Arbeitsabläufe in der Sprachproduktion optimieren möchten.

Kernfunktionen

  • Text-to-Speech (TTS)-Synthese: Wandelt Texteingaben in hochauflösendes gesprochenes Audio mit natürlicher Intonation um.
  • Stimmklonung: Erstellt eine digitale Nachbildung einer bestimmten Stimme aus einer kleinen Audio-Probe für konsistentes Branding oder Personalisierung.
  • Unterstützung für mehrere Sprachen & Akzente: Erzeugt Sprache in Dutzenden von Sprachen und regionalen Akzenten und ermöglicht so eine globale Inhaltsverteilung.
  • Prosodie- & Stilsteuerung: Ermöglicht die Feinabstimmung von Sprachmerkmalen wie Tonhöhe, Geschwindigkeit, Lautstärke und emotionalem Ton (z.B. fröhlich, traurig, wütend).
  • API-Zugang: Bietet programmatischen Zugriff für Entwickler, um Echtzeit-Spracherzeugung in ihre eigenen Anwendungen und Dienste zu integrieren.

Anwendungsfälle

Diese Tools werden häufig von Content-Erstellern zur Erzeugung von Voice-Overs für Videos, Podcasts und E-Learning-Module verwendet. Im Marketing produzieren sie Audio für Werbung und Unternehmenspräsentationen. Entwickler integrieren sie auch in Anwendungen, um Sprachassistenten, IVR-Systeme und Barrierefreiheitsfunktionen zu erstellen, die Bildschirmtexte für sehbehinderte Benutzer vorlesen.

Wie man wählt

Bei der Auswahl eines KI-Sprachausgabe-Tools bewerten Sie die Natürlichkeit und Qualität der erzeugten Stimmen. Berücksichtigen Sie die Breite der Sprach- und Akzentbibliothek, um sicherzustellen, dass sie den Bedürfnissen Ihrer Zielgruppe entspricht. Beurteilen Sie den Grad der verfügbaren Anpassungsmöglichkeiten für Stimmmerkmale. Für Entwickler ist die Qualität der API-Dokumentation und des Integrationssupports entscheidend, während alle Benutzer die Preismodelle vergleichen sollten, die oft auf der Zeichenanzahl oder Abonnementstufen basieren.

Sprachausgabe use cases

1

Voice-Overs für Videoinhalte erstellen

Ein Content-Ersteller produziert Bildungsvideos für YouTube. Anstatt Stunden damit zu verbringen, seine eigene Stimme aufzunehmen und zu bearbeiten, die möglicherweise an Konsistenz mangelt, verwendet er ein KI-Sprachausgabe-Tool. Er fügt das Videoskript in das Tool ein, wählt eine professionelle und klar klingende Stimme aus und passt das Tempo an die visuellen Darstellungen auf dem Bildschirm an. Das Tool generiert in wenigen Minuten eine hochwertige Audiodatei. Dieser Prozess spart nicht nur erheblich Produktionszeit, sondern ermöglicht es ihm auch, durch einfache Auswahl einer anderen Stimme Versionen des Videos in verschiedenen Sprachen wie Spanisch oder Deutsch zu produzieren und so seine internationale Reichweite zu vergrößern.

2

Hörbücher aus digitalen Texten erstellen

Ein unabhängiger Autor möchte sein veröffentlichtes E-Book in ein Hörbuch umwandeln, um ein breiteres Publikum zu erreichen. Die Beauftragung eines professionellen Sprechers und eines Aufnahmestudios ist kostspielig und zeitaufwändig. Stattdessen nutzt er eine KI-Sprachausgabe-Plattform. Er lädt sein Manuskript kapitelweise hoch, wählt eine Stimme, die zum Ton des Buches passt (z. B. eine warme, erzählende Stimme für Belletristik), und generiert die Audiodateien. Die fortschrittlichen Funktionen der Plattform ermöglichen es ihm, die Aussprache bestimmter Namen oder Begriffe zu korrigieren und so die Genauigkeit zu gewährleisten. Das Ergebnis ist ein professionell produziertes Hörbuch, das zu einem Bruchteil der herkömmlichen Kosten und Zeit erstellt wurde.

3

Interaktive Sprachdialogsysteme (IVR) entwickeln

Ein Softwareentwicklungsteam erstellt ein Kundenservice-IVR für ein großes E-Commerce-Unternehmen. Sie benötigen ein System, das dynamische, natürlich klingende Antworten liefert, wie z. B. Bestellstatus-Updates und personalisierte Begrüßungen. Mithilfe der API eines KI-Sprachausgabe-Tools können sie diese Sprachansagen in Echtzeit generieren. Wenn ein Kunde anruft, fragt das System die Datenbank nach seinen Bestellinformationen ab, erstellt eine Textantwort wie „Hallo Jane, Ihre Bestellung 12345 wurde versandt und wird morgen ankommen“ und sendet sie an die API. Die API gibt sofort einen hochwertigen Audiostream zurück und schafft so ein reibungsloses und professionelles Kundenerlebnis, das traditionellen, roboterhaften IVR-Systemen weit überlegen ist.

4

Zugänglichkeit von E-Learning-Inhalten verbessern

Ein Instruktionsdesigner an einer Universität erstellt einen Online-Kurs. Um den Barrierefreiheitsstandards zu entsprechen und verschiedenen Lernstilen gerecht zu werden, muss er eine Audioversion aller textbasierten Materialien bereitstellen. Alles manuell aufzunehmen wäre unpraktisch. Er verwendet ein KI-Sprachausgabe-Tool, um Vorlesungsnotizen, Lesematerialien und Quizfragen in Audiodateien umzuwandeln. Er wählt eine ruhige und deutliche Stimme, um Klarheit zu gewährleisten. Studenten können nun die Kursmaterialien während des Pendelns oder beim Sport anhören, und es bietet eine entscheidende Alternative für Studenten mit Sehbehinderungen oder Leseschwächen wie Legasthenie. Dies verbessert das gesamte Lernerlebnis und die Inklusivität des Kurses.

5

Charakterstimmen für Spiele und Animationen prototypisieren

Ein Indie-Spieleentwicklungsstudio befindet sich in der Anfangsphase der Erstellung eines neuen Rollenspiels mit vielen Charakteren. Bevor sie sich dazu verpflichten, teure Synchronsprecher zu engagieren, müssen die Autoren und Designer hören, wie der Dialog klingt. Sie verwenden ein KI-Sprachausgabe-Tool mit einer breiten Palette von Stimmstilen. Sie können schnell Zeilen für einen schroffen Krieger, einen weisen alten Zauberer und einen fröhlichen Ladenbesitzer generieren, indem sie Tonhöhe, Geschwindigkeit und emotionalen Ton anpassen. Dies ermöglicht es dem Team, das Skript und die Charakterpersönlichkeiten schnell zu überarbeiten, den Dialog im Spiel zu testen und ein viel überzeugenderes Casting-Briefing zu erstellen, wenn sie schließlich bereit sind, menschliche Schauspieler zu engagieren.

6

Öffentliche Durchsagen und Sendungen automatisieren

Eine öffentliche Verkehrsbehörde muss in ihrem Netzwerk von Bahnhöfen und Bussen klare Echtzeit-Durchsagen bereitstellen. Jede mögliche Verspätung, Routenänderung oder Sicherheitsmeldung manuell aufzuzeichnen, ist unmöglich. Sie integrieren eine KI-Sprachausgabe-API in ihr zentrales Steuerungssystem. Bei einer Service-Aktualisierung generiert das System automatisch eine Textnachricht (z. B. „Achtung Fahrgäste, der Zug um 15:15 Uhr zum Hauptbahnhof hat 10 Minuten Verspätung.“) und sendet sie an die API. Die API wandelt dies in eine klare, standardisierte Sprachdurchsage um, die sofort an den relevanten Bahnhöfen ausgestrahlt wird. Dies gewährleistet eine rechtzeitige, konsistente und mehrsprachige Kommunikation mit den Fahrgästen und verbessert die Sicherheit und Kundenzufriedenheit.

Sprachausgabe FAQ

Was sind KI-Sprachausgabe-Tools?

KI-Sprachausgabe-Tools, auch als fortschrittliche Text-to-Speech (TTS)- oder Sprachsynthese-Software bekannt, sind Anwendungen, die künstliche Intelligenz verwenden, um geschriebenen Text in hörbare, menschenähnliche Sprache umzuwandeln. Im Gegensatz zu traditionellem, roboterhaft klingendem TTS nutzen diese Tools Deep Learning, um Stimmen mit natürlicher Intonation, Emotion und Rhythmus zu erzeugen. Zu den Hauptmerkmalen gehören oft eine große Vielfalt an Stimmen, mehrsprachige Unterstützung, Funktionen zur Stimmklonung und die Möglichkeit, Sprachmerkmale wie Tonhöhe und Geschwindigkeit zu steuern. Sie werden hauptsächlich zur Automatisierung der Erstellung von Audioinhalten für Videos, Podcasts, Barrierefreiheit und Anwendungen eingesetzt.

Wie wählt man das richtige KI-Sprachausgabe-Tool aus?

Die Wahl des richtigen KI-Sprachausgabe-Tools hängt von Ihren spezifischen Anforderungen ab. Berücksichtigen Sie die folgenden Faktoren:

  • Stimmqualität und Natürlichkeit: Hören Sie sich Beispiele an. Klingt die Stimme menschenähnlich und ansprechend oder roboterhaft? Dies ist der kritischste Faktor für die meisten Anwendungsfälle.
  • Sprach- und Akzentvielfalt: Stellen Sie sicher, dass das Tool die Sprachen und regionalen Akzente Ihrer Zielgruppe unterstützt.
  • Anpassungsoptionen: Prüfen Sie, ob Sie Tonhöhe, Geschwindigkeit, Pausen und emotionalen Ton steuern können, um sie an den Kontext Ihres Inhalts anzupassen.
  • Stimmklonung: Wenn Sie eine konsistente, markengerechte Stimme benötigen oder Ihre eigene verwenden möchten, suchen Sie nach einem Tool mit hochwertigen Funktionen zum Klonen von Stimmen.
  • API-Zugang und Dokumentation: Für Entwickler ist eine gut dokumentierte, zuverlässige API für die Integration des Dienstes in Anwendungen unerlässlich.
  • Preismodell: Vergleichen Sie die Kosten, die auf einem monatlichen Abonnement, einer Bezahlung pro Zeichen oder gestaffelten Plänen basieren können. Wählen Sie ein Modell, das Ihrer erwarteten Nutzung entspricht.
Was ist der Unterschied zwischen KI-Sprachausgabe-Tools und Standard-Text-to-Speech (TTS)?

Der Hauptunterschied liegt in der Qualität und Natürlichkeit der Ausgabe. Standard-TTS-Systeme klingen oft roboterhaft und monoton, da sie auf älteren, konkatenativen Synthesemethoden basieren, die vorab aufgezeichnete Klangfragmente zusammensetzen. KI-Sprachausgabe-Tools hingegen verwenden neuronale Netze und Deep Learning (generative Synthese). Dies ermöglicht es ihnen, Sprache von Grund auf zu generieren und menschliche Sprachmuster zu modellieren, einschließlich subtiler Variationen in Tonhöhe, Rhythmus und Betonung. Infolgedessen sind KI-Stimmen deutlich menschenähnlicher, ausdrucksstärker und in der Lage, Emotionen zu vermitteln, was sie für eine viel breitere Palette von Anwendungen wie Hörbücher und Charakter-Voice-Overs geeignet macht.

Ist die Verwendung von KI-Stimmklonung legal und ethisch?

Die Legalität und Ethik der KI-Stimmklonung sind komplex und entwickeln sich ständig weiter. Im Allgemeinen ist es legal und ethisch, Ihre eigene Stimme oder die Stimme von jemandem zu klonen, der Ihnen eine ausdrückliche, informierte Zustimmung für einen bestimmten Zweck gegeben hat. Die Verwendung von Stimmklonung, um sich ohne Erlaubnis für böswillige Zwecke als jemand auszugeben, wie z. B. die Erstellung von Deepfake-Audio, die Verbreitung von Fehlinformationen oder die Begehung von Betrug, ist jedoch in vielen Rechtsordnungen illegal und wird weithin als unethisch angesehen. Seriöse KI-Sprachausgabe-Tools haben strenge Richtlinien, die von den Benutzern verlangen, zu bestätigen, dass sie die erforderlichen Rechte und die Zustimmung haben, bevor sie eine Stimme klonen. Priorisieren Sie bei der Verwendung dieser Technologie immer Transparenz und Zustimmung.

Können KI-Sprachausgabe-Tools Emotionen vermitteln?

Ja, viele fortschrittliche KI-Sprachausgabe-Tools können eine Reihe von Emotionen vermitteln. Sie erreichen dies durch Funktionen, die es den Benutzern ermöglichen, die Prosodie zu steuern – die Muster von Betonung, Intonation und Rhythmus in der Sprache. Benutzer können oft einen allgemeinen emotionalen Stil auswählen (z. B. „glücklich“, „traurig“, „wütend“, „aufgeregt“) oder spezifische Parameter wie Tonhöhenvariation und Sprechgeschwindigkeit feinabstimmen. Obwohl sie möglicherweise noch nicht die volle Nuance menschlichen emotionalen Ausdrucks erfassen, können moderne KI-Stimmen Audioinhalten effektiv eine emotionale Ebene hinzufügen, was sie für Storytelling, Marketing und Charakterdialoge ansprechender und kontextuell angemessener macht.