
ToolMage
Anmelden

Best 1 Spracherkennung AI tools for Produktivität

Popular Spracherkennung AI tools in Produktivität include Audio2Text AI, helping you work more efficiently.

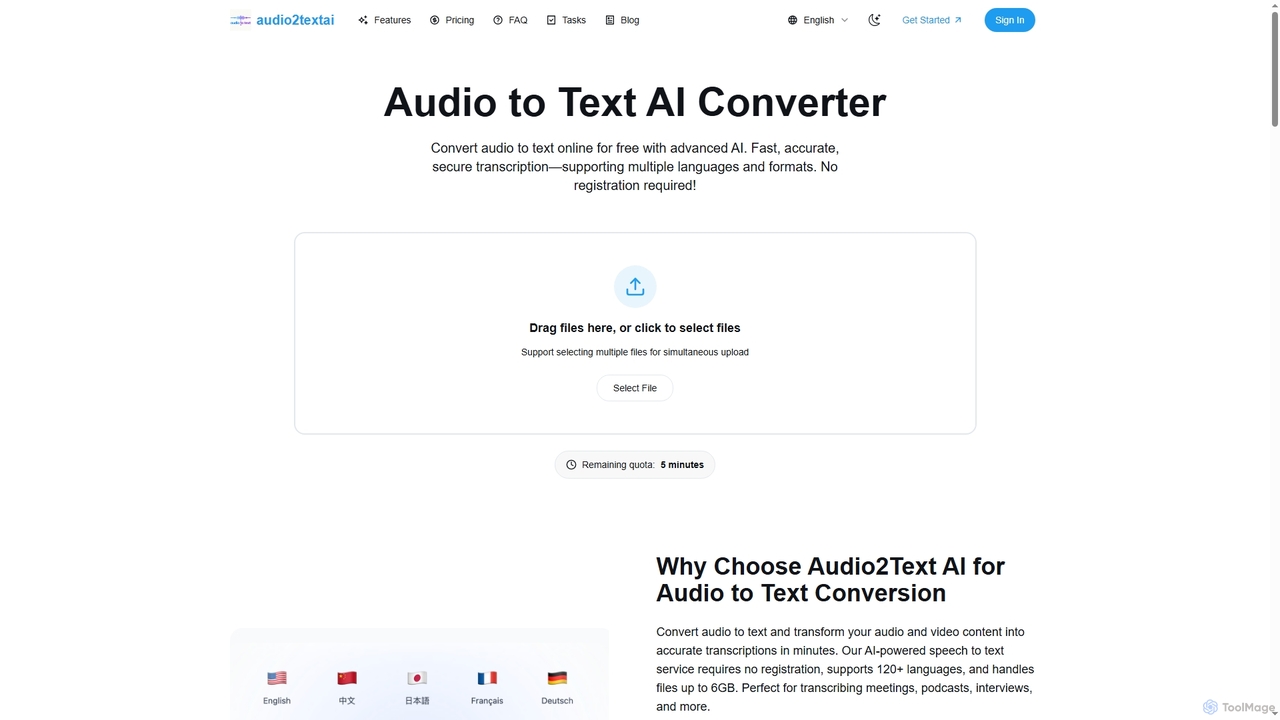
Audio2Text AI
Freemium

Audio2Text AI

Audio2Text AI ist ein fortschrittlicher Online-KI-Konverter, der Audio- und Videodateien schnell und sicher in genaue Texttranskriptionen umwandelt. Er unterstützt über 120 Sprachen und 21 Medienformate und bietet eine Genauigkeit auf Unternehmensniveau mit Sprecheridentifikation und Zeitstempeln, alles ohne Registrierung für eine kostenlose 5-minütige Testversion.

Besprechungsmanagement
Visits 10.7KFavorites 157Likes 175

About Spracherkennung

Spracherkennungstools sind eine Klasse von KI-Software, die gesprochene Sprache automatisch in geschriebenen Text umwandelt. Diese Tools verwenden fortschrittliche maschinelle Lernmodelle, um Audiosignale zu analysieren und Wörter und Sätze zu identifizieren, ein Prozess, der auch als Automatische Spracherkennung (ASR) bekannt ist. Ihr Hauptwert liegt in der Automatisierung der Transkription, der Ermöglichung sprachgesteuerter Schnittstellen und der Durchsuchbarkeit von Audio- oder Videoinhalten, was die Produktivität erheblich steigert. Viele moderne Systeme bieten auch Funktionen wie Sprecheridentifikation und Unterstützung für mehrere Sprachen und Dialekte.

Kernfunktionen

  • Echtzeit-Transkription: Wandelt Live-Audioströme wie Besprechungen oder Übertragungen sofort in Text um.
  • Sprecher-Diarisierung: Identifiziert und kennzeichnet verschiedene Sprecher innerhalb einer einzigen Audioaufnahme.
  • Benutzerdefiniertes Vokabular: Ermöglicht Benutzern das Hinzufügen von spezifischem Branchenjargon, Namen oder Akronymen zur Verbesserung der Erkennungsgenauigkeit.
  • Zeitstempelung: Ordnet jedes transkribierte Wort seiner genauen Zeit im ursprünglichen Audio- oder Videofile zu.
  • Mehrsprachige Unterstützung: Erkennt und transkribiert Sprache aus einer Vielzahl von Sprachen und Akzenten.

Anwendungsfälle

Diese Tools werden branchenübergreifend eingesetzt. Journalisten und Forscher verwenden sie zur Transkription von Interviews, während Unternehmen sie zur Erstellung von Besprechungsprotokollen nutzen. In der Medienproduktion sind sie für die Erstellung von Untertiteln unerlässlich. Entwickler integrieren auch Spracherkennungs-APIs, um sprachaktivierte Anwendungen und Dienste für eine verbesserte Zugänglichkeit und Benutzererfahrung zu erstellen.

Wie man wählt

Bei der Auswahl eines Spracherkennungstools bewerten Sie dessen Genauigkeit, insbesondere bei bestimmten Akzenten oder in lauten Umgebungen. Berücksichtigen Sie die Bandbreite der unterstützten Sprachen und Dialekte, die Sie benötigen. Beurteilen Sie, ob Sie Echtzeitverarbeitung oder Batch-Transkription von vorab aufgezeichneten Dateien benötigen. Überprüfen Sie schließlich die API-Verfügbarkeit für die Integration in Ihre bestehenden Arbeitsabläufe und prüfen Sie die Datenschutz- und Sicherheitsrichtlinien des Anbieters.

Spracherkennung use cases

1

Automatisierung von Besprechungsprotokollen und Aktionspunkten

Für Projektmanager und Teamleiter ist das manuelle Mitschreiben während Besprechungen zeitaufwändig und fehleranfällig. Durch den Einsatz eines Spracherkennungstools können sie die gesamte Besprechung aufzeichnen und anschließend ein vollständiges, durchsuchbares Transkript erhalten. Fortgeschrittene Tools mit Sprecher-Diarisierung identifizieren automatisch, wer was gesagt hat, was die Zuweisung von Aktionspunkten und das Nachvollziehen wichtiger Entscheidungen erleichtert. Dieser Prozess verwandelt eine einstündige Besprechung von stundenlanger Nacharbeit in wenige Minuten Überprüfung und gewährleistet Genauigkeit und Verantwortlichkeit.

2

Erstellung barrierefreier Video-Untertitel und Captions

Content-Ersteller und Marketing-Teams müssen ihre Videoinhalte für ein breiteres Publikum zugänglich und ansprechend gestalten, einschließlich gehörloser oder schwerhöriger Personen oder solcher, die Videos ohne Ton ansehen. Ein Spracherkennungstool kann das Audio aus einer Videodatei automatisch transkribieren und ein zeitgestempeltes Transkript erstellen. Dieses Transkript kann dann einfach in Standard-Untertitelformate wie SRT oder VTT konvertiert und zusammen mit dem Video hochgeladen werden. Dies verbessert nicht nur die Barrierefreiheit, sondern steigert auch die Video-SEO, indem der Inhalt für Suchmaschinen indexierbar wird.

3

Transkription von Forschungsinterviews für die qualitative Analyse

Akademische Forscher, Journalisten und Marktanalysten führen oft stundenlange Interviews, die für die Analyse transkribiert werden müssen. Die manuelle Transkription ist unglaublich langsam und teuer. Durch das Hochladen von Audioaufnahmen in einen Spracherkennungsdienst können sie in einem Bruchteil der Zeit eine Textversion erhalten. Dies ermöglicht es ihnen, schnell nach Schlüsselwörtern zu suchen, Themen zu identifizieren und Teilnehmer in ihren Berichten oder Artikeln genau zu zitieren. Die eingesparte Zeit kann in höherwertige Aufgaben wie Datenanalyse und -interpretation umgeleitet werden, was den gesamten Forschungszyklus beschleunigt.

4

Freihändiges Diktieren für professionelle Dokumentation

Berufsgruppen wie Ärzte, Anwälte und Autoren müssen oft große Mengen an textbasierten Berichten, Notizen oder Manuskripten erstellen. Das Tippen kann ein Engpass sein. Spracherkennungssoftware ermöglicht es ihnen, ihre Gedanken direkt in ein Dokument, eine E-Mail oder eine spezialisierte Software (wie ein elektronisches Patientenaktensystem) zu diktieren. Diese freihändige Methode kann erheblich schneller sein als das Tippen und ermöglicht einen natürlicheren Gedankenfluss. Benutzerdefinierte Vokabulare sind hier besonders nützlich, da sie dem Tool ermöglichen, komplexe medizinische oder juristische Terminologie genau zu erkennen.

5

Analyse von Kundensupport-Anrufen zur Gewinnung von Erkenntnissen

Für Callcenter-Manager und Qualitätssicherungsteams ist das manuelle Anhören von Support-Anrufen zur Identifizierung von Trends ineffizient. Durch den Einsatz eines Spracherkennungstools zur Transkription aller eingehenden und ausgehenden Anrufe können Unternehmen eine durchsuchbare Datenbank von Kundeninteraktionen erstellen. Diese Textdaten können dann analysiert werden, um wiederkehrende Probleme zu erkennen, die Kundenstimmung zu messen, die Einhaltung von Agentenskripten zu überprüfen und Schulungsmöglichkeiten zu identifizieren. Dieser datengesteuerte Ansatz hilft Unternehmen, den Kundenservice zu verbessern, die Abwanderung zu reduzieren und die Produktentwicklung auf der Grundlage von direktem Feedback zu verbessern.

6

Entwicklung sprachgesteuerter Anwendungen und Geräte

Softwareentwickler und Hardware-Ingenieure verwenden Spracherkennungs-APIs, um sprachgesteuerte Produkte zu entwickeln. Dazu gehört die Erstellung von Sprachbenutzeroberflächen (VUIs) für mobile Apps, Smart-Home-Geräte, Infotainmentsysteme im Auto und Barrierefreiheitssoftware für Benutzer mit Behinderungen. Durch die Integration einer leistungsstarken ASR-Engine können sich Entwickler auf ihre Kernanwendungslogik konzentrieren, anstatt komplexe Sprachverarbeitungstechnologie von Grund auf neu zu entwickeln. Dies ermöglicht eine schnellere Entwicklung innovativer, freihändiger Erlebnisse, die Technologie für alle intuitiver und zugänglicher machen.

Spracherkennung FAQ

Was sind Spracherkennungstools?

Spracherkennungstools, auch als Automatische Spracherkennungssoftware (ASR) bekannt, sind Anwendungen, die menschliche Sprache in geschriebenen Text umwandeln. Sie verwenden künstliche Intelligenz und maschinelles Lernen, um Audio zu verarbeiten, phonetische Laute zu identifizieren und sie zu Wörtern und Sätzen zusammenzusetzen. Zu den Hauptmerkmalen gehören oft Echtzeit-Transkription, Sprecheridentifikation und die Unterstützung verschiedener Sprachen und Dialekte. Sie werden häufig eingesetzt, um die Transkription zu automatisieren, Sprachbefehle zu ermöglichen und Audioinhalte durchsuchbar zu machen.

Wie wählt man das richtige Spracherkennungstool aus?

Um das richtige Tool auszuwählen, berücksichtigen Sie diese Faktoren:

  • Genauigkeit: Überprüfen Sie die Leistung bei Ihrem spezifischen Akzent, Branchenjargon oder unter lauten Bedingungen. Suchen Sie nach Tools mit benutzerdefinierten Vokabularfunktionen.
  • Sprachunterstützung: Stellen Sie sicher, dass alle Sprachen und Dialekte unterstützt werden, die Sie verarbeiten müssen.
  • Echtzeit vs. Batch: Entscheiden Sie, ob Sie eine sofortige Transkription für Live-Events benötigen oder ob Sie vorab aufgezeichnete Dateien verarbeiten.
  • Integration (API): Wenn Sie es in Ihre eigene Software integrieren müssen, prüfen Sie, ob eine gut dokumentierte und robuste API vorhanden ist.
  • Sicherheit und Datenschutz: Verstehen Sie, wie Ihre Audiodaten gespeichert, verarbeitet und geschützt werden, insbesondere bei sensiblen Informationen.
Was ist der Unterschied zwischen Spracherkennung und Sprechererkennung?

Obwohl sie oft synonym verwendet werden, beziehen sie sich auf unterschiedliche Technologien. Die Spracherkennung konzentriert sich darauf zu verstehen, was gesagt wird – sie wandelt gesprochene Worte in Text um. Ihr Ziel ist die Transkription. Die Sprechererkennung konzentriert sich darauf zu identifizieren, wer spricht, indem sie einzigartige stimmliche Merkmale wie Tonhöhe und Klang analysiert. Ihr Ziel ist die Authentifizierung oder Identifizierung. Viele fortschrittliche Systeme kombinieren beides; zum Beispiel verwendet ein Tool zur Besprechungstranskription Spracherkennung, um die Worte aufzuschreiben, und Sprechererkennung, um zu kennzeichnen, wer sie gesagt hat.

Wer kann von der Verwendung von Spracherkennungssoftware profitieren?

Eine breite Palette von Benutzern kann von Spracherkennungssoftware profitieren. Content-Ersteller verwenden sie zur Untertitelung von Videos. Unternehmen und Fachleute nutzen sie zur Transkription von Besprechungen und zum Diktieren von Berichten, was erheblich Zeit spart. Forscher und Journalisten beschleunigen ihre Analyse, indem sie Interview-Audio schnell in Text umwandeln. Entwickler integrieren sie in Apps, um freihändige Benutzererlebnisse zu schaffen. Darüber hinaus ist sie eine entscheidende Hilfstechnologie für Personen mit körperlichen Behinderungen, die es ihnen ermöglicht, einfacher mit Computern zu interagieren und zu kommunizieren.

Wie genau sind moderne Spracherkennungssysteme?

Moderne Spracherkennungssysteme sind sehr genau geworden und erreichen unter idealen Bedingungen (z. B. klares Audio, minimale Hintergrundgeräusche, gängige Akzente) oft eine Genauigkeit von über 95 %. Dies ist mit der Genauigkeit menschlicher Transkription vergleichbar. Die Leistung kann jedoch bei starkem Hintergrundlärm, starken oder mehreren Akzenten, schnellem Sprechen oder hochspezialisierter Terminologie abnehmen. Viele führende Tools begegnen dem mit Funktionen wie benutzerdefinierten Vokabularen, die es den Benutzern ermöglichen, dem System spezifische Begriffe beizubringen, und der Anpassung des akustischen Modells für laute Umgebungen, was die Genauigkeit in realen Szenarien erheblich verbessert.