ToolMage
Anmelden

Best 2 Datenbank AI tools for Ressourcen

Popular Datenbank AI tools in Ressourcen include abcdindex und llm_price, helping you work more efficiently.

llm_price
Free

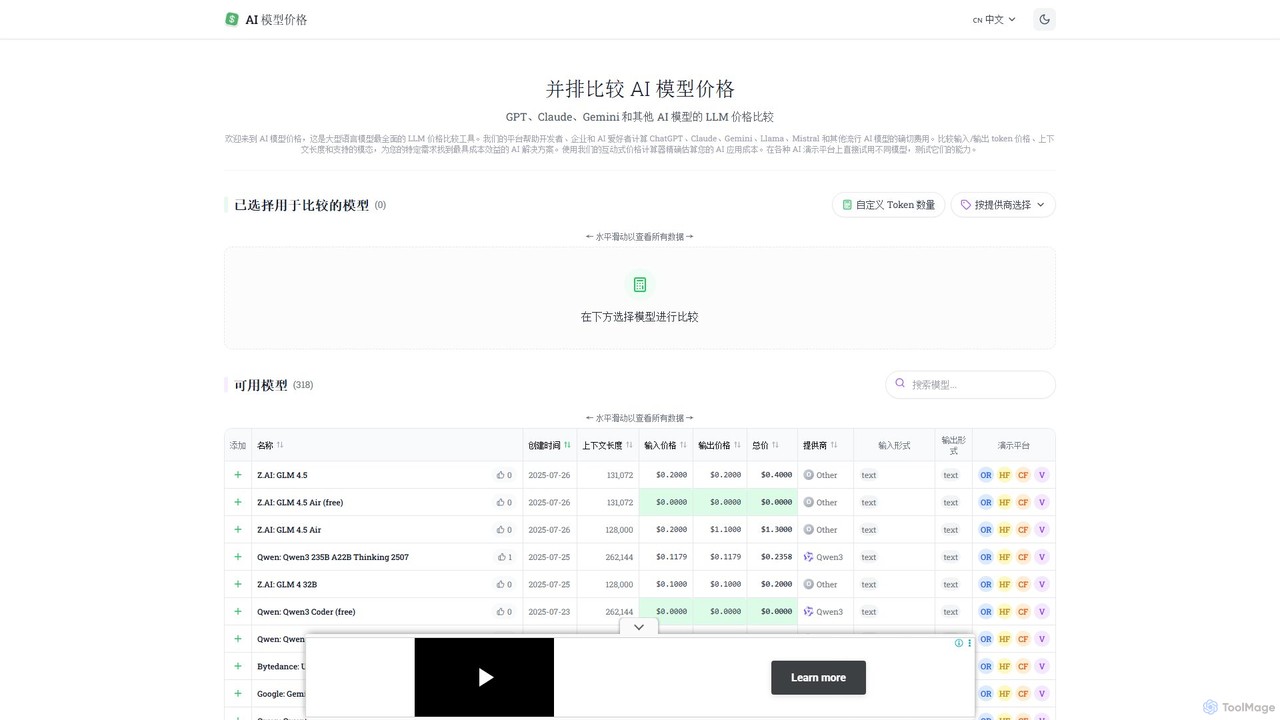
llm_price

llm_price ist ein umfassendes Vergleichstool für die API-Preise von Large Language Models (LLM). Es ermöglicht Entwicklern, Unternehmen und KI-Enthusiasten, die Kosten von Hunderten von Modellen von Anbietern wie OpenAI, Google, Anthropic und Mistral einfach zu vergleichen. Mit einem interaktiven Kostenrechner und einer Gegenüberstellung von Token-Preisen, Kontextlängen und Modalitäten vereinfacht es die Auswahl der kostengünstigsten KI-Lösung für jedes Projekt.

API-Management
Visits 13.1KFavorites 121Likes 136
abcdindex
Free

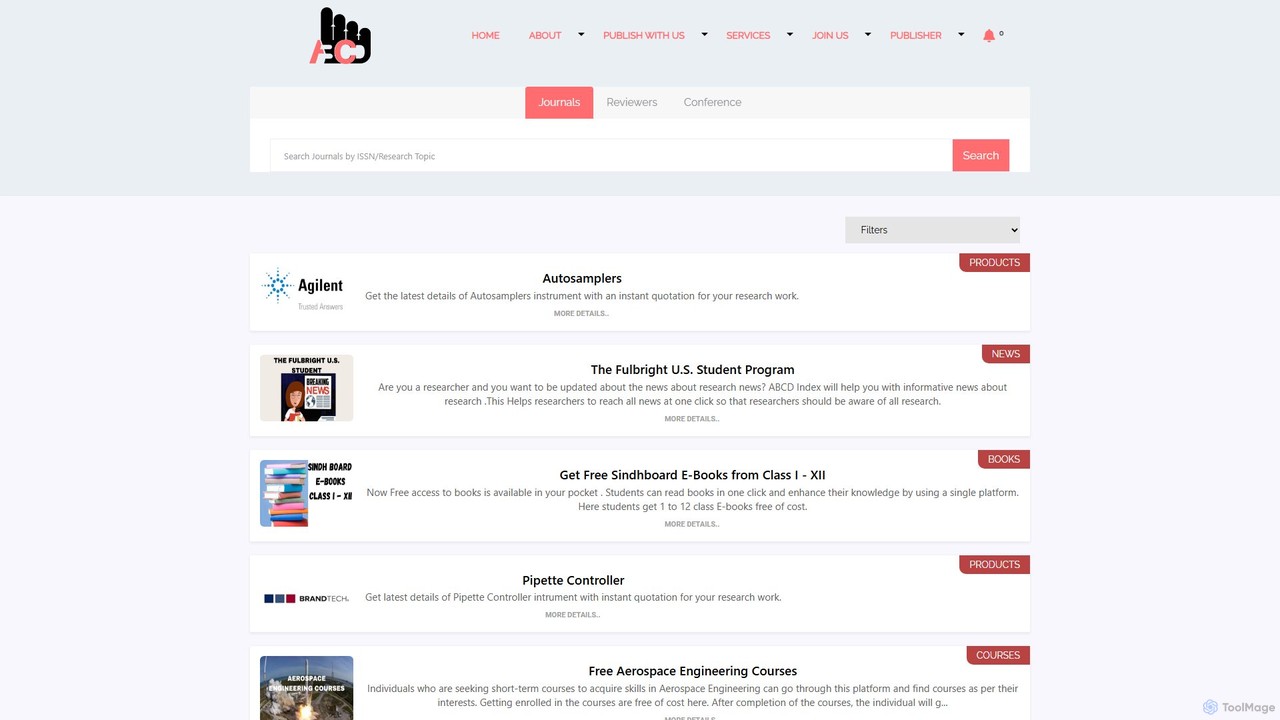
abcdindex

abcdindex (Academic Business Current Data Index) ist eine kostenlose, umfassende Plattform für die akademische Gemeinschaft. Sie bietet eine verifizierte und strukturierte Datenbank internationaler Fachzeitschriften, Forschungsartikel, Finanzierungsmöglichkeiten, Stipendien und anderer wissenschaftlicher Ressourcen. Die Plattform zielt darauf ab, Forschern, Studierenden und Verlagen zu helfen, sich effizient in der akademischen Landschaft zurechtzufinden und räuberische oder inaktive Publikationen durch zuverlässige, zentralisierte Informationen zu vermeiden.

Forschung
Visits 158KFavorites 164Likes 153

About Datenbank

KI-Datenbanken sind kuratierte Sammlungen strukturierter Daten, die als grundlegende Ressource für das Training, Testen und den Einsatz von Modellen der künstlichen Intelligenz dienen. Diese Ressourcen sind speziell für die maschinelle Verarbeitung vorbereitet und enthalten oft riesige Mengen an gelabelten oder ungelabelten Daten wie Bilder, Texte oder numerische Zahlen. Sie liefern das wesentliche Rohmaterial für maschinelles Lernen, die Verarbeitung natürlicher Sprache und Computer-Vision-Aufgaben. Die Qualität, der Umfang und die Relevanz dieser Datenbanken bestimmen direkt die Leistung und die Fähigkeiten eines KI-Systems.

Kernfunktionen

  • Strukturierte & gelabelte Daten: Die Daten sind organisiert und oft mit Labels versehen, was sie für überwachte Lernalgorithmen geeignet macht.
  • Großer Umfang: Enthalten typischerweise Millionen oder sogar Milliarden von Datenpunkten, um sicherzustellen, dass Modelle generalisierbare Muster lernen können.
  • Domänenspezifität: Fokussiert auf bestimmte Bereiche wie Medizin, Finanzen oder autonomes Fahren, um spezialisierte KI zu entwickeln.
  • Datenqualität & Konsistenz: Bereinigt und validiert, um Rauschen und Verzerrungen zu minimieren, was für die Erstellung zuverlässiger Modelle entscheidend ist.

Anwendungsfälle

KI-Datenbanken sind für Datenwissenschaftler, Ingenieure für maschinelles Lernen und Forscher unerlässlich. Sie werden verwendet, um Gesichtserkennungssysteme mit Bilddatensätzen zu trainieren, Sprachmodelle mit riesigen Textkorpora zu entwickeln und Betrugserkennungsalgorithmen aus historischen Transaktionsdaten zu erstellen. Akademische Einrichtungen verwenden auch standardisierte Datensätze, um die Leistung neuer KI-Algorithmen zu bewerten.

Wie man wählt

Bei der Auswahl einer KI-Datenbank sollten Sie deren Relevanz für Ihr spezifisches Problemfeld berücksichtigen. Bewerten Sie die Datenqualität, die Genauigkeit der Labels und das Vorhandensein potenzieller Verzerrungen. Überprüfen Sie die Lizenzbedingungen, um sicherzustellen, dass sie für Ihren beabsichtigten Zweck (z. B. akademisch vs. kommerziell) verwendet werden kann. Schließlich bewerten Sie das Datenformat und die Größe, um die Kompatibilität mit Ihren Rechenressourcen und Ihrer Toolchain zu bestätigen.

Datenbank use cases

1

Training eines Modells zur medizinischen Bildanalyse

Ein KI-Forscher im Gesundheitswesen muss ein Modell entwickeln, das frühe Anzeichen von Krankheiten aus medizinischen Scans wie Röntgenbildern oder MRTs erkennen kann. Sie verwenden eine spezialisierte, hochwertige Datenbank mit Tausenden von anonymisierten medizinischen Bildern, die jeweils sorgfältig von Radiologen annotiert wurden. Durch das Training eines Computer-Vision-Modells mit diesem Datensatz lernt das System, subtile Muster zu identifizieren, die mit bestimmten Zuständen verbunden sind. Das resultierende KI-Tool kann Radiologen unterstützen, indem es potenzielle Problembereiche hervorhebt, was zu schnelleren und genaueren Diagnosen führt.

2

Entwicklung eines Modells zur Verarbeitung natürlicher Sprache (NLP)

Ein Data-Science-Team hat die Aufgabe, ein Tool zur Stimmungsanalyse für Kundenbewertungen zu entwickeln. Um dies zu erreichen, nutzen sie eine große Textdatenbank, die Millionen von Produktbewertungen enthält, die jeweils als positiv, negativ oder neutral gekennzeichnet sind. Dieser Korpus dient als Ground Truth für das Training ihres NLP-Modells. Das Modell verarbeitet den Text, lernt die Nuancen der Sprache und identifiziert Muster, die mit unterschiedlichen Stimmungen korrelieren. Nach dem Training kann das Tool automatisch neue, ungesehene Bewertungen klassifizieren und dem Unternehmen wertvolle Einblicke in die Kundenzufriedenheit in großem Maßstab liefern.

3

Aufbau eines Systems zur Finanzbetrugserkennung

Ein Fintech-Unternehmen zielt darauf ab, betrügerische Transaktionen für seine Nutzer zu reduzieren. Ihre Ingenieure für maschinelles Lernen verwenden eine riesige, historische Datenbank mit Transaktionsdaten. Diese Datenbank enthält Merkmale wie Transaktionsbetrag, Zeit, Ort und Händlertyp, wobei jede Transaktion entweder als legitim oder betrügerisch gekennzeichnet ist. Durch das Training eines Anomalieerkennungsmodells mit diesen Daten lernt das System die Merkmale normalen Transaktionsverhaltens. Wenn eine neue Transaktion stattfindet, kann das Modell die Wahrscheinlichkeit, dass sie betrügerisch ist, in Echtzeit vorhersagen, was es dem Unternehmen ermöglicht, verdächtige Aktivitäten zu blockieren und seine Kunden zu schützen.

4

Benchmarking neuer KI-Algorithmen

Ein akademisches Forschungslabor entwickelt einen neuartigen Algorithmus zur Objekterkennung. Um seine Wirksamkeit zu beweisen, müssen sie seine Leistung mit bestehenden, hochmodernen Methoden vergleichen. Sie verwenden eine standardisierte, öffentliche Datenbank wie ImageNet oder COCO, die in der Forschungsgemeinschaft für Benchmarking weithin akzeptiert sind. Indem sie ihren neuen Algorithmus und etablierte Algorithmen auf demselben Datensatz ausführen, können sie objektive Metriken wie Genauigkeit und Verarbeitungsgeschwindigkeit erhalten. Dies ermöglicht es ihnen, ihre Ergebnisse mit überprüfbaren Resultaten zu veröffentlichen und so zum Fortschritt im Bereich der KI beizutragen.

5

Betrieb eines wissensbasierten F&A-Systems

Ein Legal-Tech-Unternehmen möchte einen KI-Assistenten erstellen, der komplexe rechtliche Fragen beantworten kann. Anstelle eines allgemeinen Textkorpus verwenden sie eine spezialisierte Wissensdatenbank – eine strukturierte Datenbank, die Gesetze, Rechtsprechung und wissenschaftliche Artikel enthält, die alle über einen Wissensgraphen miteinander verbunden sind. Wenn ein Anwalt eine Frage stellt, sucht die KI nicht nur nach Schlüsselwörtern; sie navigiert durch diesen Graphen, um Beziehungen und Kontext zu verstehen. Dies ermöglicht es dem System, hochpräzise, kontextbezogene Antworten zu liefern, die durch spezifische rechtliche Zitate gestützt werden, und fungiert als leistungsstarkes Recherchewerkzeug für Juristen.

6

Erstellung synthetischer Daten für das Testen von KI-Modellen

Ein KI-Entwicklungsteam baut ein selbstfahrendes Autosystem, hat aber nicht genügend reale Daten für seltene Grenzfälle, wie zum Beispiel Tiere, die plötzlich die Straße überqueren. Sie verwenden eine grundlegende Datenbank von Fahrszenarien, um riesige Mengen an realistischen, synthetischen Daten zu generieren. Dieser Prozess ermöglicht es ihnen, Tausende von Variationen eines einzigen Szenarios zu erstellen, indem sie Wetterbedingungen, Beleuchtung und Objektgeschwindigkeiten ändern. Indem sie ihr Modell mit dieser umfassenden synthetischen Datenbank testen, können sie sicherstellen, dass die KI in Situationen robust und zuverlässig ist, die zu gefährlich oder selten sind, um sie in der Realität zu erfassen, und das alles ohne die Privatsphäre der Nutzer zu gefährden.

Datenbank FAQ

Was ist eine KI-Datenbankressource?

Eine KI-Datenbank ist eine große, kuratierte Sammlung von Daten, die speziell für das Training und Testen von Modellen der künstlichen Intelligenz organisiert ist. Im Gegensatz zu Allzweck-Datenbanken sind diese als Ressourcen konzipiert und enthalten oft Millionen von gelabelten Beispielen (wie Bilder mit Beschreibungen oder Text mit Stimmungs-Tags). Sie dienen als die „Lehrbücher“, aus denen maschinelle Lernalgorithmen lernen, Aufgaben wie Objekterkennung, Sprachverständnis oder Anomalieerkennung durchzuführen.

Wie wählt man die richtige KI-Datenbank für ein Projekt aus?

Die Wahl der richtigen KI-Datenbank hängt von mehreren Faktoren ab. Stellen Sie zunächst sicher, dass die Daten für Ihr spezifisches Problem hochrelevant sind. Zweitens bewerten Sie die Datenqualität, einschließlich ihrer Sauberkeit, der Genauigkeit der Labels und potenzieller Verzerrungen. Drittens überprüfen Sie die Lizenzvereinbarung, um zu bestätigen, dass sie Ihren Anwendungsfall (z. B. kommerziell vs. akademisch) erlaubt. Schließlich berücksichtigen Sie das Format und die Größe der Datenbank, um sicherzustellen, dass sie mit Ihrer technischen Infrastruktur und Ihren Werkzeugen kompatibel ist.

Was ist der Unterschied zwischen einem öffentlichen Datensatz und einer proprietären Datenbank?

Der Hauptunterschied liegt in der Zugänglichkeit und dem Eigentum.

  • Öffentliche Datensätze (z. B. ImageNet, Wikipedia Corpus) sind offen verfügbar, oft kostenlos, hauptsächlich für akademische Forschung und öffentliches Benchmarking. Sie fördern die Zusammenarbeit und standardisierte Evaluierung.
  • Proprietäre Datenbanken sind private Vermögenswerte eines Unternehmens. Sie enthalten oft sensible oder hochspezialisierte Daten (wie Kundentransaktionen oder interne Dokumente) und bieten einen erheblichen Wettbewerbsvorteil bei der Entwicklung einzigartiger KI-Lösungen.

Warum ist die Datenqualität in einer KI-Datenbank so wichtig?

Die Datenqualität ist von größter Bedeutung, da KI-Modelle direkt von den Daten lernen, die ihnen zur Verfügung gestellt werden. Das Prinzip „Müll rein, Müll raus“ ist hier fundamental. Hochwertige Daten – die genau, vollständig, konsistent und unvoreingenommen sind – führen zu zuverlässigeren, genaueren und faireren KI-Modellen. Umgekehrt führen Daten von schlechter Qualität mit Fehlern, Verzerrungen oder Inkonsistenzen zu einem Modell, das schlecht funktioniert und unzuverlässige oder sogar schädliche Entscheidungen trifft.

Welche gängigen Datentypen gibt es in KI-Datenbanken?

KI-Datenbanken können eine Vielzahl von Datentypen enthalten, die auf die spezifische KI-Aufgabe zugeschnitten sind. Gängige Typen sind:

  • Bilddaten: Sammlungen von Fotos oder Videos, oft mit Labels für Objekterkennung oder Bildklassifizierung.
  • Textdaten: Große Textkorpora aus Büchern, Artikeln oder Websites zum Trainieren von Sprachmodellen.
  • Tabellarische Daten: Strukturierte Daten in Zeilen und Spalten, wie Tabellenkalkulationen, die für prädiktive Analysen und Prognosen verwendet werden.
  • Audiodaten: Aufnahmen von Sprache oder Geräuschen, typischerweise mit Transkriptionen, für Spracherkennungssysteme.
  • Zeitreihendaten: Zeitlich geordnete Datenpunkte, wie Aktienkurse oder Sensormesswerte, für Prognosemodelle.