ToolMage
Anmelden

Best 2 Bibliothek AI tools for Ressourcen

Popular Bibliothek AI tools in Ressourcen include God of Prompt und ModelFusion, helping you work more efficiently.

ModelFusion
Freemium

ModelFusion

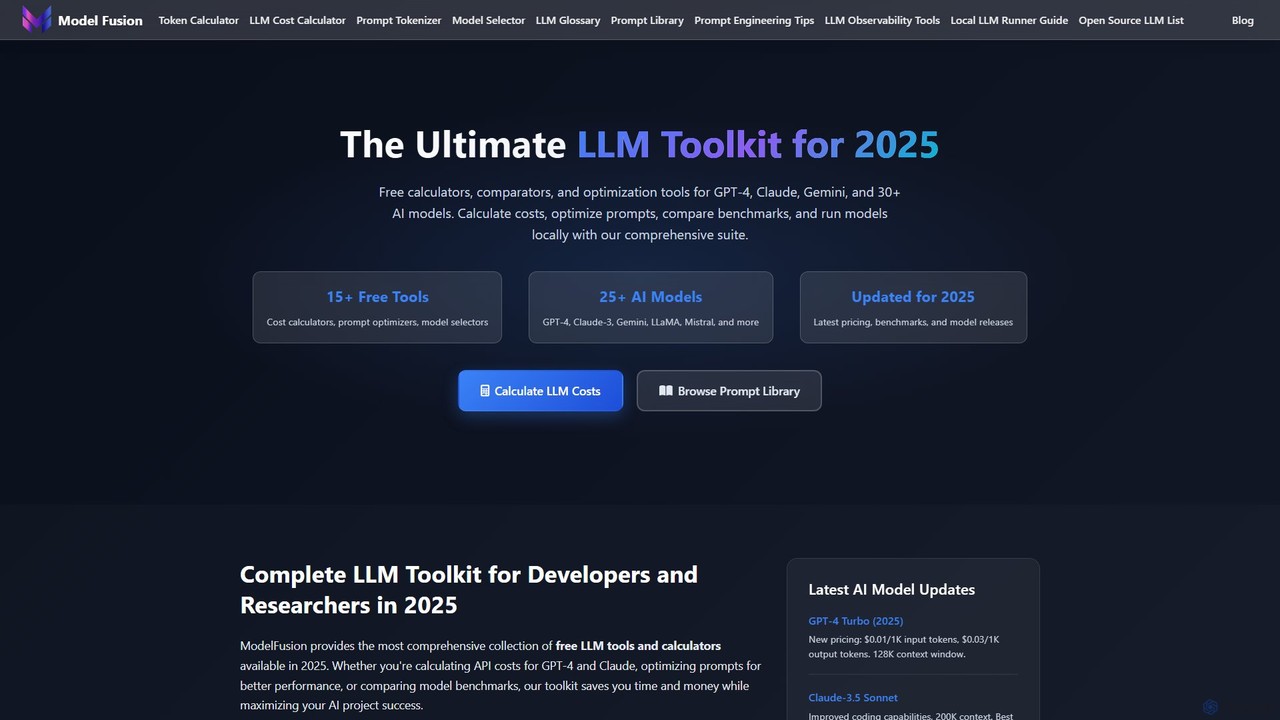
ModelFusion ist ein All-in-One-LLM-Toolkit für Entwickler und Forscher. Es bietet eine Reihe kostenloser Tools, darunter einen Kostenrechner, eine Prompt-Bibliothek und einen Modellvergleicher für über 30 KI-Modelle wie GPT-4, Claude und Gemini. Es bietet auch eine einheitliche API und Anleitungen zum lokalen Ausführen von Modellen, um die KI-Entwicklung zu optimieren und Kosten zu senken.

API
Visits 10.1KFavorites 152Likes 146
God of Prompt
Paid

God of Prompt

God of Prompt ist eine umfassende digitale Bibliothek mit über 30.000 fachmännisch erstellten KI-Prompts für führende Modelle wie ChatGPT, Claude, Midjourney und Gemini. Es wurde entwickelt, um Unternehmen, Vermarktern und Kreativen zu helfen, Zeit zu sparen, die Produktivität zu steigern und mühelos hochwertige Inhalte, Marketingmaterialien und visuelle Darstellungen zu erstellen.

SEO
Visits 231KFavorites 144Likes 140

About Bibliothek

KI-Bibliotheken sind Sammlungen von vorgefertigtem Code, Funktionen und Modulen, die es Entwicklern ermöglichen, komplexe KI-Fähigkeiten zu implementieren. Diese Bibliotheken bieten optimierte, wiederverwendbare Komponenten für Aufgaben wie maschinelles Lernen und Deep Learning und abstrahieren die zugrunde liegende mathematische Komplexität. Durch die Verwendung von KI-Bibliotheken können Entwickler den Entwicklungszyklus erheblich beschleunigen, die algorithmische Zuverlässigkeit gewährleisten und anspruchsvolle KI-Anwendungen effizienter erstellen, ohne bei Null anfangen zu müssen. Sie bilden eine grundlegende Ressource sowohl für schnelles Prototyping als auch für produktionsreife Systeme.

Kernfunktionen

  • Vorgefertigte Algorithmen: Bietet eine breite Palette getesteter und optimierter Algorithmen für Klassifizierung, Regression, Clustering und mehr.
  • High-Level-APIs: Bietet vereinfachte Schnittstellen, die das Definieren, Trainieren und Bereitstellen komplexer Modelle erleichtern.
  • Hardware-Beschleunigung: Beinhaltet Optimierungen für die Ausführung von Berechnungen auf GPUs und TPUs, was die Trainingszeiten drastisch reduziert.
  • Datenverarbeitungs-Tools: Enthält Werkzeuge zum effizienten Laden, Transformieren und Manipulieren großer Datensätze.
  • Umfassende Dokumentation: Unterstützt durch umfassende Anleitungen, Tutorials und eine starke Community zur Fehlerbehebung.

Anwendungsfälle

KI-Bibliotheken werden hauptsächlich von Softwareentwicklern, Datenwissenschaftlern und Ingenieuren für maschinelles Lernen verwendet. Sie sind unerlässlich für die Erstellung benutzerdefinierter KI-Modelle für die Verarbeitung natürlicher Sprache (NLP), Computer Vision, prädiktive Analytik und Empfehlungssysteme. Forscher verlassen sich ebenfalls auf sie, um in akademischen Umgebungen mit neuen neuronalen Netzwerkarchitekturen und Algorithmen zu experimentieren.

Wie man wählt

Bei der Auswahl einer KI-Bibliothek sollten Sie das Hauptziel des Projekts (z. B. Computer Vision vs. NLP), die Programmiersprache Ihres Tech-Stacks (Python ist am gebräuchlichsten) sowie das Ökosystem und den Community-Support der Bibliothek berücksichtigen. Bewerten Sie auch ihre Leistung, Skalierbarkeit für große Datensätze und die Steilheit ihrer Lernkurve. Die Wahl einer Bibliothek, die auf Ihren erforderlichen Bereich spezialisiert ist, kann oft erhebliche Vorteile bieten.

Bibliothek use cases

1

Entwicklung eines benutzerdefinierten Bilderkennungsmodells

Ein Data-Science-Team muss ein System entwickeln, das spezifische Produktfehler an einer Fertigungslinie identifiziert. Mit einer Deep-Learning-Bibliothek wie TensorFlow oder PyTorch können sie ein Convolutional Neural Network (CNN) entwerfen, trainieren und feinabstimmen. Die Bibliothek bietet vorgefertigte Schichten, Optimierungsalgorithmen und Werkzeuge zur Datenaugmentation, was die Entwicklungszeit im Vergleich zur Implementierung des gesamten Netzwerks von Grund auf drastisch reduziert. Das endgültige Modell kann zur Analyse von Echtzeit-Videoströmen eingesetzt werden, um fehlerhafte Artikel mit hoher Genauigkeit zu kennzeichnen.

2

Erstellung einer Stimmungsanalyse-Anwendung

Ein Softwareentwickler hat die Aufgabe, einem Social-Media-Monitoring-Tool eine Funktion hinzuzufügen, die die öffentliche Meinung aus Benutzerkommentaren misst. Anstatt komplexe NLP-Modelle zu erstellen, verwendet der Entwickler eine spezialisierte Bibliothek wie Hugging Face Transformers. Diese Bibliothek bietet direkten Zugriff auf hochmoderne, vortrainierte Modelle wie BERT. Mit nur wenigen Codezeilen kann der Entwickler eine robuste Stimmungsanalysefunktion implementieren, die Text als positiv, negativ oder neutral klassifiziert und so wochenlange Forschungs- und Entwicklungsarbeit einspart.

3

Schnelles Prototyping einer Empfehlungs-Engine

Ein Startup möchte schnell die Machbarkeit einer personalisierten Inhaltsempfehlungsfunktion testen. Ein Ingenieur für maschinelles Lernen verwendet eine Bibliothek wie Scikit-learn, die ideal für klassische maschinelle Lernaufgaben ist. Sie können schnell verschiedene Empfehlungsalgorithmen wie kollaboratives Filtern oder inhaltsbasiertes Filtern implementieren und vergleichen, indem sie die standardisierte API und die Datenverarbeitungswerkzeuge der Bibliothek nutzen. Dies ermöglicht es dem Team, das Konzept mit einem funktionsfähigen Prototyp in Tagen statt in Monaten zu validieren und fundierte Entscheidungen zu treffen, bevor sie sich zu einer vollständigen Implementierung verpflichten.

4

Akademische Forschung zu neuartigen KI-Architekturen

Ein Universitätsforscher entwickelt eine neue Art von neuronalem Netzwerk für die medizinische Bildanalyse. Er verwendet eine KI-Bibliothek wie PyTorch wegen ihrer Flexibilität und starken Unterstützung für dynamische Berechnungsgraphen. Die automatische Differentiations-Engine der Bibliothek übernimmt die komplexe Berechnung der Backpropagation, sodass sich der Forscher auf das Design der Netzwerkarchitektur und das Experimentieren konzentrieren kann. Er kann problemlos benutzerdefinierte Schichten und Verlustfunktionen implementieren, was eine schnelle Iteration und die Erforschung neuer wissenschaftlicher Ideen erleichtert, was für die Veröffentlichung von Spitzenforschung entscheidend ist.

5

Erstellung eines prädiktiven Analyse-Tools für Unternehmen

Ein Geschäftsanalyst mit Python-Kenntnissen hat die Aufgabe, ein Modell zur Vorhersage der Kundenabwanderung zu erstellen. Er verwendet eine Kombination von Bibliotheken: Pandas zur Datenbereinigung und -manipulation und Scikit-learn zum Trainieren eines logistischen Regressions- oder Gradient-Boosting-Modells. Diese Bibliotheken bieten einen unkomplizierten Arbeitsablauf von den Rohdaten bis zu einem trainierten Vorhersagemodell. Der Analyst kann die Modellleistung mithilfe integrierter Metriken leicht bewerten und dann handlungsorientierte Einblicke liefern, wie z. B. die Identifizierung von Kunden mit hohem Abwanderungsrisiko, ohne einen tiefen Hintergrund im theoretischen maschinellen Lernen zu benötigen.

6

Automatisierung von Computer-Vision-Aufgaben

Ein Entwickler für ein Einzelhandelsanalyseunternehmen muss ein System zur Zählung von Personen in Geschäften anhand von Überwachungskameraaufnahmen implementieren. Er verwendet eine Bibliothek wie OpenCV, die eine riesige Sammlung von Funktionen für Echtzeit-Computer-Vision bietet. Der Entwickler kann vorgefertigte Funktionen zur Objekterkennung, Merkmalsabgleich und Videostream-Verarbeitung nutzen. Dies ermöglicht es ihm, schnell eine robuste Anwendung zur Personenzählung zu erstellen und sie in bestehende Kamerasysteme zu integrieren, ohne Low-Level-Bildverarbeitungsalgorithmen von Grund auf neu schreiben zu müssen.

Bibliothek FAQ

Was ist eine KI-Bibliothek?

Eine KI-Bibliothek ist eine Sammlung von vorgefertigtem, wiederverwendbarem Code, der Entwicklern helfen soll, KI- und Machine-Learning-Anwendungen einfacher zu erstellen. Anstatt komplexe Algorithmen von Grund auf neu zu schreiben, können Entwickler die von einer Bibliothek bereitgestellten Funktionen und Module verwenden. Diese Bibliotheken bieten in der Regel Werkzeuge zur Datenmanipulation, Implementierungen gängiger maschineller Lernalgorithmen und Komponenten zum Erstellen und Trainieren von neuronalen Netzen. Sie fungieren als grundlegende Ressource, die die Entwicklung beschleunigt und die Codequalität sicherstellt.

Wie wählt man die richtige KI-Bibliothek für ein Projekt aus?

Die Wahl der richtigen KI-Bibliothek hängt von mehreren Faktoren ab. Berücksichtigen Sie die folgenden Punkte:

  • Projektziel: Liegt Ihr Fokus auf Computer Vision, NLP oder traditioneller Datenanalyse? Wählen Sie eine Bibliothek, die in diesem Bereich herausragt (z. B. OpenCV für Vision, Hugging Face für NLP).
  • Programmiersprache: Stellen Sie sicher, dass die Bibliothek mit Ihrem bestehenden Tech-Stack kompatibel ist, wobei Python die häufigste Wahl ist.
  • Ökosystem und Community: Eine große, aktive Community bedeutet bessere Dokumentation, mehr Tutorials und einfachere Fehlerbehebung.
  • Leistungsanforderungen: Wenn Sie hohe Leistung benötigen, suchen Sie nach Bibliotheken mit GPU-Unterstützung und Skalierbarkeitsfunktionen.
  • Lernkurve: Berücksichtigen Sie die Fachkenntnisse Ihres Teams. Einige Bibliotheken (wie Keras) sind für Anfänger benutzerfreundlicher, während andere (wie Low-Level-TensorFlow) mehr Kontrolle bieten.
Was ist der Unterschied zwischen einer KI-Bibliothek und einem KI-Framework?

Der Hauptunterschied liegt im Kontrollfluss, oft als "Inversion of Control" beschrieben. Bei einer Bibliothek hat Ihr Code die Kontrolle; Sie rufen Funktionen aus der Bibliothek auf, wenn Sie sie benötigen. Bei einem Framework hat das Framework die Kontrolle; es bietet eine Struktur und ruft Ihren Code an bestimmten Stellen auf. Bibliotheken bieten mehr Flexibilität bei der Integration in bestehende Anwendungen, während Frameworks eine umfassendere, meinungsbildende Struktur für den Aufbau einer Anwendung von Grund auf bieten. Einige Tools, wie TensorFlow, können beides sein.

Was sind einige beliebte Beispiele für KI-Bibliotheken?

Mehrere KI-Bibliotheken werden in der Industrie und der Wissenschaft weit verbreitet eingesetzt. Einige der beliebtesten sind:

  • TensorFlow: Entwickelt von Google, ist es ein umfassendes Ökosystem zum Erstellen und Bereitstellen von Machine-Learning-Modellen, insbesondere für Deep Learning.
  • PyTorch: Entwickelt von Meta, bekannt für seine Flexibilität, den dynamischen Berechnungsgraphen und die starke Community-Unterstützung, insbesondere in der Forschung.
  • Scikit-learn: Eine Standardbibliothek für klassische maschinelle Lernalgorithmen wie Regression, Klassifikation und Clustering. Sie ist bekannt für ihre einfache und konsistente API.
  • Hugging Face Transformers: Die Standardbibliothek für die Verarbeitung natürlicher Sprache (NLP), die einfachen Zugriff auf Tausende von vortrainierten Modellen bietet.
  • OpenCV: Eine führende Bibliothek für Computer-Vision-Aufgaben, die eine riesige Sammlung von Algorithmen für die Bild- und Videoverarbeitung bietet.
Benötige ich starke mathematische Fähigkeiten, um eine KI-Bibliothek zu verwenden?

Nicht unbedingt für die grundlegende bis mittlere Nutzung. High-Level-APIs in Bibliotheken wie Keras oder Scikit-learn abstrahieren die meisten komplexen mathematischen Berechnungen (wie Analysis und lineare Algebra). Dies ermöglicht es Entwicklern und Analysten, effektive Modelle zu erstellen und zu trainieren, ohne einen tiefen theoretischen Hintergrund zu haben. Ein grundlegendes Verständnis der zugrunde liegenden Konzepte ist jedoch für fortgeschrittene Aufgaben wie die Anpassung von Modellen, die Behebung von Leistungsproblemen und die korrekte Interpretation der Ergebnisse sehr vorteilhaft. Für die Forschung oder die Entwicklung neuer Algorithmen sind starke mathematische Fähigkeiten unerlässlich.