ToolMage
Anmelden

AI TOOL COMPARISON

Ask On Data vs Flyte

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

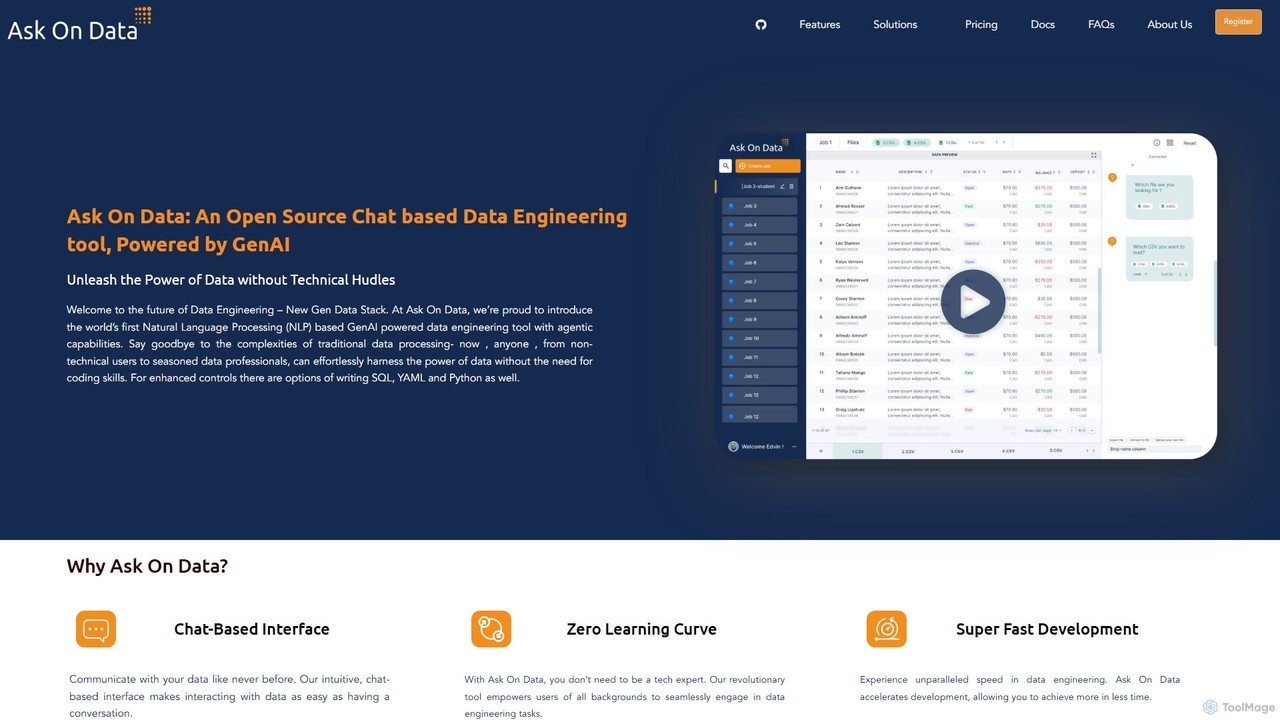
Ask On Data Produktübersicht

Ask On Data ist ein Open-Source-Tool für Data Engineering, das von GenAI angetrieben wird und es Ihnen ermöglicht, Datenpipelines über eine einfache Chat-Oberfläche zu erstellen und zu verwalten. Durch die Übersetzung von Befehlen in natürlicher Sprache in komplexe Datenoperationen entfällt die Notwendigkeit des Programmierens, wodurch Data Engineering für jedermann zugänglich wird. Es unterstützt verschiedene Datenquellen, bietet Echtzeit-Vorschauen und stellt sowohl Cloud-gehostete als auch selbst gehostete Optionen zur Verfügung.

Preview

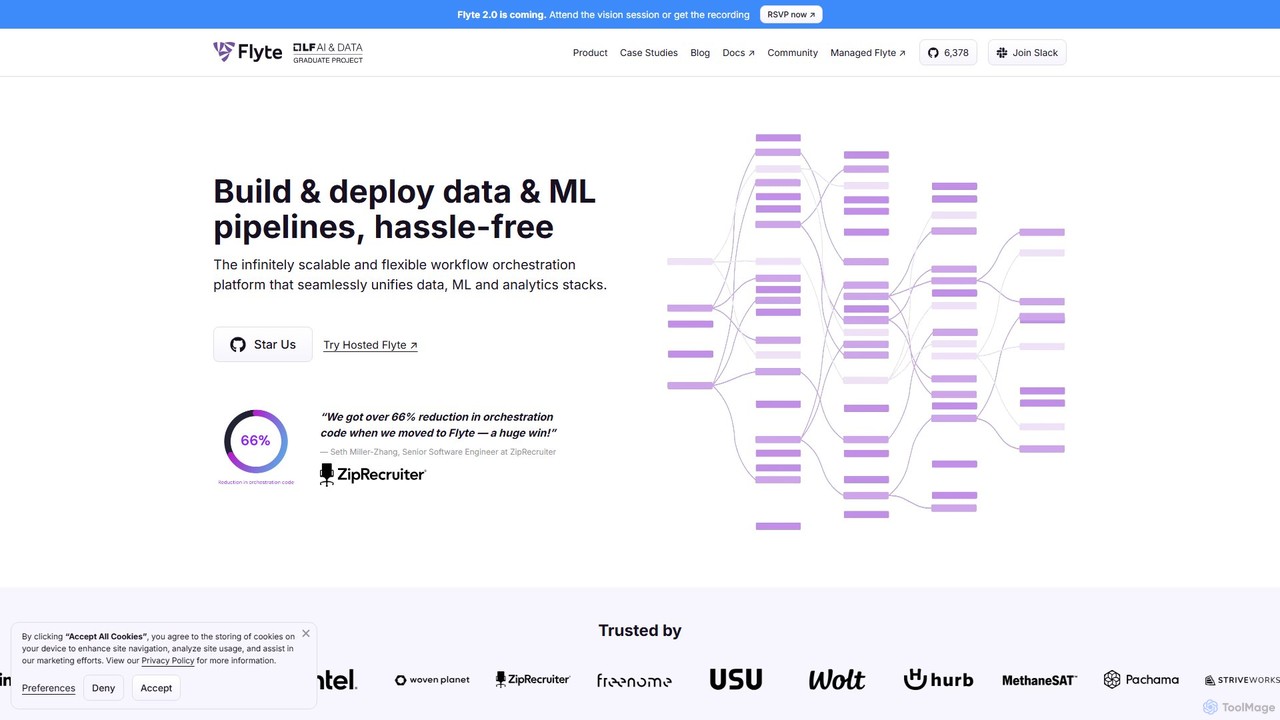
Flyte Produktübersicht

Flyte ist eine Open-Source, Cloud-native Workflow-Orchestrierungsplattform, die für die Erstellung, Bereitstellung und Verwaltung von produktionsreifen Daten-, Machine-Learning- und Analyse-Pipelines entwickelt wurde. Sie legt Wert auf Skalierbarkeit, Reproduzierbarkeit und Benutzerfreundlichkeit und ermöglicht es Teams, nahtlos von der lokalen Entwicklung zur groß angelegten Produktion überzugehen. Mit einem Python-first SDK und Unterstützung für mehrere Sprachen befähigt Flyte Datenwissenschaftler und Ingenieure, komplexe, versionierte und wartbare Workflows zu erstellen.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Ask On Data VS Flyte — Kerndaten
KerndatenAsk On DataFlyte
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusETLMLOps
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienETL · Datenbank · Datenverarbeitung · AutomatisierungMLOps · Orchestrierung · Automatisierung
Added03.08.202503.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Ask On Data

Ask On Data ist ein revolutionäres Open-Source-Tool für Data Engineering, das Generative KI nutzt, um die Erstellung von Datenpipelines zu vereinfachen und zu beschleunigen. Es führt eine chatbasierte Oberfläche ein, die es Benutzern ermöglicht, mit ihren Daten zu interagieren und komplexe Arbeitsabläufe in einfachem Englisch zu erstellen. Dieser Ansatz beseitigt effektiv technische Hürden und demokratisiert das Data Engineering für eine breite Palette von Benutzern, von Geschäftsanalysten und Datenwissenschaftlern bis hin zu erfahrenen Dateningenieuren. Die Plattform ist als der Daten-Stack der nächsten Generation konzipiert und macht die Datenverarbeitung intuitiv, schnell und kostengünstig.

Im Kern zielt Ask On Data darauf ab, die üblichen Engpässe in traditionellen ETL-Prozessen (Extrahieren, Transformieren, Laden) zu lösen, wie hohe Kosten, steile Lernkurven und die Abhängigkeit von spezialisierten Ingenieuren. Durch die Bereitstellung eines KI-Assistenten für Datenaufgaben reduziert es die Entwicklungszeit erheblich – um bis zu 92 % im Vergleich zu herkömmlichen Werkzeugen – und befähigt Teams, bei ihren Datenaufbereitungsanforderungen autarker zu werden.

Wie man Ask On Data verwendet

Die Verwendung von Ask On Data ist so einfach wie ein Gespräch. Der Arbeitsablauf ist intuitiv gestaltet und erfordert keine Vorkenntnisse im Programmieren:

  1. Verbinden Sie Ihre Datenquelle: Beginnen Sie, indem Sie sich mit Ihren Daten aus einer Vielzahl von Quellen verbinden, einschließlich Flat-Files (CSV, Excel), APIs, Datenbanken (wie MySQL, PostgreSQL, Firebird), Data Lakes und Data Warehouses (wie Amazon Redshift, Snowflake).
  2. Chatten Sie zur Transformation: Verwenden Sie die Chat-Oberfläche, um Befehle in natürlicher Sprache zu geben. Sie können beispielsweise Anweisungen wie "Verbinde Tabelle A mit Tabelle B über die Spalte user_id", "Entferne doppelte Zeilen" oder "Berechne den Gesamtumsatz für jede Region" eingeben.
  3. Vorschau in Echtzeit: Bei jedem Befehl bietet Ask On Data eine sofortige Vorschau der transformierten Daten. Dies ermöglicht es Ihnen, jeden Schritt Ihrer Pipeline zu validieren und sicherzustellen, dass die Operationen wie erwartet ausgeführt werden.
  4. Validieren und Verfeinern: Für fortgeschrittene Benutzer, die mehr Kontrolle benötigen, bietet die Plattform die Möglichkeit, Code direkt in SQL oder Python anzuzeigen, zu bearbeiten und sogar zu schreiben. Sie können auch die zugrunde liegende YAML-Konfigurationsdatei überprüfen, um den gesamten Arbeitsablauf zu verstehen und zu optimieren.
  5. Planen und Automatisieren: Sobald Ihre Datenpipeline fertig ist, können Sie sie so planen, dass sie in bestimmten Frequenzen (z. B. täglich, stündlich) ausgeführt wird. Sie können Jobdetails wie vollständige Ladevorgänge, inkrementelle Ladevorgänge oder Truncate-and-Load-Operationen konfigurieren.
  6. Rückgängig machen und Überprüfen: Die Plattform führt eine umfassende Historie aller durchgeführten Aktionen. Wenn Sie einen Fehler machen, können Sie die Rückgängig-Funktion einfach verwenden, um Änderungen rückgängig zu machen.

Kernfunktionen von Ask On Data

  • GenAI-gestützte Chat-Oberfläche: Erstellen und verwalten Sie Datenpipelines, indem Sie einfach Anweisungen in einfachem Englisch eingeben, ohne dass eine Programmierung erforderlich ist.
  • Meisterschaft bei Datenpipelines: Erstellen, verwalten und optimieren Sie nahtlos End-to-End-Datenpipelines für Datenintegration, -bereinigung, -aufbereitung und -transformation.
  • Breite Unterstützung von Datenquellen: Verbinden Sie sich mit verschiedenen Datenquellen, einschließlich Dateien, APIs, Datenbanken, Data Lakes und Data Warehouses.
  • Echtzeit-Datenvorschau: Sehen Sie sofort die Ergebnisse Ihrer Transformationen, was eine schnelle Validierung und Iteration ermöglicht.
  • Code-Kontrolle und Transparenz: Zur erweiterten Kontrolle können Benutzer SQL und Python schreiben oder die YAML-Datei der Pipeline bearbeiten, was sie für die Behandlung von Randfällen geeignet macht.
  • Job-Planung und Orchestrierung: Automatisieren Sie Ihre Daten-Workflows, indem Sie Jobs zur Ausführung in bestimmten Frequenzen mit detaillierten Ladeoptionen planen.
  • Aktionsverlauf und Rückgängig-Funktion: Verfolgen Sie Änderungen einfach und machen Sie Fehler mit einem umfassenden Aktionsverlauf und einer einfachen Rückgängig-Schaltfläche rückgängig.
  • Flexible Bereitstellung: Wird als vollständig verwalteter Cloud-Dienst oder als kostenlose, selbst gehostete Open-Source-Version angeboten.

Anwendungsfälle für Ask On Data

Ask On Data ist vielseitig und nützt einem breiten Spektrum von Benutzern und Szenarien:

  • Datenwissenschaftler & ML-Ingenieure: Bereiten Sie Datensätze für maschinelle Lernmodelle unabhängig vor, ohne auf Data-Engineering-Teams warten zu müssen.
  • BI-Benutzer & Datenanalysten: Greifen Sie direkt auf Daten für Berichte und Dashboards zu, bereinigen und transformieren Sie sie, was echte Self-Service-Analysen ermöglicht.
  • Dateningenieure: Beschleunigen Sie die Entwicklung komplexer ETL/ELT-Pipelines drastisch und schaffen Sie so Zeit, sich auf strategischere Aufgaben zu konzentrieren.
  • Geschäftsanwender: Nicht-technische Benutzer können mit Daten interagieren und grundlegende Datenaufbereitungsaufgaben ohne Programmierkenntnisse durchführen.
  • Datenmigration: Migrieren Sie Daten effizient zwischen verschiedenen Systemen, z. B. von lokalen Datenbanken wie MySQL oder Firebird zu Cloud-Data-Warehouses wie Snowflake oder Redshift.

Vorteile von Ask On Data

Ask On Data zeichnet sich durch mehrere entscheidende Vorteile aus:

  • Keine Lernkurve: Die intuitive Chat-Oberfläche macht es für jeden zugänglich, unabhängig von seinem technischen Hintergrund.
  • Unvergleichliche Geschwindigkeit: Beschleunigen Sie die Entwicklung von Datenpipelines von Tagen oder Wochen auf nur wenige Minuten und erzielen Sie erhebliche Zeit- und Kosteneinsparungen.
  • Kosteneffizienz: Bietet über 80 % Kosteneinsparungen im Vergleich zu herkömmlichen lizenzierten ETL-Tools, mit einem großzügigen kostenlosen und Open-Source-Plan.
  • Demokratisierung von Daten: Befähigt alle Benutzer innerhalb einer Organisation, mit Daten zu arbeiten, und bricht Silos und Engpässe auf.
  • Flexibilität und Kontrolle: Balanciert No-Code-Einfachheit mit optionaler codebasierter Kontrolle für maximale Flexibilität.

Preise und Pläne

Ask On Data bietet mehrere Pläne für unterschiedliche Bedürfnisse:

  • Open Source: Eine vollständig kostenlose, selbst gehostete Version, die Unterstützung für alle Datenbanken, Planungsfunktionen und Community-Support umfasst. Benutzer sind für manuelle Patches und Upgrades verantwortlich.
  • Kostenlos (Managed Cloud): Ein kostenloser, verwalteter Cloud-gehosteter Plan, ideal für den kleinen Gebrauch. Er unterstützt Excel- und CSV-Dateien (bis zu 5 MB Limit) und beinhaltet automatische Upgrades, hat aber keine Job-Planung.
  • Enterprise: Ein Premium-Managed-Cloud-Plan für Unternehmen. Er umfasst Unterstützung für alle Datenquellen, Planung, Enterprise-Level-Support, automatische Upgrades, Backups und Überwachung. Die Preisgestaltung ist individuell; Interessenten sollten sich an den Support wenden.

Flyte

Flyte ist eine produktionsreife, Open-Source- und Cloud-native Workflow-Orchestrierungsplattform, die speziell für komplexe Daten-, Machine-Learning- und Analyse-Pipelines entwickelt wurde. Als graduiertes Projekt der Cloud Native Computing Foundation (CNCF) bietet Flyte ein robustes und zuverlässiges Rückgrat für MLOps und schließt die Lücke zwischen lokaler Entwicklung und groß angelegten Produktionsumgebungen. Es ermöglicht Datenwissenschaftlern und ML-Ingenieuren, sich auf ihre Logik zu konzentrieren, während die Plattform Skalierbarkeit, Reproduzierbarkeit, Fehlertoleranz und Infrastrukturmanagement übernimmt.

Wie man Flyte verwendet

Die Verwendung von Flyte beinhaltet einen strukturierten, Code-first-Ansatz zur Definition und Verwaltung von Workflows:

  1. Tasks definieren: Ein Task ist die grundlegende Ausführungseinheit. Mit dem Python SDK definieren Sie einen Task mit dem `@task`-Decorator. Innerhalb des Tasks geben Sie dessen Eingaben, Ausgaben, Ressourcenanforderungen (z. B. CPU, Speicher, GPU) und Container-Image an.
  2. Workflows erstellen: Ein Workflow, definiert mit dem `@workflow`-Decorator, verkettet Tasks zu einem gerichteten azyklischen Graphen (DAG). Sie definieren den Datenfluss zwischen den Tasks und erstellen so eine vollständige Pipeline.
  3. Lokale Iteration: Flyte bietet Tools wie `pyflyte run`, um Ihre Workflows auf Ihrem lokalen Rechner auszuführen und zu debuggen. Dies ermöglicht eine schnelle Iteration und eine enge Feedback-Schleife vor der Bereitstellung.
  4. In Produktion registrieren: Sobald Ihr Workflow fertig ist, registrieren Sie ihn mit `pyflyte register` bei einem Flyte-Cluster. Diese Aktion versioniert Ihren gesamten Workflow, einschließlich Code und Abhängigkeiten, und gewährleistet so die Reproduzierbarkeit.
  5. Starten und Überwachen: Sie können Workflow-Ausführungen über die Flyte-Benutzeroberfläche, einen geplanten Cron-Job oder die API auslösen. Die Benutzeroberfläche bietet eine umfassende Ansicht zur Überwachung von Ausführungen, zur Überprüfung von Protokollen, zur Visualisierung von Ausgaben mit FlyteDecks und zur Analyse der Datenherkunft.
  6. Mit erweiterten Funktionen skalieren: Für die Verarbeitung im großen Maßstab können Sie Funktionen wie `map_task` nutzen, um einen Task parallel über eine Liste von Eingaben auszuführen, oder dynamische Workflows verwenden, um die Struktur der Pipeline zur Laufzeit anzupassen.

Kernfunktionen von Flyte

  • Reproduzierbarkeit & Versionierung: Jeder Task und Workflow ist versioniert und unveränderlich. Flyte verfolgt automatisch die Datenherkunft, sodass Sie jede Ausgabe auf den exakten Code und die Daten zurückführen können, die sie erzeugt haben.
  • Skalierbarkeit & Leistung: Auf Kubernetes aufgebaut, ist Flyte von Natur aus skalierbar. Es unterstützt dynamische Ressourcenzuweisung, GPU-Beschleunigung, Spot/Preemptible-Instanzen zur Kosteneinsparung und massive Parallelität durch Map-Tasks.
  • Entwicklerzentrierte Erfahrung: Bietet ein Python-first SDK, das für Datenwissenschaftler intuitiv ist. Es abstrahiert Infrastrukturkomplexitäten mit Funktionen wie `ImageSpec`, das Container-Images ohne Dockerfile-Kenntnisse erstellt.
  • Sprachunabhängig: Obwohl das primäre SDK Python ist, unterstützt Flyte das Schreiben von Tasks in jeder Sprache (Java, Scala, R usw.), indem sie in ihren eigenen Containern ausgeführt werden.
  • Robuste Datenverarbeitung: Bietet stark typisierte Schnittstellen, um Datenfehler zur Kompilierungszeit abzufangen. Die Typen `FlyteFile`, `FlyteDirectory` und `StructuredDataset` vereinfachen die Daten-E/A zwischen Tasks und Cloud-Speicher.
  • Erweiterte Orchestrierungslogik: Unterstützt dynamische Workflows, bedingte Verzweigungen, Intra-Task-Checkpointing für langlaufende Tasks und Caching, um die Neuberechnung teurer Schritte zu vermeiden.
  • Unternehmensreif: Bietet Mandantenfähigkeit zur Team-Isolation, Geheimnisverwaltung für den sicheren Zugriff auf Anmeldeinformationen und Benachrichtigungen über Slack, PagerDuty oder E-Mail.

Anwendungsfälle für Flyte

Flyte ist vielseitig und wird in verschiedenen Branchen für geschäftskritische Pipelines eingesetzt:

  • Groß angelegte Datenverarbeitung (ETL): Erstellung und Planung robuster ETL-Pipelines zur Verarbeitung von Terabytes an Daten für Analysen und Data Warehousing.
  • Training von Machine-Learning-Modellen: Orchestrierung von End-to-End-ML-Pipelines, von der Datenvorverarbeitung und dem Feature-Engineering bis hin zum verteilten Modelltraining, der Hyperparameter-Optimierung und der Evaluierung.
  • LLM & Generative KI: Feinabstimmung von Large Language Models (LLMs), Aufbau von Retrieval-Augmented Generation (RAG)-Systemen und Verwaltung komplexer Inferenzgraphen.
  • Bioinformatik & Genomik: Ausführung rechenintensiver Bioinformatik-Workflows, wie z. B. DNA-Sequenzabgleich und -analyse, im großen Maßstab.
  • Geodatenanalyse: Verarbeitung massiver Satellitenbilddatensätze zur Erstellung von Datenprodukten wie Mosaiken und digitalen Höhenmodellen, wie durch die Verwendung mit Xarray und GDAL demonstriert.

Vorteile von Flyte

Flyte bietet erhebliche Vorteile gegenüber anderen Orchestratoren:

  • Produktionsreif vom ersten Tag an: Der Fokus auf Typisierung, Versionierung und Unveränderlichkeit stellt sicher, dass Workflows zuverlässig und reproduzierbar sind.
  • Vereint Daten- & ML-Stacks: Bietet eine einzige Plattform für Dateningenieure, ML-Wissenschaftler und Analyseexperten, wodurch Silos aufgebrochen und die Zusammenarbeit gefördert wird.
  • Reduziert den Infrastrukturaufwand: Automatisiert viele der herausfordernden Aspekte von MLOps, wie Containerisierung, Ressourcenmanagement und Skalierung.
  • Kosteneffizient: Der Open-Source-Kern ist kostenlos, während Funktionen wie Caching, Fehlerbehebung und Spot-Instanz-Unterstützung die Rechenkosten erheblich senken.
  • Lebendiges Ökosystem: Als CNCF-Projekt verfügt es über eine starke Community und lässt sich nahtlos in eine breite Palette von Tools wie Spark, Ray, Pandera, Great Expectations und mehr integrieren.

Preise und Pläne

Flyte ist ein Open-Source-Projekt unter der Apache-2.0-Lizenz und kann daher völlig kostenlos heruntergeladen, verwendet und auf Ihrer eigenen Infrastruktur selbst gehostet werden. Für Organisationen, die eine vollständig verwaltete, unternehmensreife Lösung bevorzugen, bietet Union.ai (das Unternehmen, das Flyte ursprünglich entwickelt hat) eine gehostete Cloud-Plattform an. Dieses kommerzielle Angebot übernimmt die gesamte Einrichtung, Wartung und Skalierung der Infrastruktur und beinhaltet Unternehmenssupport und zusätzliche Funktionen.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Automatisierung
Nur Ask On Data
ETLDatenbankDatenverarbeitung
Nur Flyte
MLOpsOrchestrierung

Tags

Gemeinsam
DatenengineeringDatenpipelineOpen Source
Nur Ask On Data
Apache SparkDatenautomatisierungDatenbankDatenmigrationDatentransformationETLGenerative KILow-Codenatürliche SprachverarbeitungNo-Code
Nur Flyte
Kubernetesmaschinelles LernenMLOpsPythonReproduzierbarkeitSkalierbarkeitWorkflow-Orchestrierung

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Ask On Data
Keine verifizierten Daten
Nur Flyte
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Ask On Data monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
1.9K
Ø Besuchsdauer
0:00
Seiten pro Besuch
1.04
Absprungrate
36.34%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 606
  • 2026-01: 1.7K
  • 2026-02: 731
  • 2026-03: 2K
  • 2026-04: 1.4K
  • 2026-05: 1.9K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States44.3%859
🇿🇦South Africa18.54%359
🇮🇳India18.18%353
🇹🇷Turkey13.82%268
🇲🇽Mexico5.16%100

Suchbegriffe

askdataask on dataaskondataconvert firebird to postegressqlpostgresql import from firebird

Flyte monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
26.6K
Ø Besuchsdauer
0:12
Seiten pro Besuch
1.8
Absprungrate
38.08%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 37.5K
  • 2026-01: 29.4K
  • 2026-02: 32.2K
  • 2026-03: 30K
  • 2026-04: 31K
  • 2026-05: 26.6K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.74%12.4K
🇮🇳India15.16%4K
🇻🇳Vietnam14.31%3.8K
🇨🇦Canada13.45%3.6K
🇩🇪Germany10.34%2.7K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt54.58%14.5K
Verweis32.11%8.5K
E-Mail13.31%3.5K

Suchbegriffe

flyteflyte lyftgraphvizgraphviz onlinelyft flyte

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Ask On Data

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
188
Likes
172

Flyte

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
185
Likes
181

Ask On Data vs Flyte · Vergleichs-FAQ

What do Ask On Data and Flyte have in common?
Both tools are listed under Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Ask On Data and Flyte free?
Listed pricing models: Ask On Data — Freemium; Flyte — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Ask On Data and Flyte?
The primary listed category is ETL for Ask On Data, and MLOps for Flyte. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche