ToolMage
Anmelden

AI TOOL COMPARISON

Datafold vs nao

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Datafold Produktübersicht

Datafold ist eine KI-gestützte Plattform für Daten-Engineering-Teams, die Datenqualitätstests, Überwachung und Migrationen automatisiert. Sie verwendet Daten-Diffing zum Vergleich von Datensätzen, ermöglicht proaktive Problemerkennung in CI/CD und gewährleistet 100%ige Parität bei komplexen Datenmigrationen, wodurch Zeitpläne um das bis zu 6-fache beschleunigt werden.

Preview

nao Produktübersicht

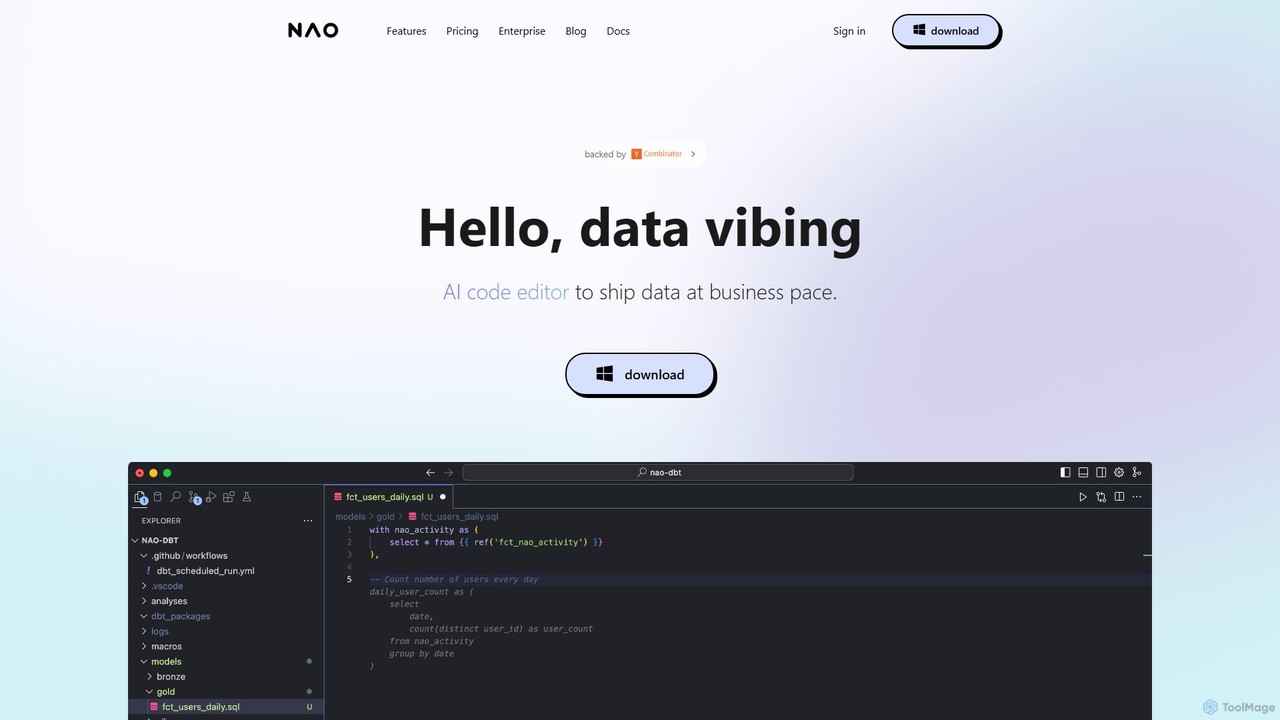
nao ist ein KI-gestützter Code-Editor für Datenteams. Er optimiert die Erstellung von SQL- und Python-Datenpipelines, dbt-Workflows und Analysen durch native Anbindung an Ihr Data Warehouse. Sein intelligenter Agent liefert datenbewusste Code-Vorschläge, Qualitätsprüfungen und sofortige Diff-Vorschauen, um Ihnen zu helfen, Daten schneller und sicherer bereitzustellen.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Datafold VS nao — Kerndaten
KerndatenDatafoldnao
Pricing modelPaidFreemium
Product typeWebApp
Primary focusAnalysenAnalysen
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienAnalysen · Datenbank · AutomatisierungAnalysen · Datenbank · Code-Assistent
Added11.08.202505.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Datafold

Datafold ist eine einheitliche Plattform für proaktive Datenqualität, die speziell entwickelt wurde, um Daten-Engineering-Teams zu stärken. Sie befasst sich mit den kritischsten und anspruchsvollsten Aspekten moderner Daten-Workflows: die Gewährleistung absoluter Datenintegrität und die Optimierung der Modernisierung der Dateninfrastruktur. Durch die Nutzung der Leistungsfähigkeit von KI, fortschrittlichen großen Sprachmodellen (LLMs) und seiner proprietären "Data Diffing"-Technologie automatisiert Datafold die fehleranfälligsten und zeitaufwändigsten Aufgaben. Dies ermöglicht es Teams, hochzuverlässige Datenprodukte in einem viel schnelleren Tempo zu erstellen.

Die Plattform basiert auf dem Prinzip, dass Datenqualität ein proaktiver, integraler Bestandteil des Entwicklungslebenszyklus sein sollte, nicht eine reaktive nachträgliche Überlegung. Sie bietet die notwendigen Werkzeuge für Unternehmen, um die Grenzen von Altsystemen zu überwinden und selbstbewusst einen KI-fähigen Datenstack mit beispielloser Geschwindigkeit und Genauigkeit aufzubauen.

Wie man Datafold verwendet

Datafold integriert sich nahtlos in bestehende Daten-Engineering-Workflows und bietet einen strukturierten und automatisierten Ansatz für verschiedene Aufgaben.

Für Datenmigrationen:

  1. Planen: Nutzen Sie detaillierte Spalten-Level-Lineage, um alle Datenabhängigkeiten abzubilden und die Komplexität der Migration genau zu bewerten. Dies erstellt einen umfassenden Plan, der Projektzeitpläne vorhersagbar und transparent macht.
  2. Übersetzen: Der KI-gesteuerte Datafold Migration Agent (DMA) konvertiert automatisch jeden SQL-Dialekt oder GUI-basierte Transformationslogik in die Syntax des Zielsystems (z. B. Migration von Oracle PL/SQL zu Snowflake SQL). Er verwendet eine intelligente Feedback-Schleife, um den Code iterativ zu verfeinern, bis eine perfekte funktionale Parität erreicht ist.
  3. Validieren: Hier glänzt die Kernfähigkeit des "Data Diffing" von Datafold. Es führt einen wertbasierten Vergleich jedes Datensatzes zwischen dem alten und dem neuen System durch und überprüft automatisch 100%ige Datengenauigkeit ohne manuelle Stichproben oder mühsames Skripting.
  4. Ausliefern: Nach erfolgreicher Validierung generiert Datafold umfassende Berichte und auditierbare Daten-Diff-Beweise. Dies liefert einen konkreten Nachweis der Datenparität, was die Freigabe durch Stakeholder beschleunigt und die sichere Stilllegung des Altsystems ermöglicht.

Für Datenqualitätstests in CI/CD:

  1. Integration: Verbinden Sie Datafold mit Ihrem Versionskontrollsystem, wie GitHub oder GitLab.
  2. Automatisierte Tests: Wenn ein Entwickler einen Pull Request mit Änderungen am Datentransformationscode (z. B. einem dbt-Modell) öffnet, wird Datafold automatisch ausgelöst, um einen Daten-Diff zwischen der Entwicklungs- und der Produktionsumgebung durchzuführen.
  3. Überprüfen und Bereitstellen: Die Ergebnisse werden als klarer, prägnanter Kommentar im Pull Request veröffentlicht. Dies ermöglicht es den Prüfern, die genauen Auswirkungen der Code-Änderungen auf die Daten auf Wertebene zu sehen und zu verhindern, dass Datenqualitätsprobleme jemals in die Produktion gelangen.

Kernfunktionen von Datafold

  • KI-gestützte Datenmigration (Datafold Migration Agent - DMA): Automatisiert den gesamten Migrationslebenszyklus, von der SQL-Code-Übersetzung über verschiedene Dialekte hinweg bis zur vollständigen End-to-End-Validierung. Es behandelt intelligent komplexe Randfälle wie unterschiedliche Datentypbehandlung, nicht-deterministische Funktionen und Zeichenkodierung, um eine bis zu 6-mal schnellere Migration zu ermöglichen.
  • Data Diffing: Eine leistungsstarke Validierungs-Engine, die effiziente, wertbasierte Vergleiche ganzer Datensätze durchführt, selbst bei solchen mit Milliarden von Zeilen. Sie identifiziert präzise alle Hinzufügungen, Löschungen oder Änderungen, um 100%ige Datenparität zu gewährleisten.
  • Proaktive CI/CD-Tests: Integriert sich direkt in den Entwicklungsworkflow (Shift-Left-Testing), um Datentransformationscode vor der Bereitstellung zu testen. Es beinhaltet eine Auswirkungsanalyse, um zu visualisieren, wie sich Änderungen auf nachgelagerte Tabellen, BI-Dashboards und Reverse-ETL-Pipelines auswirken.
  • Datenüberwachung & Beobachtbarkeit: Bietet ML-gestützte Anomalieerkennung zur Überwachung der Datengesundheit in der Produktion. Benutzer können Monitore als Code (YAML) oder über die Benutzeroberfläche für Metriken, Schemaänderungen und geplante datenbankübergreifende Diffs definieren, mit Echtzeit-Benachrichtigungen über Slack, PagerDuty und E-Mail.
  • Spalten-Level-Lineage: Liefert eine umfassende Karte der Datenabhängigkeiten, die über das Data Warehouse hinaus zu BI-Tools (Tableau, Looker, Power BI) und anderen Anwendungen reicht. Dies ist entscheidend für die Auswirkungsanalyse, die Ursachenanalyse und die Compliance.
  • Datenreplikationstests: Validiert kontinuierlich Daten zwischen Quell- und Zielsystemen in laufenden Replikationspipelines und stellt sicher, dass unternehmenskritische Daten jederzeit synchron und korrekt bleiben.

Anwendungsfälle für Datafold

  • Modernisierung des Datenstacks: Beschleunigen Sie Migrationen von Altsystemen (z. B. Oracle, Teradata, SQL Server) zu modernen Cloud-Datenplattformen (z. B. Snowflake, BigQuery, Databricks) drastisch. Zum Beispiel migrierte Faire über 5.000 Tabellen von Redshift zu Snowflake sechs Monate früher als geplant mit Datafold.
  • dbt-Entwicklung & -Tests: Steigern Sie die dbt-Workflows durch automatisches Testen jedes Pull Requests und stellen Sie sicher, dass Änderungen an dbt-Modellen keine Regressionen der Datenqualität verursachen.
  • Sicherstellung der Genauigkeit von BI-Dashboards: Verwenden Sie Spalten-Level-Lineage, um Daten von ihrer Quelle bis zu den BI-Dashboards zu verfolgen und sicherzustellen, dass Geschäftsberichte auf einer Grundlage zuverlässiger und genauer Daten erstellt werden.
  • Validierung von Replikationspipelines: Für Organisationen, die Datenaufnahme-Tools wie Fivetran oder Airbyte verwenden, kann Datafold regelmäßige Daten-Diffs planen, um zu zertifizieren, dass die Daten im Ziel-Warehouse perfekt mit der Quelle übereinstimmen.

Vorteile von Datafold

  • Beispiellose Geschwindigkeit: Verkürzt Migrationszeitpläne von Jahren auf Wochen durch die Automatisierung der arbeitsintensivsten Teile des Prozesses.
  • Garantierte Genauigkeit: Geht über einfache Zeilenzählungen hinaus zu einer erschöpfenden, wertbasierten Validierung und eliminiert das Risiko von Datenverlust oder -beschädigung.
  • Erhöhte Entwicklergeschwindigkeit: Fängt Datenfehler frühzeitig in der CI/CD-Pipeline ab und befähigt Ingenieure, Code schneller und mit größerem Vertrauen auszuliefern.
  • Proaktiv, nicht reaktiv: Implementiert eine "Shift-Left"-Philosophie für die Datenqualität und verhindert Probleme, bevor sie Produktionssysteme und Geschäftsabläufe beeinträchtigen können.
  • Verbessertes Vertrauen & Zusammenarbeit: Liefert auditierbare, unbestreitbare Beweise für die Datenqualität, was das Vertrauen bei den Geschäftsinteressenten aufbaut und Projektgenehmigungen rationalisiert.
  • Sichere & flexible Bereitstellung: Bietet mehrere Bereitstellungsmodelle (SaaS, Single-Tenant-VPC, Self-Hosted) und ist konform mit wichtigen Standards wie SOC2 Typ II, GDPR und HIPAA.

Preise und Pläne

Datafold bietet maßgeschneiderte Preise, die auf die einzigartigen Anforderungen jedes Teams zugeschnitten sind. Das Preismodell basiert hauptsächlich auf der Anzahl der Benutzer und dem Volumen der überwachten und getesteten Tabellen. Während die Plattform in der Regel als umfassende Lösung verkauft wird, können spezifische Funktionen wie einmalige Migrationskonvertierung und -validierung oder eigenständige Spalten-Level-Lineage separat erworben werden. Um ein genaues Preisangebot zu erhalten, sollten potenzielle Kunden das Vertriebsteam von Datafold kontaktieren, indem sie eine Demo auf ihrer offiziellen Website anfordern.

nao

nao ist ein revolutionärer KI-Code-Editor, der von Grund auf für Datenexperten entwickelt wurde. Er zielt darauf ab, den gesamten Daten-Workflow zu beschleunigen, vom Schreiben des Codes bis zur Bereitstellung von Pipelines, indem er sich tief in Ihr Datenökosystem integriert. Entwickelt für Datenanalysten, Analytics Engineers, Data Scientists und Data Engineers, agiert nao als intelligenter Partner, der den Kontext Ihrer Daten versteht, um Ihnen zu helfen, Code zu schreiben, der nicht nur syntaktisch korrekt, sondern auch semantisch fundiert und sicher für Ihre Produktionsumgebung ist.

Im Gegensatz zu generischen KI-Code-Assistenten verbindet sich nao direkt mit Ihrem Data Warehouse (unterstützt Plattformen wie Databricks, DuckDB und mehr). Diese native Integration ermöglicht es seiner KI, „datenbewusst“ zu sein und Vorschläge basierend auf Ihrem tatsächlichen Schema, Ihren Tabellenstrukturen und Spaltennamen zu machen. Dies eliminiert Rätselraten und reduziert Fehler erheblich. Das Herzstück von nao ist sein leistungsstarker KI-Agent, der über die einfache Code-Vervollständigung hinausgeht und zu einem Wächter Ihrer Datenqualität wird.

Wie man nao verwendet

Der Einstieg in nao ist ein unkomplizierter Prozess, der sich nahtlos in Ihren bestehenden Workflow integrieren lässt:

  1. Herunterladen und Installieren: Beginnen Sie, indem Sie die nao IDE kostenlos von der offiziellen Website herunterladen. Es ist eine eigenständige Anwendung, die auf Ihrem lokalen Rechner läuft.
  2. Verbinden Sie Ihr Data Warehouse: Der erste entscheidende Schritt ist, nao mit Ihrer Datenquelle zu verbinden. Diese sichere Verbindung ermöglicht es der KI, auf Ihre Schema-Metadaten zuzugreifen (nicht auf Ihre tatsächlichen Daten, die lokal bleiben), um kontextbezogene Unterstützung zu bieten.
  3. Beginnen Sie mit dem Codieren: Öffnen Sie ein SQL-Arbeitsblatt oder ein Python-Skript. Während Sie tippen, bietet die KI von nao eine intelligente Autovervollständigung für SQL-Abfragen und dbt-Modelle, die Ihre spezifischen Tabellen und Spalten kennt.
  4. Nutzen Sie den KI-Agenten: Verwenden Sie den dedizierten KI-Tab, um mit dem Agenten zu interagieren. Sie können ihn bitten, komplexe Abfragen zu generieren, dbt-Modelle zu erstellen, Dokumentationen zu schreiben oder Tests hinzuzufügen. Der Agent versteht den Kontext Ihres Projekts, einschließlich dbt-Modellen und Spalten-Level-Lineage.
  5. Vorschau und Diff: Bevor Sie Änderungen übernehmen, verwenden Sie die Funktion „Sofortige Diff-Vorschau“. Diese zeigt Ihnen die direkten Auswirkungen Ihres neuen Codes auf die Daten und hilft Ihnen, potenzielle Probleme zu erkennen und das Brechen von nachgelagerten Dashboards oder Berichten zu verhindern.
  6. Prüfungen ausführen und bereitstellen: Der Agent kann Datenqualitätsprüfungen und Ihre bestehenden Tests ausführen, um Ihren Code zu validieren. Sobald Sie zuversichtlich sind, können Sie Ihre Datenpipelines schneller und mit größerem Vertrauen bereitstellen.

Kernfunktionen von nao

  • KI-gestützter Code-Editor: Optimiert für SQL und Python mit intelligenter Autovervollständigung, Code-Generierung und konversationellen Analysefunktionen.
  • Native Data Warehouse-Integration: Verbindet sich direkt mit Ihren Datenquellen wie Databricks und DuckDB für schemabewusste KI-Vorschläge.
  • Fortschrittlicher KI-Agent: Ein vielseitiger Agent, der bei Datenqualitätsprüfungen, sofortigen Daten-Diffs, der Ausführung von Tests und dem Verständnis der Spalten-Level-Lineage hilft.
  • Tiefe dbt-Integration: Vorschau von dbt-Modellen direkt in der IDE, Autovervollständigung für Modellspalten und Visualisierung des Lineage-Graphen zum Verständnis von Abhängigkeiten.
  • Sofortige Diff-Vorschau: Sehen Sie die Auswirkungen Ihrer Code-Änderungen auf die Daten in Echtzeit, um unbeabsichtigte Folgen zu vermeiden.
  • Konversationelle Analytik & Diagramme: Interagieren Sie mit Ihren Daten in natürlicher Sprache, um Einblicke und Visualisierungen direkt im Editor zu generieren.
  • Sicherheit auf Unternehmensebene: Ihre Daten und Ihr Code bleiben lokal. Nichts wird ohne ausdrückliche Erlaubnis mit einer LLM geteilt, und Enterprise-Pläne bieten Optionen für selbst gehostete LLMs, um alles in Ihrer eigenen Infrastruktur zu halten.
  • Einheitliche Entwicklungsumgebung: Kombiniert die Werkzeuge, die Sie lieben – SQL-Editor, Transformationswerkzeug (dbt) und BI-Lineage – in einer einzigen, kohäsiven IDE.

Anwendungsfälle für nao

nao ist vielseitig und kann für zahlreiche datenbezogene Aufgaben eingesetzt werden:

  • Beschleunigte Entwicklung von Datenpipelines: Schnelles Erstellen und Iterieren von SQL- und Python-Pipelines mit KI-generiertem Code und sofortigem Feedback.
  • Robustes dbt-Workflow-Management: Effizienteres Erstellen, Testen und Dokumentieren von dbt-Modellen. Verstehen Sie die Auswirkungen von Änderungen mit Spalten-Level-Lineage und Modellvorschauen.
  • Komplexe Datenanalyse: Führen Sie anspruchsvolle Analysen wie Verteilungs-, Retentions-, Konversions- und Ursachenanalysen mit konversationellen Anweisungen und leistungsstarken Abfragewerkzeugen durch.
  • Datenqualitätssicherung: Proaktives Erkennen und Beheben von Datenqualitätsproblemen, bevor sie die Produktion beeinträchtigen, durch die Verwendung der automatisierten Prüfungen und Daten-Diffs des Agenten.
  • Sicheres Code-Refactoring: Refaktorieren Sie komplexe SQL-Abfragen oder dbt-Modelle selbstbewusst und verwenden Sie die sofortige Diff-Vorschau, um sicherzustellen, dass die Ausgabe konsistent bleibt.

Vorteile von nao

nao bietet erhebliche Vorteile gegenüber herkömmlichen Code-Editoren und anderen KI-Assistenten:

  • Datenbewusste Intelligenz: Im Gegensatz zu Werkzeugen wie Cursor sind die Vorschläge von nao nicht generisch; sie sind auf Ihr spezifisches Datenschema zugeschnitten, was zu Code führt, der beim ersten Mal korrekt funktioniert.
  • Erhöhte Sicherheit und Zuverlässigkeit: Der Fokus auf Datenqualitätsprüfungen, Diffs und Lineage-Impact-Analysen hilft, Datenbrüche zu verhindern und schützt Ihre BI-Dashboards und Analyseberichte.
  • Gesteigerte Produktivität: Durch die Vereinheitlichung mehrerer Werkzeuge in einer IDE und die Automatisierung wiederkehrender Aufgaben ermöglicht nao Datenteams, Projekte erheblich schneller bereitzustellen.
  • Kompromisslose Sicherheit: Mit einem starken Schwerpunkt auf Datenschutz stellt nao sicher, dass Ihre sensiblen Daten und Ihr proprietärer Code sicher sind, und bietet Kontrollen auf Unternehmensebene für maximalen Schutz.

Preise und Pläne

nao bietet eine flexible Preisstruktur für unterschiedliche Bedürfnisse:

  • Starter-Plan: Kostenlos. Dieser Plan beinhaltet eine 15-tägige Testversion der Pro-Funktionen, eine grundlegende Data-Warehouse-Verbindung, SQL-Autovervollständigung sowie dbt-Vorschauen und -Lineage.
  • Pro-Plan: 30 $ pro Benutzer/Monat. Beinhaltet alles aus dem Starter-Plan sowie den vollständigen KI-Tab für Ihre Daten, den kompletten KI-Agenten für Daten-Workflows, sofortige Daten-Diffs und direkten Support.
  • Enterprise-Plan: Individuelle Preise. Dieser Plan beinhaltet alle Pro-Funktionen sowie Datensicherheit auf Unternehmensebene, die Option für unternehmensgehostete LLMs, einen Unternehmensarbeitsbereich und ein dediziertes Support-Team.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
AnalysenDatenbank
Nur Datafold
Automatisierung
Nur nao
Code-Assistent

Tags

Gemeinsam
DatenbankDatenqualitätdbtSQL
Nur Datafold
AutomatisierungCI/CDDatenengineeringDatenmigrationDatenobservabilitätDatenprüfungDatenvalidierung
Nur nao
KI-AssistentAnalytics EngineeringCode-EditorDatenanalyseDatenpipelineEntwicklerwerkzeugePython

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Datafold
Keine verifizierten Daten
Nur nao
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Datafold monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
21K
Ø Besuchsdauer
1:16
Seiten pro Besuch
2.13
Absprungrate
39.96%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 33.5K
  • 2026-01: 24.6K
  • 2026-02: 19.6K
  • 2026-03: 26.3K
  • 2026-04: 20.8K
  • 2026-05: 21K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.41%11.4K
🇻🇳Vietnam13.86%2.9K
🇮🇳India12.19%2.6K
🇹🇭Thailand10.7%2.2K
🇵🇰Pakistan8.84%1.9K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt94.33%19.8K
Verweis5.67%1.2K

Suchbegriffe

data-diffdatafolddbt pythonnutrafol revenueopen source data warehouse

nao monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
19.1K
Ø Besuchsdauer
0:22
Seiten pro Besuch
1.73
Absprungrate
40.34%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 4K
  • 2026-01: 17.9K
  • 2026-02: 24.2K
  • 2026-03: 22.6K
  • 2026-04: 17.3K
  • 2026-05: 19.1K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States54.42%10.4K
🇮🇳India18.31%3.5K
🇫🇷France10.18%1.9K
🇩🇪Germany9.04%1.7K
🇧🇷Brazil8.05%1.5K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt57.37%11K
Verweis42.63%8.1K

Suchbegriffe

naonao datanao idenao labnao labs

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Datafold

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
183
Likes
182

nao

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
169
Likes
148

Datafold vs nao · Vergleichs-FAQ

What do Datafold and nao have in common?
Both tools are listed under Analysen、Datenbank. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Datafold and nao free?
Listed pricing models: Datafold — Paid; nao — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Datafold and nao?
The primary listed category is Analysen for Datafold, and Analysen for nao. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche