ToolMage
Anmelden

AI TOOL COMPARISON

Diffbot vs Hyperbrowser

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

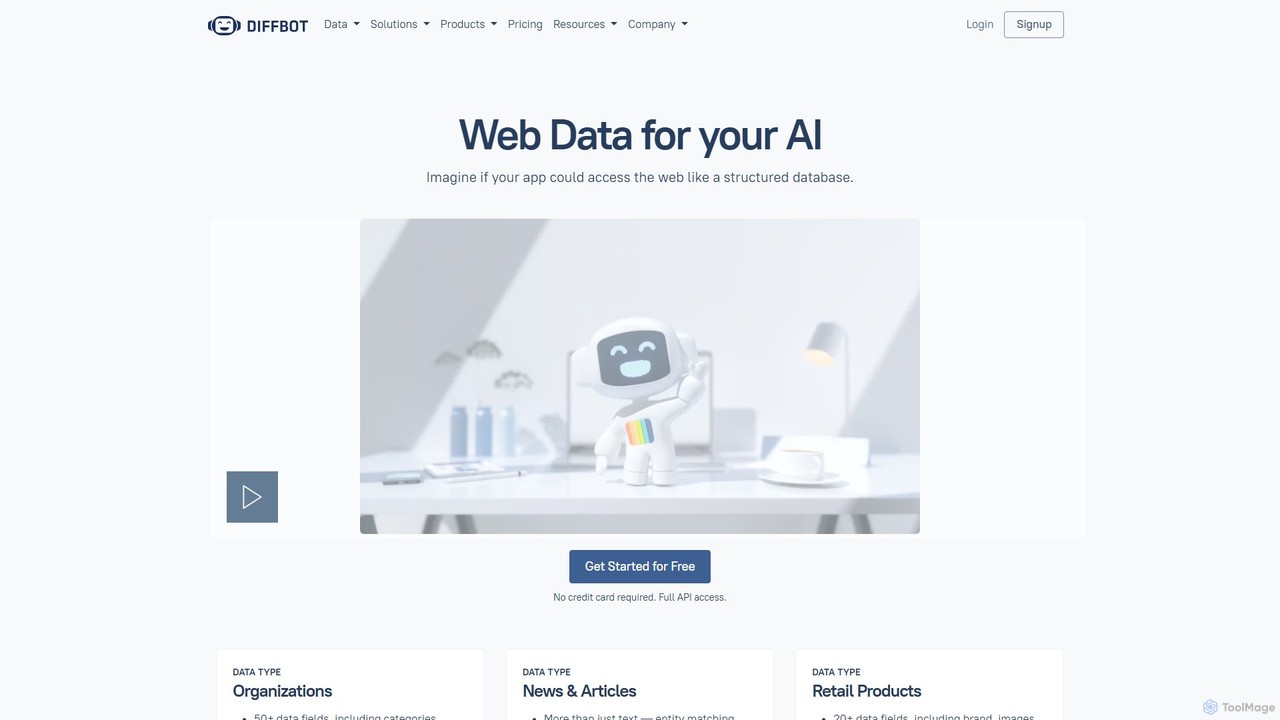
Diffbot Produktübersicht

Diffbot ist eine KI-gestützte Plattform, die das unstrukturierte Web in einen riesigen, strukturierten Wissensgraphen umwandelt. Sie bietet APIs für die Extraktion von Webdaten, Crawling und die Verarbeitung natürlicher Sprache, die es Unternehmen ermöglichen, auf saubere, organisierte Daten über Organisationen, Nachrichten, Produkte und mehr für Anwendungen in den Bereichen Finanzen, Marktintelligenz und Risikomanagement zuzugreifen.

Preview

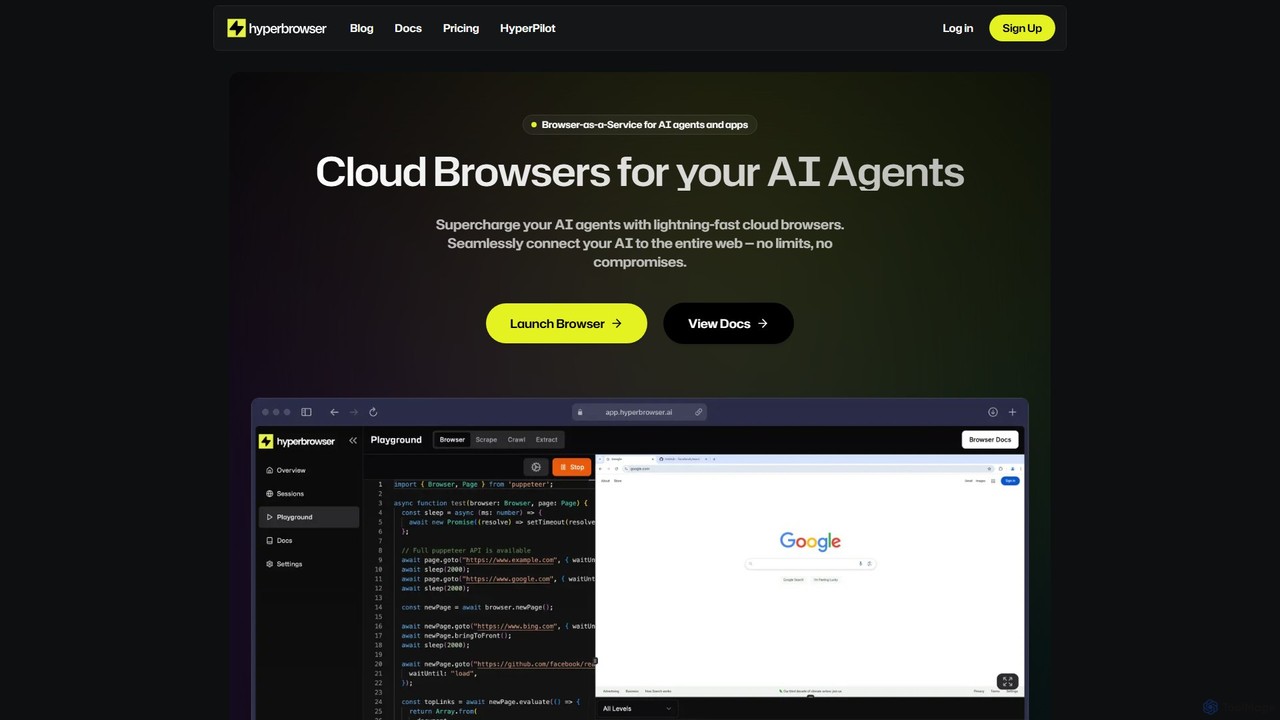
Hyperbrowser Produktübersicht

Hyperbrowser ist eine Browser-as-a-Service (BaaS)-Plattform, die für KI-Agenten und Entwickler konzipiert wurde. Sie bietet skalierbare, blitzschnelle Cloud-Browser zur Automatisierung von Web-Aufgaben, zur Datenextraktion und zur Ermöglichung von KI-gesteuerten Web-Interaktionen. Mit Funktionen wie Stealth-Browsing, automatischer Captcha-Lösung und entwicklerfreundlichen APIs ermöglicht sie komplexe Arbeitsabläufe ohne Grenzen.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Diffbot VS Hyperbrowser — Kerndaten
KerndatenDiffbotHyperbrowser
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusMarktintelligenzWeb Scraping
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienMarktintelligenz · Web Scraping · API · AutomatisierungWeb Scraping · API · Automatisierung
Added09.08.202505.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Diffbot

Diffbot bietet eine Suite von KI-gestützten Tools, die darauf ausgelegt sind, den Inhalt des öffentlichen Webs zu verstehen und zu strukturieren und es so effektiv in die weltweit größte und umfassendste Datenbank zu verwandeln. Im Kern steht der Diffbot Knowledge Graph, ein riesiges, vernetztes Repository von Daten über Organisationen, Personen, Artikel, Produkte und mehr. Im Gegensatz zu herkömmlichen Web-Scrapern, die manuelle Regeln für jede Website erfordern, verwendet Diffbot Computer Vision und die Verarbeitung natürlicher Sprache, um Webseiten automatisch wie ein Mensch zu interpretieren und strukturierte Daten ohne standortspezifische Konfigurationen zu extrahieren.

Diese Technologie ermöglicht es Entwicklern und Unternehmen, sich nicht mehr mit der lauten, chaotischen Natur von Webdaten auseinanderzusetzen und stattdessen darauf zuzugreifen, als wäre es eine saubere, strukturierte Datenbank. Ob Sie Nachrichten überwachen, Kundenprofile anreichern, Marktforschung betreiben oder ein maschinelles Lernmodell antreiben müssen, Diffbot liefert die sauberen, zuverlässigen Datenfeeds, die zum Erstellen intelligenter Anwendungen erforderlich sind.

Wie man Diffbot verwendet

Der Einstieg in Diffbot ist für Entwickler und Datenteams unkompliziert gestaltet. Die primäre Interaktion erfolgt über seine leistungsstarken APIs.

  1. Anmelden: Beginnen Sie mit der Erstellung eines Kontos. Diffbot bietet einen kostenlosen Plan mit 10.000 Credits und vollem API-Zugriff, mit dem Sie die Funktionen der Plattform ohne Kreditkarte testen können.
  2. Holen Sie sich Ihren API-Token: Nach der Registrierung erhalten Sie einen API-Token von Ihrem Dashboard. Dieser Token wird verwendet, um alle Ihre Anfragen an die Diffbot-APIs zu authentifizieren.
  3. Wählen Sie die richtige API: Diffbot bietet mehrere verschiedene APIs für unterschiedliche Aufgaben:
    • Extract API: Richten Sie sie auf eine beliebige URL (wie einen Artikel, eine Produktseite oder eine Forumsdiskussion), und sie gibt automatisch strukturierte JSON-Daten zurück. Es sind keine Regeln erforderlich.
    • Crawl API: Geben Sie eine Start-URL an, und Diffbot wird die gesamte Website systematisch crawlen und die Extract API verwenden, um jede relevante Seite in strukturierte Daten umzuwandeln. Dies ist ideal für den Aufbau einer Datenbank von einer bestimmten Website.
    • Knowledge Graph Search API: Fragen Sie den vorgefertigten Wissensgraphen ab, um Informationen zu über 246 Millionen Organisationen, 1,6 Milliarden Artikeln und mehr zu finden. Sie können nach Entitäten suchen und präzise Datenfeeds erstellen.
    • Knowledge Graph Enhance API: Stellen Sie Ihre eigenen Daten bereit (z. B. einen Firmennamen), und Diffbot wird sie mit umfassenden Daten aus dem Wissensgraphen anreichern, wie z. B. Umsatz, Mitarbeiterzahl, soziale Profile und aktuelle Nachrichten.
    • Natural Language API: Senden Sie Rohtext, um Entitäten, Beziehungen zwischen ihnen abzuleiten und eine Stimmungsanalyse durchzuführen.
  4. Integrieren und Erstellen: Verwenden Sie die API-Antworten (im JSON-Format), um Ihre Anwendungen zu betreiben, Ihre Datenbanken zu füllen oder Ihre Analyse-Dashboards zu speisen. Für Echtzeitanforderungen können Sie Webhooks für sofortige Benachrichtigungen einrichten, z. B. für neue Artikel, die ein bestimmtes Unternehmen erwähnen.

Kernfunktionen von Diffbot

  • Wissensgraph: Ein riesiger, vorgecrawlter und kontinuierlich aktualisierter Graph des Webs, der strukturierte Informationen über Organisationen, Personen, Produkte, Artikel und deren Beziehungen enthält.
  • Automatische Extraktion: KI-gesteuerte Technologie, die Schlüsselinformationen aus verschiedenen Seitentypen (Artikel, Produkte, Diskussionen usw.) automatisch identifiziert und extrahiert, ohne manuelle Einrichtung oder Regeln zu erfordern.
  • Crawlbot: Ein intelligenter Web-Crawler, der eine gesamte Website in eine strukturierte Datenbank umwandeln kann, indem er Inhalte von relevanten Seiten automatisch identifiziert und extrahiert.
  • Verarbeitung natürlicher Sprache (NLP): Erweiterte NLP-Funktionen zum Verstehen von Text in über 20 Sprachen, zur Durchführung der Entitätserkennung (Unterscheidung zwischen „Apple“ dem Unternehmen und „Apfel“ der Frucht) und zur Durchführung einer Stimmungsanalyse auf Themenebene.
  • Datenanreicherung (Enhance API): Die Fähigkeit, eine minimale Information wie einen Firmennamen oder eine E-Mail zu nehmen und sie mit Dutzenden von Datenpunkten aus dem Wissensgraphen anzureichern.
  • Echtzeit-Überwachung: Erstellen Sie benutzerdefinierte, rauschfreie Feeds für Nachrichten und Markenerwähnungen mit Echtzeit-Benachrichtigungen per E-Mail oder Webhooks.

Anwendungsfälle für Diffbot

Die strukturierten Daten von Diffbot sind in zahlreichen Branchen und Funktionen wertvoll:

  • Marktintelligenz: Verfolgen Sie Wettbewerber, überwachen Sie Branchentrends und analysieren Sie Marktbewegungen, indem Sie auf globale Nachrichten, Unternehmensberichte und Produktdaten zugreifen.
  • Risiko & Compliance: Führen Sie Due-Diligence-Prüfungen bei Unternehmen und Einzelpersonen durch, überwachen Sie Lieferketten auf Risikosignale und bleiben Sie regulatorischen Änderungen voraus.
  • Vertrieb & Marketing: Reichern Sie Lead-Daten in CRMs an, identifizieren Sie neue Interessenten anhand spezifischer Kriterien (z. B. Unternehmen in einer bestimmten Branche, die gerade eine Finanzierung erhalten haben) und personalisieren Sie die Kontaktaufnahme.
  • Nachrichten- & Medienüberwachung: Erstellen Sie hochspezifische Echtzeit-Nachrichtenfeeds, die Erwähnungen von Marken, Personen oder Themen mit präziser Entitätsübereinstimmung und Stimmungsanalyse verfolgen.
  • Personalbeschaffung: Erstellen Sie Datenbanken potenzieller Kandidaten, identifizieren Sie Talente und reichern Sie Berufsprofile mit Daten aus dem gesamten Web an.
  • Maschinelles Lernen: Verwenden Sie den Wissensgraphen als Quelle für hochwertige, strukturierte Trainingsdaten für verschiedene KI- und maschinelle Lernmodelle.

Vorteile von Diffbot

Der Hauptvorteil von Diffbot ist seine Fähigkeit, das gesamte Web als eine einzige, abfragbare Datenbank zu behandeln. Es abstrahiert die Komplexität des Web-Scrapings und der Datenbereinigung. Zu den Hauptvorteilen gehören Genauigkeit, Skalierbarkeit und Effizienz. Anstatt fragile, standortspezifische Scraper zu erstellen und zu warten, können sich Benutzer auf eine einzige, robuste API verlassen. Das entitätsbewusste NLP gewährleistet die Datenqualität und -relevanz, während der vorgefertigte Wissensgraph sofortigen Zugriff auf einen riesigen Datensatz bietet, dessen interner Aufbau Jahre dauern würde.

Preise und Pläne

Diffbot bietet eine gestaffelte Preisstruktur, um unterschiedliche Nutzungsniveaus zu berücksichtigen, von Hobbyprojekten bis hin zu großen Unternehmen.

  • Kostenloser Plan: 0 $/Monat. Beinhaltet 10.000 Credits, vollen API-Zugriff und ist für immer kostenlos. Ideal zum Testen und für kleine Projekte.
  • Startup-Plan: 299 $/Monat. Beinhaltet 250.000 Credits und ist für kleine Teams konzipiert, die Plug-and-Play-Scraping und Zugriff auf den Wissensgraphen benötigen.
  • Plus-Plan: 899 $/Monat. Beinhaltet 1.000.000 Credits, Zugriff auf das Crawl-Produkt und höhere API-Aufrufraten. Geeignet für wachsende Unternehmen mit größeren Datenanforderungen.
  • Enterprise-Plan: Benutzerdefinierte Preise. Bietet maßgeschneiderte Pläne mit benutzerdefinierten Credit-Zuteilungen, den höchsten API-Aufrufraten, Premium-SLA-Support und verwalteten Lösungen für große Datenoperationen.

Credits werden basierend auf dem Typ und der Komplexität des API-Aufrufs verbraucht. Eine detaillierte Aufschlüsselung ist auf ihrer Website verfügbar.

Hyperbrowser

Hyperbrowser ist eine leistungsstarke Browser-as-a-Service (BaaS)-Plattform, die entwickelt wurde, um KI-Agenten und -Anwendungen mit dem gesamten Web zu verbinden. Sie bietet Entwicklern Zugang zu einer Flotte von schnellen, sicheren und skalierbaren Cloud-Browsern und beseitigt die Komplexität der Verwaltung lokaler Browser-Instanzen. Dieser Dienst ist speziell für anspruchsvolle Aufgaben wie groß angelegtes Web-Scraping, Browser-Automatisierung und die Befähigung hochentwickelter KI-Agenten konzipiert, mit Websites wie ein Mensch zu interagieren. Durch die Bereitstellung von Headless-Browsern in isolierten Containern gewährleistet Hyperbrowser Zuverlässigkeit, Sicherheit und Spitzenleistung für jedes Projekt, von der einfachen Datenextraktion bis hin zu komplexen, unternehmenskritischen automatisierten Arbeitsabläufen.

Wie man Hyperbrowser verwendet

Der Einstieg in Hyperbrowser ist ein unkomplizierter Prozess, der für Entwickler konzipiert wurde. Zuerst melden Sie sich auf der Website an, um ein Konto zu erstellen und Ihren einzigartigen API-Schlüssel zu erhalten. Sie können mit dem großzügigen kostenlosen Plan beginnen, für den keine Kreditkarte erforderlich ist. Sobald Sie Ihren Schlüssel haben, können Sie Hyperbrowser mithilfe seiner entwicklerfreundlichen SDKs für Python und NodeJS oder durch direkte cURL-Anfragen an seine API in Ihre Anwendung integrieren. Die Plattform bietet klare Dokumentationen und Codebeispiele, einschließlich Integrationen mit beliebten KI-Frameworks wie OpenAI Tools und Anthropic Tools. Sie können beispielsweise eine Browser-Sitzung starten, einem KI-Agenten eine Aufgabe zuweisen (z. B. 'Bestelle Knoblauchnudeln von Burma Love auf Doordash') und Hyperbrowser die gesamte Web-Interaktion verwalten lassen, der dann das strukturierte Ergebnis zurückgibt.

Kernfunktionen von Hyperbrowser

  • Skalierbare Cloud-Browser: Führen Sie über 1.000 gleichzeitige Browser ohne Leistungsabfall aus, die in weniger als 500 ms für sofortige Skalierung starten.
  • Fortgeschrittene Browser-Automatisierung: Automatisieren Sie jede browserbasierte Aufgabe, einschließlich komplexem Web-Scraping, automatisierten Tests und dem Ausfüllen von Formularen auf mehreren Websites.
  • KI-Agenten-Integration: Verbinden Sie sich nahtlos mit KI-Agenten von Frameworks wie OpenAI und Anthropic, damit diese im Web surfen, Daten sammeln und mit Webanwendungen interagieren können, um Aufgaben zu erledigen.
  • Automatische Captcha-Lösung: Die integrierte Captcha-Verarbeitung löst automatisch verschiedene Arten von Captchas (einschließlich reCAPTCHA), um sicherzustellen, dass Ihre Automatisierungs-Workflows ununterbrochen laufen.
  • Stealth-Browsing: Arbeiten Sie im erweiterten Stealth-Modus, um hochentwickelte Bot-Erkennungssysteme zu umgehen und hohe Erfolgsraten bei der Datenerfassung und Automatisierung zu gewährleisten.
  • Robustes Sitzungsmanagement: Verwalten Sie Browser-Sitzungen mit Funktionen wie Protokollierung, Debugging, sicherer Ressourcenisolierung und der Möglichkeit, Benutzerprofile wiederzuverwenden, um wiederholte Anmeldungen zu vermeiden.
  • Entwicklerfreundliche API: Eine einfache und leistungsstarke API mit offiziellen SDKs für Python und NodeJS, die die Integration in Ihren bestehenden Tech-Stack reibungslos und effizient macht.

Anwendungsfälle für Hyperbrowser

Hyperbrowser ist vielseitig und kann in einer Vielzahl von Szenarien angewendet werden. Zu den Hauptanwendungsfällen gehören: Groß angelegtes Web-Scraping, bei dem Benutzer Daten von Millionen von Seiten extrahieren und strukturieren können, z. B. das Scrapen von Google-Suchergebnissen oder E-Commerce-Websites wie Shopify, ohne blockiert zu werden. Eine weitere wichtige Anwendung ist die Steuerung von KI-Web-Agenten, die komplexe Aktionen wie das Buchen von Terminen, das Tätigen von Einkäufen oder die Durchführung detaillierter Wettbewerbsanalysen durchführen können. Es ist auch von unschätzbarem Wert für automatisierte Softwaretests, die es Entwicklern ermöglichen, End-to-End-Tests in realen Browser-Umgebungen in großem Maßstab durchzuführen. Darüber hinaus nutzen Unternehmen es für Marktforschung und Wettbewerbsanalyse, indem sie die Erfassung von Daten zu Preisen, Produkten und Marketingstrategien der Wettbewerber automatisieren.

Vorteile von Hyperbrowser

Der Hauptvorteil von Hyperbrowser ist seine Fähigkeit, eine skalierbare, zuverlässige und unauffindbare Browser-Automatisierung bereitzustellen. Die Plattform garantiert eine Verfügbarkeit von 99,9 %, was sie für unternehmenskritische Anwendungen geeignet macht. Ihre blitzschnellen Browser-Startzeiten von unter einer Sekunde ermöglichen eine schnelle Skalierung bei Bedarf. Die integrierte Fehlertoleranz und die automatischen Wiederherstellungsmechanismen stellen sicher, dass die Arbeitsabläufe widerstandsfähig und zuverlässig sind. Am wichtigsten ist, dass seine fortschrittlichen Stealth-Fähigkeiten und die automatische Captcha-Lösung die Erfolgsrate von Web-Automatisierungsaufgaben, die sonst durch Anti-Bot-Maßnahmen blockiert würden, erheblich erhöhen.

Preise und Pläne

Hyperbrowser bietet eine flexible, transparente Preisstruktur mit einem Freemium-Modell, das auf unterschiedliche Bedürfnisse zugeschnitten ist.
Kostenloser Plan: 0 $/Monat, beinhaltet 1.000 Credits, 1 gleichzeitigen Browser, 7 Tage Datenspeicherung und grundlegenden Stealth-Modus.
Startup-Plan: 30 $/Monat (plus Nutzung), beinhaltet 30.000 Credits, 25 gleichzeitige Browser, 30 Tage Datenspeicherung, automatische Captcha-Lösung und grundlegenden Stealth-Modus.
Scale-Plan: 100 $/Monat (plus Nutzung), beinhaltet 100.000 Credits, 100 gleichzeitige Browser, 30 Tage Datenspeicherung, automatische Captcha-Lösung und erweiterten Stealth-Modus.
Enterprise-Plan: Individuelle Preise für hohe Volumenanforderungen, bietet über 250 gleichzeitige Browser, über 180 Tage Datenspeicherung, Premium-Support und Compliance-Optionen wie HIPAA/SOC 2.
Die Nutzung wird mit 0,001 $ pro Credit, 0,10 $ pro Browser-Stunde und 10 $ pro GB Proxy-Daten abgerechnet.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Web ScrapingAPIAutomatisierung
Nur Diffbot
Marktintelligenz
Nur Hyperbrowser
Keine verifizierten Daten

Tags

Gemeinsam
APIDatenextraktionEntwicklerwerkzeugeWeb Scraping
Nur Diffbot
Business IntelligenceDatenanreicherungWissensgraphMarktintelligenznatürliche SprachverarbeitungNachrichtenüberwachungWeb-Crawling
Nur Hyperbrowser
KI-AgentBrowser-AutomatisierungCaptcha-LösungHeadless BrowserHeimliches Browsing

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Diffbot
Keine verifizierten Daten
Nur Hyperbrowser
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Diffbot monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
47.2K
Ø Besuchsdauer
0:36
Seiten pro Besuch
2.02
Absprungrate
38.73%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 65.5K
  • 2026-01: 49.6K
  • 2026-02: 69.2K
  • 2026-03: 61.7K
  • 2026-04: 44.6K
  • 2026-05: 47.2K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States31.36%14.8K
🇳🇬Nigeria28.45%13.4K
🇮🇳India20.17%9.5K
🇬🇧United Kingdom11.29%5.3K
🇵🇰Pakistan8.73%4.1K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt89.5%42.2K
Verweis8.3%3.9K
E-Mail2.2%1K

Suchbegriffe

crawlydifbotdiffbotdiffbot apiwebsite content extractor

Hyperbrowser monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
71.4K
Ø Besuchsdauer
0:38
Seiten pro Besuch
2.21
Absprungrate
40.26%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 34.5K
  • 2026-01: 71.4K
  • 2026-02: 66.8K
  • 2026-03: 67.3K
  • 2026-04: 56.7K
  • 2026-05: 71.4K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States43.97%31.4K
🇮🇳India28.23%20.2K
🇻🇳Vietnam12.18%8.7K
🇧🇷Brazil8.2%5.9K
🇩🇪Germany7.42%5.3K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt91.73%65.5K
Verweis7.22%5.2K
E-Mail1.05%750

Suchbegriffe

hyper agenthyperagenthyper browserhyperbrowserhyperbrowser ai

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Diffbot

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
196
Likes
188

Hyperbrowser

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
153
Likes
162

Diffbot vs Hyperbrowser · Vergleichs-FAQ

What do Diffbot and Hyperbrowser have in common?
Both tools are listed under Web Scraping、API、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Diffbot and Hyperbrowser free?
Listed pricing models: Diffbot — Freemium; Hyperbrowser — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Diffbot and Hyperbrowser?
The primary listed category is Marktintelligenz for Diffbot, and Web Scraping for Hyperbrowser. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche