ToolMage
Anmelden

AI TOOL COMPARISON

dstack vs Modelbit

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

dstack Produktübersicht

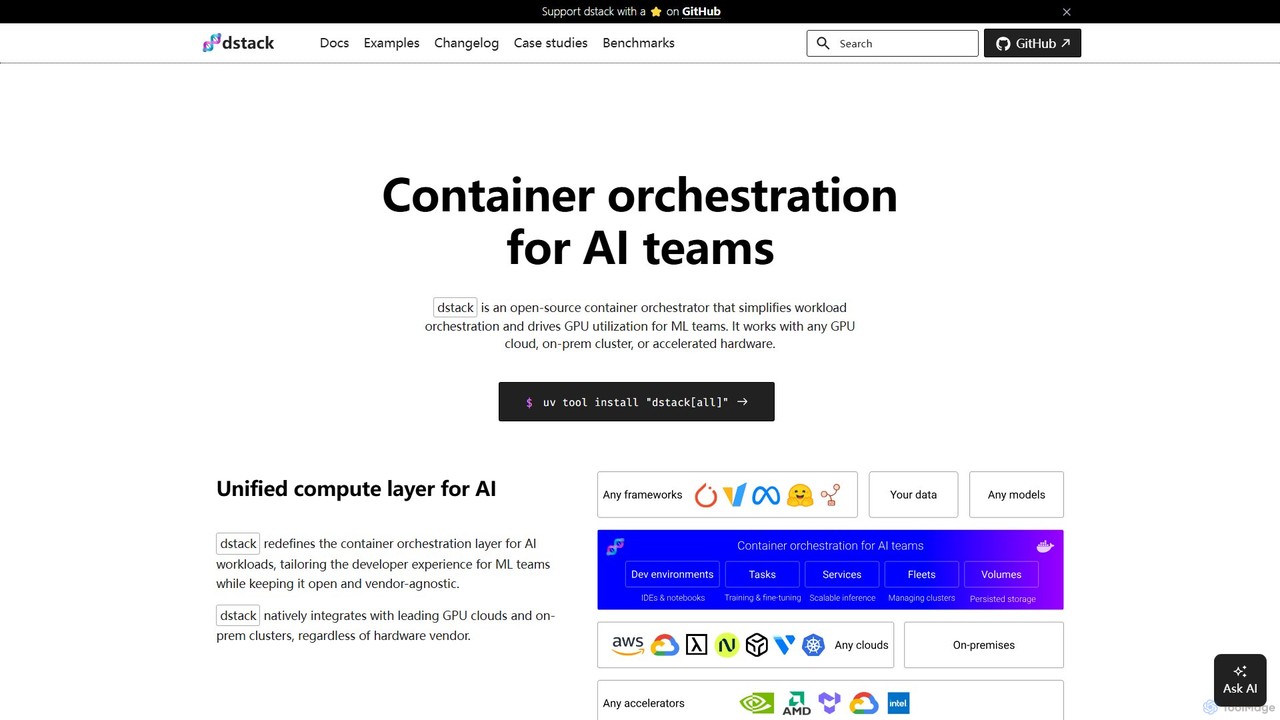
dstack ist ein Open-Source-Container-Orchestrator, der für KI- und ML-Teams entwickelt wurde. Er vereinfacht die Workload-Orchestrierung und maximiert die GPU-Auslastung über jeden Cloud-Anbieter, On-Premise-Cluster oder beschleunigte Hardware hinweg. Er bietet eine einheitliche Rechenschicht und optimiert Entwicklung, Training und Modellbereitstellung.

Preview

Modelbit Produktübersicht

Modelbit ist eine MLOps-Plattform zur Bereitstellung von Machine-Learning-Modellen direkt aus Python-Notebooks in die Produktion. Es bietet einen Infrastructure-as-Code-Workflow, der es Datenwissenschaftlern ermöglicht, Modelle mit einer einzigen Codezeile und einem Git-Push bereitzustellen, zu hosten, zu skalieren und zu verwalten.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

dstack VS Modelbit — Kerndaten
KerndatendstackModelbit
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusOrchestrierungMLOps
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienOrchestrierung · MLOps · InfrastrukturmanagementMLOps · Automatisierung
Added08.08.202502.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

dstack

dstack ist ein leistungsstarker Open-Source-Container-Orchestrator, der speziell entwickelt wurde, um die Herausforderungen von KI- und Machine-Learning-Teams zu bewältigen. Sein Hauptziel ist es, den komplexen Prozess der Workload-Orchestrierung zu vereinfachen und die Auslastung teurer GPU-Ressourcen erheblich zu verbessern. Als anbieterunabhängige Plattform bietet dstack eine einheitliche Rechenschicht, die sich nahtlos in jede GPU-Cloud (wie AWS, GCP, Azure, OCI), On-Premise-Cluster und eine breite Palette beschleunigter Hardware, einschließlich NVIDIA, AMD, TPUs und mehr, integriert. Diese Flexibilität stellt sicher, dass Teams nicht an einen einzigen Anbieter gebunden sind und die beste Hardware für ihre Bedürfnisse nutzen können, wo immer sie sich befindet.

Die Plattform ist auf die Entwicklererfahrung ausgerichtet und abstrahiert die zugrunde liegende Infrastrukturkomplexität. Dies ermöglicht es ML-Ingenieuren und Forschern, sich auf das Erstellen, Trainieren und Bereitstellen von Modellen zu konzentrieren, anstatt Server, Abhängigkeiten und Skalierung zu verwalten. dstack wird von erstklassigen ML-Teams bei Unternehmen wie Electronic Arts und Mobius Labs für seine Fähigkeit geschätzt, von schnellem Prototyping bis hin zu großen, verteilten Trainingsjobs mit mehreren Knoten zu skalieren.

Wie man dstack verwendet

Der Einstieg in dstack ist ein unkomplizierter Prozess, der für eine schnelle Einführung konzipiert ist:

  1. Server einrichten: Sie können beginnen, indem Sie den dstack-Server auf Ihrem lokalen Rechner mit einem einfachen Befehl wie uv tool install "dstack[all]" installieren und mit dstack server ausführen. Alternativ können Sie ihn überall mit dem offiziellen Docker-Image bereitstellen oder sich für dstack Sky, die verwaltete Cloud-Version, anmelden, um das Hosting selbst zu vermeiden.
  2. Konfigurationen definieren: Workflows in dstack werden über einfache YAML-Dateien in Ihrem Projekt-Repository definiert. Diese Konfigurationen beschreiben die Umgebung, Ressourcen und Befehle für Ihre Aufgaben. Zu den wichtigsten Konfigurationstypen gehören:
    • Entwicklungsumgebungen (Dev Environments): Für interaktive Entwicklung, die es Ihnen ermöglicht, Ihre lokale IDE (wie VS Code) mit einer leistungsstarken Remote-GPU-Maschine zu verbinden.
    • Aufgaben (Tasks): Zum Planen von Batch-Jobs, wie z. B. das Vortrainieren oder Feinabstimmen von Modellen. Ideal für Workloads, die bis zum Abschluss laufen.
    • Dienste (Services): Zum Bereitstellen von Modellen als sichere, automatisch skalierende, OpenAI-kompatible Endpunkte.
    • Flotten (Fleets): Zur Verwaltung von Gruppen von Cloud- oder On-Premise-Instanzen als einzelner Ressourcenpool.
  3. Konfigurationen anwenden: Sobald Ihre YAML-Datei fertig ist, wenden Sie sie über die Befehlszeilenschnittstelle an: dstack apply. dstack kümmert sich dann um den Rest: Bereitstellung der notwendigen Infrastruktur, Planung des Jobs, Verwaltung der automatischen Skalierung, Handhabung der Portweiterleitung und Streaming der Protokolle zurück zu Ihrem Terminal. Für eine losgelöste Ausführung können Sie das Flag -d verwenden.

Kernfunktionen von dstack

  • Einheitliche Rechenschicht: Bietet eine einzige, anbieterunabhängige Steuerungsebene für alle Ihre KI-Rechenressourcen, ob in der Cloud oder vor Ort.
  • Breite Unterstützung für Beschleuniger: Unterstützt nativ eine breite Palette von Hardware, einschließlich NVIDIA-GPUs, AMD-GPUs, Google Cloud TPUs, Intel Gaudi und Tenstorrent-Beschleunigern.
  • Entwicklerzentrierte Workflows: Bietet spezialisierte Konfigurationen wie Entwicklungsumgebungen für interaktives Codieren, Aufgaben für die Stapelverarbeitung und Dienste für die einfache Modellbereitstellung.
  • Effizientes Ressourcenmanagement: Verfügt über einen integrierten Scheduler zur Maximierung der GPU-Auslastung. Es enthält Richtlinien zur automatischen Beendigung von nicht ausgelasteten Instanzen, um Kosten zu sparen.
  • Nahtlose Integration: Funktioniert reibungslos mit führenden GPU-Clouds (AWS, GCP, Azure, OCI) und kann auf bestehenden Kubernetes-Clustern ausgeführt werden. SSH-Flotten ermöglichen die Anbindung von Bare-Metal-Servern.
  • Automatisch skalierende Dienste: Stellen Sie Modelle einfach als produktionsreife Dienste mit Funktionen wie automatischer Skalierung, HTTPS und OpenAI-kompatiblen API-Endpunkten bereit.
  • Datenpersistenz: Unterstützt Netzwerk- und Instanz-Volumes, um Daten, Modelle und Caches über Läufe hinweg zu persistieren und sicherzustellen, dass der Zustand nicht verloren geht.
  • Erweiterte Konfiguration: Ermöglicht eine feingranulare Steuerung mit Funktionen wie Wiederholungsrichtlinien bei Kapazitätsproblemen, Verwaltung von Umgebungsvariablen und Unterstützung für benutzerdefinierte Docker-Images.

Anwendungsfälle für dstack

dstack ist vielseitig und unterstützt eine breite Palette von ML-Workflows:

  • Modelltraining und Feinabstimmung: Führen Sie Einzelknoten- oder verteilte Trainingsjobs für große Sprachmodelle (LLMs) mit beliebten Frameworks wie TRL, Axolotl und DeepSpeed aus.
  • Inferenz und Modell-Serving: Stellen Sie optimierte Modelle für die Inferenz mit leistungsstarken Serving-Frameworks wie vLLM, SGLang, TGI und NVIDIA NIM bereit.
  • Interaktive KI-Entwicklung: ML-Ingenieure können in Sekundenschnelle leistungsstarke GPU-gestützte Entwicklungsumgebungen einrichten und ihre lokale IDE verbinden, um Code interaktiv zu experimentieren und zu debuggen.
  • Hochleistungs-Cluster-Management: Richten Sie Tests (z. B. NCCL-Tests) auf spezialisierten Multi-Node-Clustern wie GCP A3 Mega oder AWS EFA-fähigen Instanzen ein, konfigurieren und führen Sie sie aus.
  • Cloud-übergreifende Kostenoptimierung: Vergleichen und nutzen Sie mühelos die kostengünstigsten GPU-Instanzen verschiedener Cloud-Anbieter für jede gegebene Aufgabe.

Vorteile von dstack

Der Hauptvorteil von dstack ist seine Fähigkeit, die KI-Infrastruktur drastisch zu vereinfachen. Es befähigt ML-Teams, indem es ihnen ermöglicht, sich auf ihre Forschung und Modelle anstatt auf die Infrastruktur zu konzentrieren. Zu den wichtigsten Vorteilen gehören eine gesteigerte Produktivität, erhebliche Kosteneinsparungen durch eine bessere GPU-Auslastung und den Zugang zu Spot-Instanzen sowie die Vermeidung von Anbieterabhängigkeit (Vendor Lock-in). Seine Open-Source-Natur fördert Transparenz und eine von der Community getriebene Entwicklung, während das entwicklerzentrierte Design es unglaublich einfach macht, eine Konfiguration zu definieren und auszuführen, ohne sich um die GPU-Verfügbarkeit oder komplexe Setups kümmern zu müssen.

Preise und Pläne

dstack bietet eine flexible Preisstruktur, um unterschiedlichen Bedürfnissen gerecht zu werden:

  • dstack (Open-Source): Die Kernplattform ist Open-Source und kostenlos nutzbar. Sie können sie auf Ihrer eigenen Infrastruktur ohne Lizenzgebühren selbst hosten.
  • dstack Sky: Ein verwalteter Cloud-Dienst, der das Hosting des dstack-Servers für Sie übernimmt. Er bietet auch Zugang zu einem Marktplatz der günstigsten GPUs. Es wird eine kostenlose Stufe zum Einstieg angeboten.
  • dstack Enterprise: Eine selbst gehostete Version für größere Organisationen, die unternehmensweite Funktionen wie Single Sign-On (SSO), erweiterte Governance-Kontrollen und dedizierten Unternehmenssupport umfasst. Eine Testversion kann für diese Version angefordert werden.

Dieses Modell macht dstack für einzelne Forscher, Start-ups und große Unternehmen gleichermaßen zugänglich.

Modelbit

Modelbit ist eine umfassende Infrastructure-as-Code-Plattform, die entwickelt wurde, um die Bereitstellung und Verwaltung von Machine-Learning-Modellen in Produktionsumgebungen zu optimieren. Sie zielt speziell auf Teams mit anspruchsvollen ML-Infrastrukturanforderungen ab und schließt die Lücke zwischen der Modellentwicklung in Python-Notebooks und robusten, skalierbaren Produktionssystemen. Die Plattform kümmert sich um den gesamten operativen Lebenszyklus, einschließlich Bereitstellung, Staging, Hosting, Autoskalierung, Neutraining, Drift-Erkennung und Shadow-Deployments, alles verwaltet durch Code und Konfiguration in einem Git-Repository.

Mit Modelbit können Datenwissenschaftler ihre Modelle in wenigen Minuten von einem Jupyter- oder Colab-Notebook zu einem live, skalierbaren API-Endpunkt bringen. Die Kernphilosophie besteht darin, Datenwissenschaftlern die Arbeit in ihrer bevorzugten Umgebung zu ermöglichen und gleichzeitig einen nahtlosen, automatisierten Weg in die Produktion zu bieten, wodurch die traditionelle Reibung und die langen Vorlaufzeiten bei der ML-Bereitstellung entfallen.

Wie man Modelbit verwendet

Der Workflow ist auf Einfachheit und Integration in bestehende Data-Science- und Engineering-Praktiken ausgelegt:

  1. Entwicklung im Notebook: Trainieren und finalisieren Sie Ihr Machine-Learning-Modell in Ihrer bevorzugten Python-Umgebung, wie z.B. einem Jupyter-Notebook oder Google Colab.
  2. Importieren und Bereitstellen: Importieren Sie die Modelbit-Bibliothek in Ihr Notebook. Rufen Sie die Funktion `modelbit.deploy()` auf, sobald Ihr trainiertes Modell und alle notwendigen Datenverarbeitungsfunktionen bereit sind. Dieser einzelne Befehl startet den Bereitstellungsprozess.
  3. Automatisierte Paketierung: Modelbit erfasst automatisch Ihr Modell, seine Code-Abhängigkeiten und die spezifische Python-Umgebung (einschließlich Paketversionen) und stellt so eine perfekte Replikation in der Produktion sicher.
  4. Git-basierte Verwaltung: Verbinden Sie Ihr Modelbit-Konto mit einem GitHub-Repository. Bereitstellungen werden über Git verwaltet. Zum Beispiel wird durch das Pushen von Code in einen 'staging'-Branch das Modell in einer Staging-Umgebung bereitgestellt, während das Mergen in den 'main'-Branch es in die Produktion befördert.
  5. Zugriff und Skalierung: Nach der Bereitstellung generiert Modelbit automatisch eine eindeutige REST-API und eine Snowflake-API für Ihr Modell. Sie können dann die Weboberfläche oder die CLI verwenden, um die Leistung zu überwachen, Protokolle anzuzeigen, verschiedene Versionen zu verwalten, A/B-Tests einzurichten oder bei Bedarf auf eine frühere Version zurückzusetzen. Das System skaliert die Ressourcen, einschließlich GPUs, automatisch je nach Datenverkehr.

Kernfunktionen von Modelbit

  • Direkte Notebook-Bereitstellung: Wechseln Sie mit dem Befehl `modelbit.deploy()` von einem Modell in einem Notebook zu einer Produktions-API und eliminieren Sie komplexe manuelle Schritte.
  • Git-basiertes MLOps (Infrastructure-as-Code): Verwalten Sie Ihren gesamten ML-Bereitstellungslebenszyklus über Git. Jeder `git push` erstellt eine neue, versionierte und idempotente Bereitstellung.
  • Automatische API-Generierung: Jede Modellversion erhält ihre eigene containerisierte Umgebung mit einer eindeutigen REST-API und Snowflake-API, die zur Integration bereitsteht.
  • Autoskalierung und GPU-Unterstützung: Bereitstellungen sind containerisiert und isoliert, mit automatischer Skalierung zur Bewältigung variabler Lasten. Volle Unterstützung für GPU-intensive Modelle wie große Vision-Transformer.
  • Erweiterte Bereitstellungsstrategien: Unterstützt nativ Shadow-Deployments zum Testen neuer Modelle mit Produktionsverkehr ohne Beeinträchtigung der Benutzer, A/B-Tests zwischen Versionen und sofortige Rollbacks.
  • Hybrid-Cloud-Flexibilität: Führen Sie Modelle in der sicheren, mandantenfähigen Cloud von Modelbit aus oder stellen Sie sie in Ihrer eigenen Cloud-Umgebung (VPC) bereit, um maximale Kontrolle und Datenschutz zu gewährleisten.
  • Umgebungsparität: Erfasst und erstellt automatisch die exakte Python-Umgebung neu und verhindert so das häufige Problem „auf meiner Maschine funktioniert es“.

Anwendungsfälle für Modelbit

Modelbit wird von Unternehmen für anspruchsvolle Echtzeitanwendungen vertraut:

  • Echtzeit-Bedrohungserkennung: Unternehmen wie Ambient AI nutzen Modelbit, um große, multimodale Computer-Vision-Modelle bereitzustellen, die Sicherheitsaufnahmen in Echtzeit analysieren, um Bedrohungen zu erkennen, und dabei die GPU-Unterstützung und die schnellen Iterationsmöglichkeiten nutzen.
  • Fintech und Risikobewertung: Wird zur Bereitstellung von Modellen zur Betrugserkennung und Kreditvergabe verwendet, bei denen hohe Verfügbarkeit (99,99 % Betriebszeit) und geringe Latenz entscheidend sind.
  • Logistik und E-Commerce: Teams bei Unternehmen wie Inventa stellen Modelle bereit, um prognostizierte Lieferzeiten zu verkürzen und Bestellvolumina vorherzusagen, wodurch die Geschäftsabläufe direkt optimiert werden.
  • Gesundheitswesen und Biowissenschaften: OM1 nutzt Modelbit, um ML-Anwendungen zu betreiben, die bei der Erkennung seltener Krankheiten helfen, und demonstriert damit seine Fähigkeit, komplexe und sensible Workloads zu bewältigen.

Vorteile von Modelbit

Die Plattform bietet erhebliche Vorteile für ML-Teams:

  • Geschwindigkeit und Agilität: Reduziert die Bereitstellungszyklen von Monaten oder Wochen auf nur wenige Minuten, was schnellere Experimente und die Bereitstellung neuer Funktionen ermöglicht.
  • Stärkung der Datenwissenschaftler: Gibt Datenwissenschaftlern die Autonomie, ihre eigenen Modelle bereitzustellen und zu verwalten, wodurch DevOps- und ML-Engineering-Ressourcen freigesetzt werden.
  • Produktionsreife Zuverlässigkeit: Gebaut für unternehmenskritische Systeme mit Funktionen wie Container-Isolierung, idempotenten Bereitstellungen und einer nachgewiesenen Betriebszeit von 99,99 %.
  • Nahtlose Integration: Passt perfekt in moderne Data-Science- (Python, Notebooks) und Software-Engineering- (Git, CI/CD) Workflows.
  • Kosteneffektiv: Die Autoskalierungsfunktion stellt sicher, dass Sie zu jedem Zeitpunkt nur die benötigten Rechenressourcen nutzen und bezahlen.

Preise und Pläne

Modelbit arbeitet nach einem Freemium-Modell. Es bietet eine kostenlose Stufe, die es einzelnen Entwicklern und kleinen Teams ermöglicht, die Plattform auszuprobieren und Modelle bereitzustellen. Für größere Teams und Unternehmensanwendungsfälle mit Anforderungen wie Hybrid-Cloud-Bereitstellungen, erweiterten Sicherheitsfunktionen und dediziertem Support sind Pläne mit individueller Preisgestaltung verfügbar. Für die genauesten und aktuellsten Preisinformationen wird empfohlen, die offizielle Modelbit-Website zu besuchen.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
MLOps
Nur dstack
OrchestrierungInfrastrukturmanagement
Nur Modelbit
Automatisierung

Tags

Gemeinsam
Infrastruktur als Codemaschinelles LernenMLOpsModellbereitstellung
Nur dstack
KI-EntwicklungCloud ComputingContainer-OrchestrierungGPU-VerwaltungKubernetesOpen Source
Nur Modelbit
KI-EntwicklertoolsAutoscalingCI/CD für MLDatenwissenschaftModell-HostingPython

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur dstack
Keine verifizierten Daten
Nur Modelbit
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

dstack monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
13.1K
Ø Besuchsdauer
0:02
Seiten pro Besuch
1.21
Absprungrate
53.77%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 4.8K
  • 2026-01: 16.2K
  • 2026-02: 19.7K
  • 2026-03: 11.8K
  • 2026-04: 9.4K
  • 2026-05: 13.1K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇫🇷France64.99%8.5K
🇺🇸United States15.02%2K
🇷🇺Russia7.76%1K
🇮🇳India7.35%962
🇩🇪Germany4.88%639

Traffic-Quellen

Source typePercentageEstimated visits
Direkt61.06%8K
E-Mail20.74%2.7K
Verweis18.2%2.4K

Suchbegriffe

dstackdstack serverdstack sky free creditssglang routertrl sft コマンドで複数ノードで実行する方法

Modelbit monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
438
Ø Besuchsdauer
0:25
Seiten pro Besuch
1.62
Absprungrate
34.27%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 8.1K
  • 2026-01: 2.5K
  • 2026-02: 1.6K
  • 2026-03: 2.4K
  • 2026-04: 3K
  • 2026-05: 438

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India100%438

Suchbegriffe

dbt incremental modelssam segment anything checkpoint bsam_vit_b_01ec64sam_vit_b_01ec64.pthsam_vit_b_01ec64.pth (1)

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

dstack

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
215
Likes
208

Modelbit

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
176
Likes
178

dstack vs Modelbit · Vergleichs-FAQ

What do dstack and Modelbit have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are dstack and Modelbit free?
Listed pricing models: dstack — Freemium; Modelbit — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between dstack and Modelbit?
The primary listed category is Orchestrierung for dstack, and MLOps for Modelbit. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche