ToolMage
Anmelden

AI TOOL COMPARISON

Elementary Data vs Lilac

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Elementary Data Produktübersicht

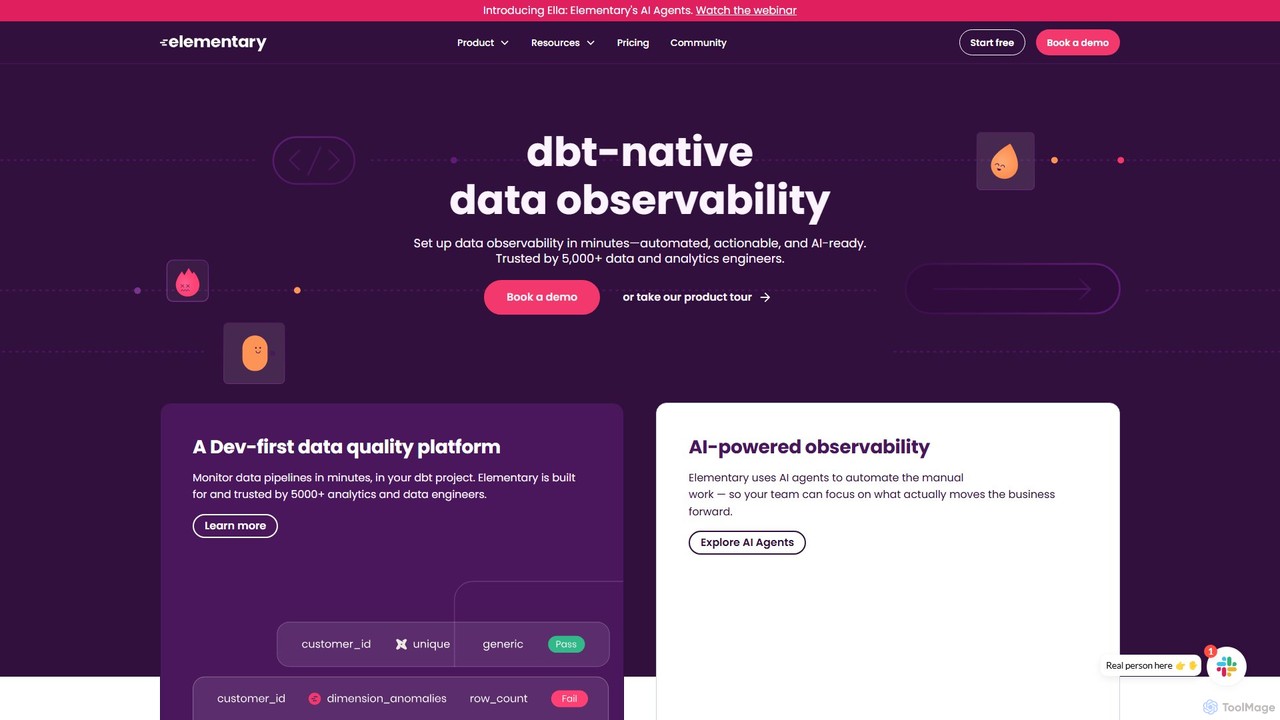
Elementary Data ist eine dbt-native Daten-Observability-Plattform, die für Daten- und Analyse-Ingenieure entwickelt wurde. Sie nutzt KI-Agenten, um die Überwachung der Datenqualität zu automatisieren, Anomalien zu erkennen und eine End-to-End-Datenherkunft bereitzustellen. Die Plattform hilft Teams, Alarmrauschen zu reduzieren, Vorfälle schneller zu lösen und Vertrauen in ihre Daten für KI- und Analyseanwendungen aufzubauen.

Preview

Lilac Produktübersicht

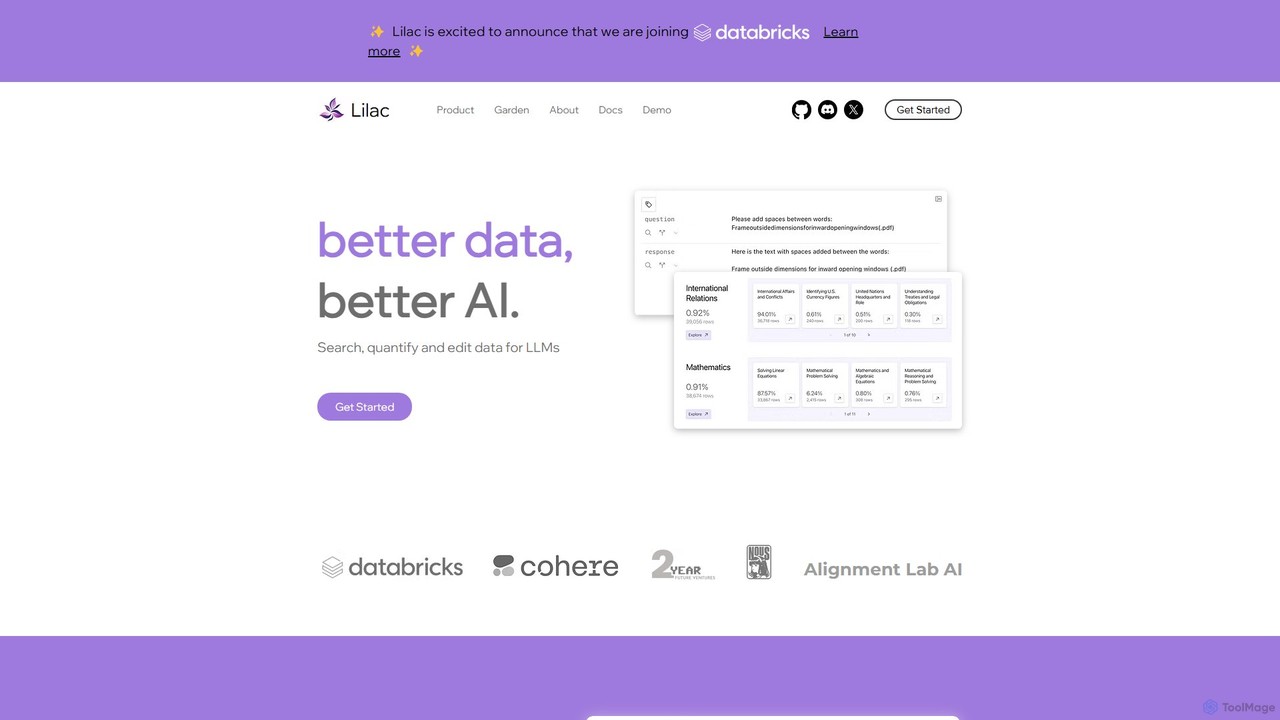
Lilac ist ein Open-Source-Tool für Datenwissenschaftler und ML-Ingenieure zum Erkunden, Bereinigen und Verbessern von Datensätzen für große Sprachmodelle (LLMs). Es bietet leistungsstarke semantische Suche, Daten-Clustering und Qualitätsanalyse, um bessere KI zu entwickeln.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Elementary Data VS Lilac — Kerndaten
KerndatenElementary DataLilac
Pricing modelFreemiumFree
Product typeWebWeb
Primary focusBeobachtbarkeitModelltraining
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienBeobachtbarkeit · Datenmanagement · AnalysenModelltraining · Datenanalyse · Datenmanagement
Added12.08.202506.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Elementary Data

Elementary Data ist eine entwicklerorientierte, dbt-native Daten-Observability-Plattform, der Tausende von Daten- und Analyse-Ingenieuren vertrauen. Sie wurde entwickelt, um die Datenqualität über den gesamten Datenlebenszyklus hinweg zu operationalisieren, von der Erkennung bis zur Lösung. Durch den Einsatz von KI-Agenten automatisiert Elementary manuelle Aufgaben, sodass sich Datenteams auf wirkungsvolle Aktivitäten konzentrieren können, die den Geschäftswert steigern. Die Plattform begegnet der kritischen Herausforderung der Datenqualität, die oft der Hauptblocker für eine erfolgreiche KI-Implementierung und die Akzeptanz von Datenprodukten ist, und stellt sicher, dass fehlerhafte Eingaben nicht zu defekten Modellen oder unzuverlässigen Entscheidungen führen.

Wie man Elementary Data verwendet

Der Einstieg in Elementary Data ist schnell und nahtlos gestaltet, insbesondere für Teams, die bereits dbt verwenden. Der Prozess umfasst in der Regel:

  1. Installation: Installieren Sie das Open-Source-dbt-Paket von Elementary als SDK in Ihrem bestehenden dbt-Projekt. Dies kann in wenigen Minuten erledigt werden.
  2. Konfiguration: Richten Sie Ihre Umgebungen ein und verbinden Sie Ihre Datenquellen. Elementary benötigt nur Lesezugriff auf Metadaten und Testergebnisse, nicht auf Ihre Rohdaten, was Sicherheit und Compliance gewährleistet (SOC-2 Typ II zertifiziert).
  3. Überwachung: Nach der Konfiguration beginnt Elementary automatisch mit der Überwachung Ihrer Datenpipelines. Es erfasst dbt-Testfehler, erkennt Anomalien in der Datenaktualität und im Datenvolumen und sammelt Leistungsmetriken.
  4. Alarmierung & Triage: Nutzen Sie die Elementary Cloud Platform zur Verwaltung von Alarmen. Sie können Routing-Regeln anpassen, um die richtigen Personen oder Teams über Slack oder andere Kanäle zu benachrichtigen. Die Plattform bietet Kontext, einschließlich Datenherkunft und Eigentümer, um die Triage und Lösung von Problemen zu beschleunigen.
  5. Erkundung & Governance: Nutzen Sie den nativen Datenkatalog, um Schemata zu erkunden, die Datenherkunft auf Spaltenebene anzuzeigen und die Datengesundheit zu verstehen. KI-Agenten können bei der Entdeckung der Testabdeckung und der automatisierten Triage helfen.

Kernfunktionen von Elementary Data

  • KI-Agenten (Ella): Automatisieren Sie manuelle Arbeiten wie die Triage von Vorfällen, die Entdeckung der Testabdeckung, die Leistungsoptimierung und die Daten-Governance, um die Effizienz zu steigern.
  • Datenqualitätstests: Verwalten Sie dbt-Tests, native Elementary-Tests und benutzerdefinierte SQL-Tests von einer einzigen, einheitlichen Plattform aus.
  • Automatisierte Anomalieerkennung: Überwachen Sie Daten proaktiv auf Anomalien in Bezug auf Aktualität, Volumen und Schema ohne manuelle Konfiguration.
  • End-to-End-Datenherkunft: Visualisieren Sie die Datenherkunft auf Spaltenebene, um Datenabhängigkeiten zu verstehen, Probleme bis zu ihrer Quelle zurückzuverfolgen und die Auswirkungen von Änderungen zu bewerten.
  • Vorfall- & Alarmierungsmanagement: Reduzieren Sie das Rauschen mit vereinfachter, kontextreicher Alarmierung. Leiten Sie Benachrichtigungen an die richtigen Stakeholder weiter und verwalten Sie Vorfälle von der Erkennung bis zur Lösung.
  • Datengesundheits-Scores: Erhalten Sie einen schnellen, übergeordneten Überblick über die Qualität und Zuverlässigkeit Ihrer Daten über verschiedene Qualitätsdimensionen hinweg.
  • Leistungs- & Kostenüberwachung: Identifizieren und beheben Sie Engpässe in Ihren Datenpipelines, verfolgen Sie Ausführungszeiten und überwachen Sie Leistungstrends, um die Kosten zu optimieren.
  • Nativer Datenkatalog: Eine angereicherte Alternative zu dbt docs, die einen zentralen Ort für die Datenentdeckung, das Metadatenmanagement und das Verständnis von Datenassets bietet.

Anwendungsfälle für Elementary Data

Elementary Data ist vielseitig und unterstützt verschiedene datengesteuerte Initiativen. Zum Beispiel nutzte ein Unternehmen wie Flock Safety Elementary, um ein praktisches Daten-Governance-Programm aufzubauen. Indem sie sich auf Datenqualität und -entdeckung konzentrierten, bauten sie Vertrauen bei Geschäftspartnern und Analyse-Ingenieuren auf. Dies führte zu einem erhöhten Datenverbrauch, besserer Zusammenarbeit und zuverlässigeren Entscheidungen. Weitere Anwendungsfälle sind:

  • Verhinderung von KI-Halluzinationen: Sicherstellung hochwertiger Dateneingaben für KI- und maschinelle Lernmodelle, um fehlerhafte Ausgaben zu verhindern und vertrauenswürdige Systeme aufzubauen.
  • Reduzierung der Alarmmüdigkeit: Datenteams bei Unternehmen wie Hippo nutzen Elementary, um Rauschen herauszufiltern und nur bei echten Produktionsausfällen Alarme zu erhalten, wodurch der „Albtraum“ ständiger, irrelevanter Benachrichtigungen beseitigt wird.
  • Verbesserung des Vertrauens der Stakeholder: Bereitstellung eines klaren, täglichen Überblicks über die Datengesundheit für Stakeholder, um ihnen Vertrauen in die Qualität der von ihnen für Entscheidungen verwendeten Daten zu geben.
  • Aufbau von Datenvertrauen: Nutzung der Test-, Tagging- und Metadatenfunktionen von Elementary, um einen „goldenen Standard“ des Vertrauens in Datenassets zu schaffen.

Vorteile von Elementary Data

Der Hauptvorteil von Elementary ist seine tiefe, native Integration in das dbt-Ökosystem, was es zu einer natürlichen Wahl für moderne Datenteams macht. Sein entwicklerorientierter Ansatz stellt sicher, dass es sich nahtlos in bestehende Arbeitsabläufe einfügt. Der Einsatz von KI-Agenten zur Automatisierung reduziert den manuellen Aufwand erheblich und verbessert die Teameffizienz. Darüber hinaus macht seine umfassende Abdeckung des gesamten Datenqualitätslebenszyklus – von Tests und Überwachung bis hin zur Vorfalllösung und Governance – es zu einer All-in-One-Lösung. Die Plattform ist von Natur aus sicher, greift niemals auf Rohdaten zu und bietet sowohl eine leistungsstarke Open-Source-Version als auch skalierbare Cloud-Pläne für Unternehmen.

Preise und Pläne

Elementary bietet ein flexibles Preismodell basierend auf Benutzerplätzen, mit einer kostenlosen Open-Source-Option und kostenpflichtigen Cloud-Plänen. Eine 30-tägige kostenlose Testversion des Essentials-Plans ist verfügbar.

  • Open Source (OSS): Eine selbst gehostete, kostenlose Community-Version, die Tausende von Teams in der Produktion verwenden.
  • Starter-Plan: 650 $/Monat. Beinhaltet bis zu 2 Benutzer, Erkennung und Triage von Datenproblemen, automatisierte Anomalieerkennung, Datenherkunft auf Spaltenebene und Leistungsüberwachung.
  • Essentials-Plan: 1600 $/Monat. Beinhaltet alles im Starter-Plan für bis zu 8 Benutzer, plus Kollaborationsfunktionen, alle KI-Agenten, Vorfallmanagement, End-to-End-Datenherkunft und dedizierten Slack-Support.
  • Enterprise-Plan: Individuelle Preise. Beinhaltet alles im Essentials-Plan mit flexiblen Plätzen, unternehmensweiter Sicherheit (RBAC, SCIM), erweiterten Bereitstellungsoptionen, Premium-Support-SLAs und Integrationen mit Tools wie Jira und PagerDuty.

Lilac

Lilac ist eine leistungsstarke Open-Source-Plattform, die die Art und Weise revolutionieren soll, wie Entwickler und Datenwissenschaftler mit Daten für die KI-Modellentwicklung interagieren. Basierend auf dem Prinzip "Bessere Daten, bessere KI" bietet Lilac eine umfassende Suite von Werkzeugen zum Suchen, Quantifizieren und Bearbeiten von Datensätzen, insbesondere solchen, die für das Training und die Feinabstimmung von Großen Sprachmodellen (LLMs) verwendet werden. Es begegnet dem kritischen Bedarf an qualitativ hochwertigen Daten, indem es den Prozess der Datenerkundung, -bereinigung und -kuration effizienter, intuitiver und skalierbarer macht.

Die Plattform wird von führenden Organisationen wie Alignment Lab AI und NousResearch geschätzt und befähigt Teams, über einfache Schlüsselwortsuchen hinauszugehen und ein tiefes, konzeptionelles Verständnis ihrer Daten zu erlangen. Mit seiner blitzschnellen Berechnungs-Engine kann Lilac riesige Datensätze mit bemerkenswerter Geschwindigkeit verarbeiten, wie z. B. das Clustern von einer Million Datenpunkten in nur 20 Minuten oder das Einbetten von Daten mit einer Rate von einer halben Milliarde Token pro Minute. Diese Leistung macht es zu einem entscheidenden Bestandteil jeder ernsthaften Pipeline zur Bewertung der Datenqualität.

Wie man Lilac verwendet

Der Einstieg in Lilac ist unkompliziert, insbesondere für diejenigen, die mit dem Python-Ökosystem vertraut sind. Die primäre Nutzungsmethode umfasst eine lokale Installation und eine webbasierte Benutzeroberfläche zur Erkundung.

  1. Installation: Beginnen Sie mit der Installation der Lilac-Bibliothek mit pip, dem Python-Paketinstallationsprogramm. Öffnen Sie Ihr Terminal oder Ihre Eingabeaufforderung und führen Sie den Befehl aus: pip install lilac.
  2. Lilac starten: Nach der Installation können Sie den Lilac-Server von Ihrem Terminal aus starten. Dies geschieht normalerweise durch Ausführen eines Befehls wie lilac start [path_to_your_project_dir]. Dieser Befehl verarbeitet Ihre Datensätze und startet einen lokalen Webserver.
  3. Daten laden: Weisen Sie Lilac auf Ihren Datensatz hin. Es kann verschiedene Datenformate und -quellen verarbeiten, sodass Sie Daten aus lokalen Dateien (CSV, JSON usw.) oder direkt von Hubs wie Hugging Face importieren können.
  4. Erkunden und Analysieren: Sobald der Server läuft, öffnen Sie die bereitgestellte URL in Ihrem Webbrowser, um auf die Lilac-Benutzeroberfläche zuzugreifen. Hier können Sie seine leistungsstarken Funktionen zur Erkundung Ihrer Daten nutzen. Führen Sie semantische Suchen durch, sehen Sie sich Datencluster an und analysieren Sie Signale wie PII oder Sprache.
  5. Kurieren und Bearbeiten: Verwenden Sie die Benutzeroberfläche, um Datenpunkte direkt zu markieren, zu filtern und sogar zu bearbeiten. Sie können neue Labels erstellen, Duplikate entfernen oder verrauschte Einträge bereinigen.
  6. Exportieren und Nutzen: Nach der Kuration Ihres Datensatzes können Sie die verbesserte Version oder die generierten Erkenntnisse (z. B. eine Liste der zu entfernenden IDs) für die Verwendung in Ihrer Modelltrainingspipeline exportieren.

Kernfunktionen von Lilac

  • Semantische & Schlüsselwortsuche: Gehen Sie über einfaches Text-Matching hinaus. Mit Lilac können Sie Ihren Datensatz mit natürlichsprachlichen Abfragen durchsuchen, um konzeptionell ähnliche Einträge zu finden, zusätzlich zur traditionellen Schlüsselwortsuche.
  • Automatisches Daten-Clustering: Lilac gruppiert ähnliche Datenpunkte automatisch und weist diesen Clustern Titel zu, sodass Sie sofort einen Überblick über die in Ihren Daten vorhandenen Themen und Muster erhalten.
  • Suche nach unscharfen Konzepten: Suchen Sie nach abstrakten oder nuancierten Konzepten, die mit bestimmten Schlüsselwörtern schwer zu definieren sind, was eine anspruchsvollere Datensegmentierung und -erkundung ermöglicht.
  • Integrierte Datenqualitätssignale: Die Plattform verfügt über vorgefertigte Signale zur automatischen Erkennung von personenbezogenen Daten (PII), Beinahe-Duplikaten, Textkomplexität und der Sprache des Textes.
  • Erstellung benutzerdefinierter Signale: Benutzer können die Funktionen von Lilac erweitern, indem sie ihre eigenen benutzerdefinierten Signale und Transformationen für ihre Datensätze definieren und ausführen und die Analyse an ihre spezifischen Bedürfnisse anpassen.
  • Datenbearbeitung und -vergleich: Bearbeiten Sie Datenfelder direkt in der Benutzeroberfläche und vergleichen Sie verschiedene Felder oder Versionen Ihres Datensatzes nebeneinander, um die Auswirkungen Ihrer Änderungen zu verstehen.
  • Hochleistungs-Engine: Lilac wurde für Geschwindigkeit und Skalierbarkeit entwickelt und kann Datensätze mit Milliarden von Token verarbeiten, was die Kuration von Daten im großen Maßstab ermöglicht.

Anwendungsfälle für Lilac

Lilac ist ein vielseitiges Werkzeug, das im gesamten KI-Entwicklungslebenszyklus anwendbar ist:

  • Kuration von Vortrainingsdaten: Analysieren und bereinigen Sie riesige web-skalierte Datensätze, um minderwertige Inhalte, Duplikate und PII zu entfernen, bevor Sie ein Grundlagenmodell vortrainieren.
  • Verbesserung von Feinabstimmungsdatensätzen: Für Aufgaben wie die Feinabstimmung von Anweisungen verwenden Sie Lilac, um die Qualität von Anweisungs-Antwort-Paaren zu analysieren, Verzerrungen zu identifizieren und die Vielfalt der Daten sicherzustellen.
  • Modellbewertung und -debugging: Entdecken und analysieren Sie spezifische Datensegmente, in denen Ihr Modell schlecht abschneidet. Durch das Clustern und Untersuchen von Fehlerfällen können Sie die Schwächen des Modells verstehen und sie mit besseren Daten gezielt angehen.
  • Datenerkundung und -verständnis: Verschaffen Sie sich schnell ein qualitatives Gefühl für jeden neuen Textdatensatz. Verstehen Sie seine Zusammensetzung, identifizieren Sie Hauptthemen und erkennen Sie potenzielle Probleme, bevor Code geschrieben wird.
  • Inhaltsmoderation und Sicherheit: Verwenden Sie semantische Suche und benutzerdefinierte Signale, um toxische, schädliche oder anderweitig sensible Inhalte in einem Datensatz effizient zu identifizieren und zu kennzeichnen.

Vorteile von Lilac

Lilac bietet erhebliche Vorteile für Teams, die mit LLMs arbeiten:

  • Verbesserte Modellleistung: Durch die systematische Verbesserung der Datenqualität hilft Ihnen Lilac, genauere, zuverlässigere und weniger voreingenommene KI-Modelle zu erstellen.
  • Beschleunigter Entwicklungsworkflow: Es reduziert den Zeit- und manuellen Aufwand für die Datenerkundung und -bereinigung drastisch, sodass Teams schneller iterieren können.
  • Demokratisierung von Dateneinblicken: Die intuitive Benutzeroberfläche macht eine tiefgehende Datensatzanalyse für alle Teammitglieder zugänglich, einschließlich Produktmanagern und Fachexperten, nicht nur für ML-Ingenieure.
  • Open Source und erweiterbar: Da es kostenlos und quelloffen ist, fördert es Transparenz, Community-Zusammenarbeit und ermöglicht eine vollständige Anpassung an einzigartige Projektanforderungen.
  • Skalierbarkeit für reale Daten: Seine effiziente Architektur stellt sicher, dass Sie dieselben strengen Datenqualitätsprozesse sowohl auf kleine als auch auf riesige Datensätze im Produktionsmaßstab anwenden können.

Preise und Pläne

Lilac ist ein Open-Source-Projekt, dessen Kernbibliothek und Benutzeroberfläche völlig kostenlos sind. Sie können es ohne Kosten auf Ihrem lokalen Rechner oder Ihrer privaten Infrastruktur installieren und ausführen. Das Projekt wird von seiner Community und seinen Mitwirkenden getragen. Während das Kernwerkzeug kostenlos ist, könnte es zukünftige Angebote auf Unternehmensebene geben, wie den erwähnten "Lilac Garden", der verwaltete Cloud-Dienste, dedizierten Support oder erweiterte Funktionen für die kommerzielle Nutzung bereitstellen könnte. Für einzelne Entwickler, Forscher und die meisten Teams bietet die Open-Source-Version jedoch die volle Funktionalität.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Datenmanagement
Nur Elementary Data
BeobachtbarkeitAnalysen
Nur Lilac
ModelltrainingDatenanalyse

Tags

Gemeinsam
Datenqualität
Nur Elementary Data
KI-AgentAnalytics EngineeringAnomalieerkennungDatenkatalogDatenherkunftDatenüberwachungDatenobservabilitätdbt
Nur Lilac
DatenanalyseDatenbereinigungDatenexplorationDatensatzEntwicklerwerkzeugeGroßes Sprachmodellmaschinelles LernenOpen SourceSemantische Suche

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur Elementary Data
Keine verifizierten Daten
Nur Lilac
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Elementary Data monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
16K
Ø Besuchsdauer
0:21
Seiten pro Besuch
1.54
Absprungrate
47.25%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: Nicht verifiziert
  • 2025-09: 18.7K
  • 2026-01: 17K
  • 2026-02: 16.9K
  • 2026-03: 18.3K
  • 2026-04: 12.1K
  • 2026-05: 16K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States48.18%7.7K
🇩🇪Germany25.01%4K
🇧🇷Brazil11.23%1.8K
🇮🇳India8.01%1.3K
🇫🇷France7.57%1.2K

Suchbegriffe

dbt test accepted valuesdbt tests relationshipelementary dataelementary performance alertsnowflake summit

Lilac monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
16.7K
Ø Besuchsdauer
1:00
Seiten pro Besuch
1.12
Absprungrate
80.5%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-08: 682
  • 2025-09: 504
  • 2026-01: Nicht verifiziert
  • 2026-02: 693
  • 2026-03: 0
  • 2026-04: 709
  • 2026-05: 16.7K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States100%16.7K

Suchbegriffe

lilac data managementsportwetten ohne lugas

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Elementary Data

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
153
Likes
162

Lilac

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
170
Likes
174

Elementary Data vs Lilac · Vergleichs-FAQ

What do Elementary Data and Lilac have in common?
Both tools are listed under Datenmanagement. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Elementary Data and Lilac free?
Listed pricing models: Elementary Data — Freemium; Lilac — Free. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Elementary Data and Lilac?
The primary listed category is Beobachtbarkeit for Elementary Data, and Modelltraining for Lilac. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche