ToolMage
Anmelden

AI TOOL COMPARISON

Grably vs Kaggle

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

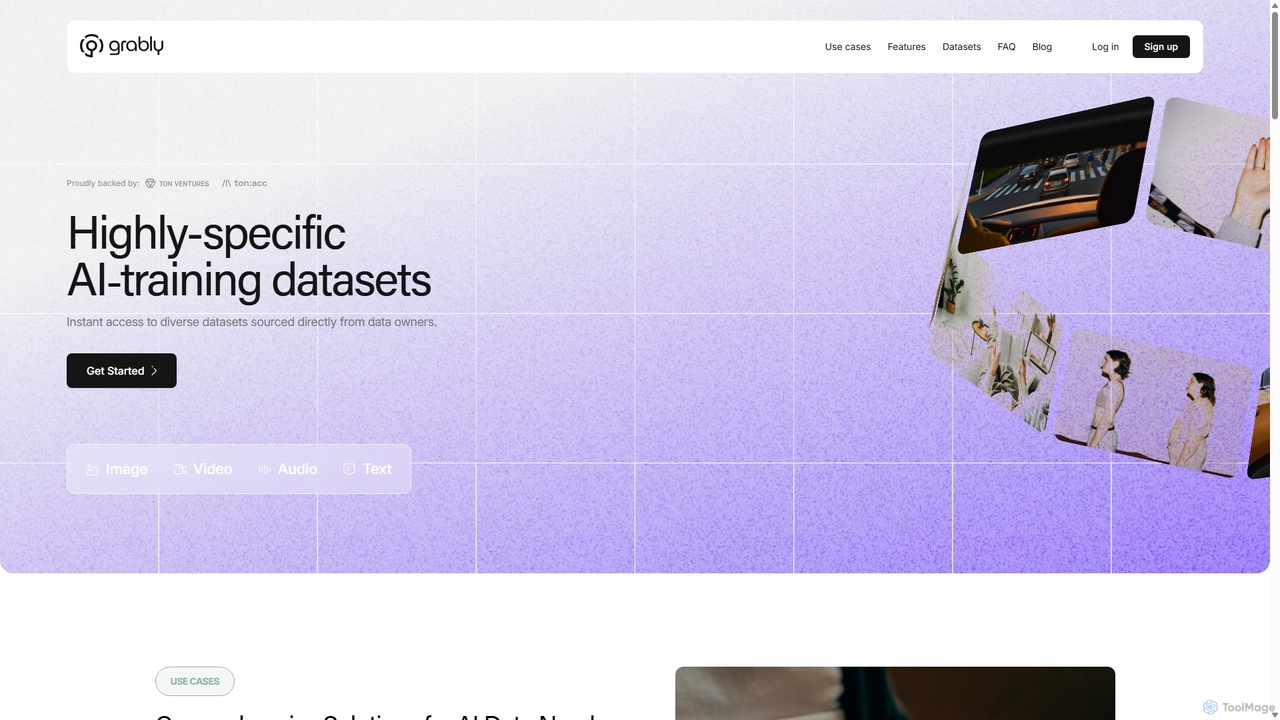
Grably Produktübersicht

Grably ist ein dezentrales Datenbesitz-Netzwerk (DeDON), das hochwertige, ethisch einwandfreie KI-Trainingsdaten bereitstellt. Es bietet eine riesige Sammlung von Standard-Datensätzen, benutzerdefinierte Datenerfassung, Kuratierung und Annotationsdienste, um die KI-Entwicklung zu beschleunigen und es den Nutzern zu ermöglichen, ihre Daten sicher und transparent zu monetarisieren.

Preview

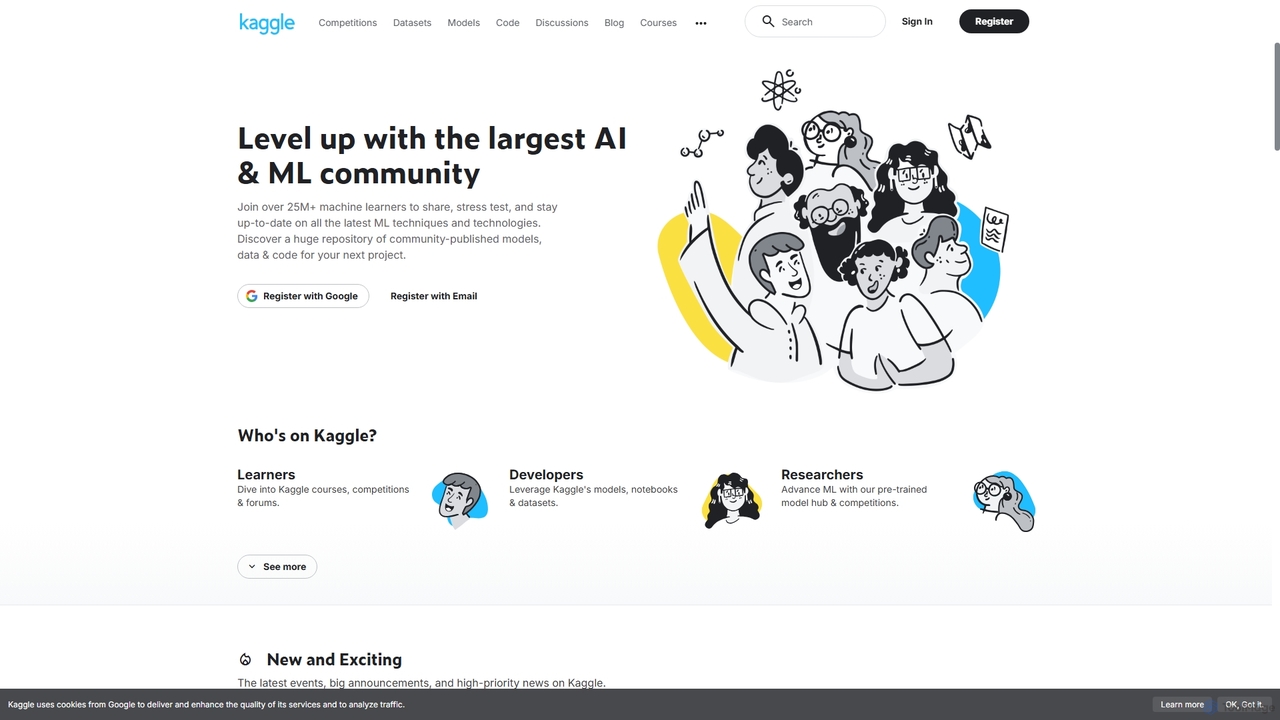
Kaggle Produktübersicht

Kaggle ist die weltweit größte Online-Community für Datenwissenschaftler und Machine-Learning-Praktiker. Als Teil von Google bietet es eine Plattform zum Erkunden von Datensätzen, Erstellen von Modellen in einer webbasierten Umgebung, zur Teilnahme an Machine-Learning-Wettbewerben und zum Zugriff auf Bildungsressourcen. Es bietet kostenlosen Zugang zu leistungsstarken Rechenressourcen, einschließlich GPUs und TPUs, und ist damit ein unverzichtbares Werkzeug für Anfänger bis hin zu erfahrenen Experten in den Bereichen KI und Datenwissenschaft.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Grably VS Kaggle — Kerndaten
KerndatenGrablyKaggle
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusDatenbeschriftungDatensätze
Zielgruppen und RollenKI-Forscher · Chief Technology Officer · Datenanalyst · Datenwissenschaftler · Machine Learning Ingenieur · Produktmanager · SoftwareentwicklerKI-Entwickler · Datenanalyst · Datenwissenschaftler · Machine Learning Ingenieur · Quantitativer Analyst · Forscher · Softwareentwickler · Student
KategorienDatenbeschriftung · Datensätze · Maschinelles LernenDatensätze · Maschinelles Lernen · Datenwissenschaft
Added19.09.202518.09.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Grably

Grably ist eine wegweisende Plattform, die auf dem Konzept eines dezentralen Datenbesitz-Netzwerks (DeDON) basiert. Sie dient als entscheidende Brücke zwischen der wachsenden Nachfrage nach hochwertigen KI-Trainingsdaten und den Einzelpersonen und Unternehmen, die diese Daten besitzen. Durch die Schaffung eines transparenten und ethischen Ökosystems ermöglicht Grably KI-Teams, genauere und robustere Modelle zu erstellen, während Datenbesitzer ihre Vermögenswerte sicher und mit voller Zustimmung monetarisieren können.

Die Plattform begegnet einer zentralen Herausforderung in der KI-Branche: dem Mangel an vielfältigen, realen und ethisch einwandfreien Daten. Grably erschließt Zettabytes an bisher unzugänglichen Daten, indem es sie direkt von Nutzern bezieht, die ihre ausdrückliche Zustimmung zur Verwendung im KI-Training gegeben haben. Dieser Ansatz gewährleistet nicht nur die Einhaltung globaler Datenschutzbestimmungen wie DSGVO und CCPA, sondern verbessert auch die Qualität und Vielfalt der Datensätze, was zu weniger voreingenommenen und effektiveren KI-Modellen führt.

Wie man Grably verwendet

Grably bietet einen optimierten Prozess für KI-Teams (Kunden) und Datenanbieter (Partner):

Für KI-Teams & Entwickler:

  1. Datensätze erkunden: Durchsuchen Sie Grablys umfangreiche Bibliothek an gebrauchsfertigen Standard-Datensätzen aus verschiedenen Branchen, einschließlich Gesundheitswesen, Automobilindustrie und Einzelhandel.
  2. Benutzerdefinierte Daten anfordern: Wenn Ihr Projekt einzigartige Anforderungen hat, können Sie Grablys Plattform nutzen, um eine benutzerdefinierte Datenerfassung anzufordern. Geben Sie Ihre Bedürfnisse an, und Grably sammelt hochwertige, von Nutzern genehmigte Daten, die auf Ihr Modell zugeschnitten sind.
  3. Verbessern & Kennzeichnen: Nutzen Sie Grablys Datenkurations- und Annotationsdienste, um Ihre Datensätze zu bereinigen, zu organisieren und präzise zu kennzeichnen, um sicherzustellen, dass sie für das Modelltraining und die Genauigkeit optimiert sind.
  4. Integrieren & Trainieren: Greifen Sie auf die vollständig konformen, hochwertigen Daten zu und integrieren Sie sie in Ihre KI-Entwicklungspipeline, um Ihre Modelle effizienter zu trainieren, zu testen und zu validieren.

Für Datenanbieter & Partner:

  1. Dem Netzwerk beitreten: Werden Sie ein Geschäftsdatenpartner, um Ihre Datensätze wie medizinische Unterlagen, Medienkits oder Kundendatenbanken aufzulisten und zu monetarisieren.
  2. Zustimmung erteilen: Einzelne Nutzer können dem Netzwerk beitreten (oft über zugehörige Apps) und eine explizite, granulare Zustimmung zur Weitergabe bestimmter Datentypen geben.
  3. Datenschutz gewährleisten: Daten werden oft auf dem Gerät verarbeitet, um die Privatsphäre zu schützen, bevor sie dem Netzwerk hinzugefügt werden.
  4. Belohnungen verdienen: Monetarisieren Sie Ihre Daten auf ethische und transparente Weise und erhalten Sie eine Vergütung für Ihren Beitrag zum Fortschritt der KI.

Kernfunktionen von Grably

  • Standard-Datensätze: Zugriff auf eine riesige und wachsende Sammlung von vor-kuratierten Datensätzen, einschließlich multi-ethnischer Gesichtserkennung, medizinischer Bildgebung (Röntgen, MRTs), Dashcam-Verkehrsszenen und mehr.
  • Benutzerdefinierte Datenerfassung: Ein maßgeschneiderter Service zur Erfassung spezifischer, hochwertiger Daten direkt von zustimmenden Nutzern gemäß den einzigartigen Anforderungen Ihres Projekts.
  • Datenkuration: Professionelle Dienstleistungen zur Verbesserung von Datensätzen, um Relevanz, Genauigkeit und Konformität für eine optimale KI-Leistung zu gewährleisten.
  • Experten-Datenannotation: Präzise Datenkennzeichnungs- und Annotationsdienste zur Verbesserung des Trainingsprozesses und der Genauigkeit von maschinellen Lernmodellen.
  • Dezentrales Datenbesitz-Netzwerk (DeDON): Eine grundlegende Technologie, die sicherstellt, dass Daten ethisch einwandfrei, transparent und mit Zustimmung der Nutzer beschafft werden.
  • Konformität und Sicherheit: Einhaltung globaler Datenschutzstandards wie DSGVO und CCPA, mit Fokus auf sichere On-Device-Verarbeitung und ethischen Umgang mit Daten.
  • Datenmonetarisierung: Eine Plattform für Unternehmen und Einzelpersonen, um ihre Datenvermögen auf transparente und ethische Weise zu monetarisieren.

Anwendungsfälle für Grably

Die Datensätze und Dienste von Grably sind in zahlreichen Bereichen anwendbar:

  • Gesundheitswesen: Training von diagnostischen KI-Modellen mit medizinischen Bildern wie Röntgenaufnahmen und Gehirn-MRTs oder Analyse anonymisierter medizinischer Unterlagen.
  • Automobilindustrie: Entwicklung autonomer Fahrsysteme unter Verwendung von Dashcam-Verkehrsszenen und Objektsegmentierungs-Datensätzen.
  • Sicherheit & Biometrie: Aufbau fortschrittlicher Erkennungssysteme mit Datensätzen von multi-ethnischen Gesichtern, Handabdrücken und Handflächenbildern.
  • Einzelhandel: Verbesserung des Kundenerlebnisses und der Bestandsverwaltung mit Datensätzen von Innenraumobjekten und menschlichen Aktivitäten.
  • Versicherung: Automatisierung der Schadensbearbeitung durch das Training von Modellen auf Datensätzen von beschädigten Autos.

Vorteile von Grably

Grably bietet einen deutlichen Wettbewerbsvorteil auf dem KI-Datenmarkt:

  • Beispiellose Datenqualität: Durch die direkte Beschaffung von Nutzern liefert Grably vielfältige, reale Daten, die qualitativ deutlich hochwertiger sind als synthetische oder gescrapte Daten.
  • Ethisch und konform: Die volle Zustimmung der Nutzer und die Einhaltung von Datenschutzbestimmungen mindern rechtliche und ethische Risiken für KI-Entwickler.
  • Skalierbarkeit: Die Plattform ist so konzipiert, dass sie von kleinen Batch-Anfragen bis hin zu massiven Datenanforderungen im Zettabyte-Bereich skaliert werden kann, ohne die Qualität zu beeinträchtigen.
  • Zugang zu einzigartigen Daten: Das DeDON-Modell ermöglicht den Zugang zu einzigartigen und bisher nicht verfügbaren Datensätzen und verschafft KI-Teams einen Wettbewerbsvorteil.
  • Transparenz: Der gesamte Prozess, von der Datenbeschaffung bis zur Lieferung an den Kunden, basiert auf einem Fundament der Transparenz für alle Beteiligten.

Preise und Pläne

Grably arbeitet mit einem benutzerdefinierten Preismodell, das auf die spezifischen Bedürfnisse jedes Kunden zugeschnitten ist. Die Preisgestaltung wird durch Faktoren wie die Art der Dienstleistung (Kauf von Standard-Datensätzen, benutzerdefinierte Erfassung, Annotation), das erforderliche Datenvolumen und die Komplexität des Projekts bestimmt. Um ein detailliertes Angebot zu erhalten, werden potenzielle Kunden ermutigt, sich direkt über ihre Website an das Grably-Team zu wenden, um ihre Anforderungen zu besprechen.

Kaggle

Kaggle, eine Tochtergesellschaft von Google, ist die führende Online-Plattform und Community für Enthusiasten der Datenwissenschaft und des maschinellen Lernens. Mit einer globalen Gemeinschaft von über 25 Millionen Nutzern dient es als umfassendes Ökosystem, in dem Einzelpersonen und Teams Datensätze entdecken und veröffentlichen, Modelle mit einer leistungsstarken, kostenlosen Notebook-Umgebung erforschen und erstellen, an anspruchsvollen Wettbewerben für maschinelles Lernen teilnehmen und aus einer riesigen Sammlung von Bildungsressourcen lernen können. Kaggles Mission ist es, Datenwissenschaftlern und Machine-Learning-Ingenieuren in allen Phasen ihrer Karriere zu helfen, zu lernen, zu wachsen und etwas zu bewirken.

Wie man Kaggle verwendet

Der Einstieg bei Kaggle ist ein unkomplizierter Prozess, der darauf ausgelegt ist, Benutzer schnell in die Welt der Datenwissenschaft einzuführen:

  1. Ein Konto erstellen: Registrieren Sie sich für ein kostenloses Konto auf der Kaggle-Website mit einem Google-Konto oder einer E-Mail-Adresse.
  2. Die Grundlagen lernen: Für Neulinge bietet Kaggle eine Reihe von kostenlosen, praktischen Kursen namens Kaggle Learn an. Diese decken wesentliche Themen wie Python, Pandas, Datenvisualisierung und eine Einführung in das maschinelle Lernen ab.
  3. Datensätze erkunden: Navigieren Sie zum Bereich Datasets, um über 500.000 öffentliche Datensätze zu durchsuchen. Sie finden Daten zu praktisch jedem Thema, von Avocadopreisen bis hin zu medizinischer Bildgebung, zur Verwendung in Ihren persönlichen Projekten.
  4. Notebooks nutzen: Starten Sie ein kostenloses Kaggle Notebook, eine cloudbasierte Jupyter-Umgebung. Es ist mit den wichtigsten Datenwissenschaftsbibliotheken vorinstalliert. Sie können Code schreiben und ausführen und, was am wichtigsten ist, kostenlose GPU- oder TPU-Beschleuniger für rechenintensive Aufgaben aktivieren.
  5. An einem Wettbewerb teilnehmen: Das Herzstück von Kaggle sind seine Wettbewerbe. Anfänger können mit „Getting Started“-Wettbewerben wie dem berühmten „Titanic: Machine Learning from Disaster“ beginnen. In einem Wettbewerb laden Sie die Daten herunter, erstellen ein Vorhersagemodell in einem Notebook, generieren eine Einreichungsdatei mit Ihren Vorhersagen und laden sie hoch, um Ihr Echtzeit-Ranking auf der Bestenliste zu sehen.
  6. Zusammenarbeiten und teilen: Engagieren Sie sich in der Community über Diskussionsforen, kommentieren Sie öffentliche Notebooks oder „forken“ (kopieren) Sie ein Notebook, um auf der Arbeit eines anderen aufzubauen. Sie können auch Teams bilden, um Wettbewerbe gemeinsam anzugehen.
  7. Vortrainierte Modelle nutzen: Erkunden Sie den Models-Hub, um Tausende von vortrainierten Modellen wie Googles Gemma oder Metas Llama 2 zu finden, die Sie als Ausgangspunkt für Ihre eigenen Projekte verwenden können.

Kernfunktionen von Kaggle

  • Wettbewerbe für maschinelles Lernen: Kaggle ist bekannt für die Ausrichtung von ML-Wettbewerben, die von Unternehmen und Forschungsorganisationen gesponsert werden, mit Preisgeldern von bis zu 1 Million US-Dollar. Diese Herausforderungen decken eine breite Palette von Problemen ab, einschließlich Klassifizierung, Regression und Computer Vision.
  • Riesiges öffentliches Datensatz-Repository: Eine Sammlung von über 525.000 Datensätzen, was es zu einer der größten Ressourcen für die Suche nach hochwertigen, vielfältigen Daten für jedes Projekt macht.
  • Kaggle Notebooks: Eine kostenlose, cloudbasierte Programmierumgebung, die Python und R unterstützt. Sie bietet kostenlosen Zugang zu leistungsstarker Hardware, einschließlich NVIDIA GPUs und Googles TPUs, was das Modelltraining erheblich beschleunigt.
  • Hub für vortrainierte Modelle: Eine wachsende Bibliothek von über 28.000 einsatzbereiten ML-Modellen, die einfach in Kaggle Notebooks integriert werden können, um Zeit und Rechenressourcen zu sparen.
  • Kaggle Learn-Kurse: Eine Reihe von kostenlosen, interaktiven Mikro-Kursen, die darauf ausgelegt sind, praktische Datenwissenschaftsfähigkeiten schnell und effizient zu vermitteln, von der Datenmanipulation bis zum Deep Learning.
  • Globale Community und Diskussionsforen: Eine aktive Gemeinschaft von Millionen von Nutzern, die Code teilen, Ratschläge geben und die neuesten Trends in KI und maschinellem Lernen diskutieren.
  • Fortschrittssystem: Ein gamifiziertes System, das Benutzer für ihre Leistungen in Wettbewerben, Datensätzen, Notebooks und Diskussionen mit Medaillen und Rängen (Anfänger, Beitragender, Experte, Meister, Großmeister) belohnt und einen klaren Weg zur Anerkennung von Fähigkeiten bietet.

Anwendungsfälle für Kaggle

Kaggle ist eine vielseitige Plattform, die sich an ein breites Publikum richtet:

  • Studenten und angehende Datenwissenschaftler: Eine perfekte Umgebung, um praktische Fähigkeiten zu erlernen, theoretisches Wissen auf reale Probleme anzuwenden, ein professionelles Portfolio aufzubauen und in der Datenwissenschafts-Community sichtbar zu werden.
  • Professionelle Datenwissenschaftler und ML-Ingenieure: Ein Ort, um Fähigkeiten mit den Besten der Welt zu vergleichen, neue Techniken an einzigartigen Datensätzen zu erproben, erhebliche Geldpreise zu gewinnen und an der Spitze der Branche zu bleiben.
  • Akademische Forscher: Eine Plattform zur Ausrichtung forschungsorientierter Wettbewerbe, zur Crowdsourcing-Lösung komplexer wissenschaftlicher Probleme und zum Zugriff auf eine breite Palette öffentlicher Daten für Studien.
  • Unternehmen und Organisationen: Eine Möglichkeit, durch die Ausrichtung von „Featured Competitions“ innovative und hochpräzise Vorhersagemodelle für anspruchsvolle Geschäftsprobleme zu crowdsourcen und so effektiv auf einen globalen Pool von Top-Datenwissenschaftstalenten zuzugreifen.

Vorteile von Kaggle

Die Hauptvorteile der Nutzung von Kaggle sind:

  • Demokratisierter Zugang zu Rechenleistung: Die Bereitstellung von kostenlosen GPUs und TPUs schafft gleiche Wettbewerbsbedingungen und ermöglicht es jedem, an großen Projekten des maschinellen Lernens zu arbeiten, ohne teure Hardware zu benötigen.
  • Unvergleichliche Lernmöglichkeiten: Die Kombination aus realen Wettbewerben, umfangreichen Datensätzen, geteiltem Code und aktiven Foren schafft eine beispiellose Lernumgebung.
  • Karriereförderung: Ein starkes Kaggle-Profil, insbesondere mit hohen Platzierungen in Wettbewerben, ist eine hoch angesehene Referenz, die die Karriereaussichten im Bereich der Datenwissenschaft erheblich verbessern kann.
  • Lösung realer Probleme: Die Wettbewerbe basieren auf tatsächlichen Geschäfts- und Forschungsherausforderungen und bieten unschätzbare praktische Erfahrungen, die direkt in einem professionellen Umfeld anwendbar sind.

Preise und Pläne

Das Preismodell von Kaggle ist so konzipiert, dass es für Einzelpersonen zugänglich ist und gleichzeitig Premium-Dienste für Organisationen anbietet.

  • Für Einzelpersonen (Lernende, Praktiker): Die Plattform ist vollständig kostenlos. Dies umfasst die Teilnahme an Wettbewerben, den Zugriff auf alle Datensätze, die Nutzung von Kaggle Notebooks mit kostenlosen GPU/TPU-Kontingenten und alle Kaggle Learn-Kurse.
  • Für Wettbewerbsveranstalter:
    • Community-Wettbewerbe: Kostenlos für Bildungszwecke, kleine Unternehmen oder ML-Enthusiasten einzurichten.
    • Featured Competitions: Ein kostenpflichtiger Service für Unternehmen, die komplexe Probleme mit Geldpreisen und engagierter Unterstützung durch das Kaggle-Team lösen möchten. Die Preise sind variabel und auf die Bedürfnisse des Projekts zugeschnitten.
    • Forschungswettbewerbe: Konzipiert für akademische und gemeinnützige Einrichtungen, mit potenziell verfügbaren Zuschüssen zur Kostendeckung.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
DatensätzeMaschinelles Lernen
Nur Grably
Datenbeschriftung
Nur Kaggle
Datenwissenschaft

Tags

Gemeinsam
Datensätzemaschinelles Lernen
Nur Grably
KI-TrainingsdatenCCPAComputer VisionDatenannotationDatenerfassungDatenlabelingDatenmonetarisierungDezentrale DatenDeDONEthische KIGDPR
Nur Kaggle
KI-CommunityWettbewerbeDatenanalyseDatenwissenschaftDeep LearningGPUNotebooksPrädiktive ModellierungPythonRtpu

Zielgruppen und Rollen

Gemeinsam
DatenanalystDatenwissenschaftlerMachine Learning IngenieurSoftwareentwickler
Nur Grably
KI-ForscherChief Technology OfficerProduktmanager
Nur Kaggle
KI-EntwicklerQuantitativer AnalystForscherStudent

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Grably

Nicht verifiziert

Kaggle monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
12.4M
Ø Besuchsdauer
5:57
Seiten pro Besuch
6.31
Absprungrate
35.58%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 10.4M
  • 2026-01: 10.5M
  • 2026-02: 10.4M
  • 2026-03: 12.8M
  • 2026-04: 13.2M
  • 2026-05: 12.4M

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇮🇳India47.79%5.9M
🇺🇸United States30.24%3.7M
🇨🇳China9.29%1.2M
🇮🇩Indonesia8.22%1M
🇬🇧United Kingdom4.46%552.7K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt83.01%10.3M
Verweis13.97%1.7M
E-Mail3.02%374.3K

Suchbegriffe

anigumimdbkagglekaggle datasetskeggle

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Grably

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
175
Likes
173

Kaggle

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
170
Likes
176

Grably vs Kaggle · Vergleichs-FAQ

What do Grably and Kaggle have in common?
Both tools are listed under Datensätze、Maschinelles Lernen. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Grably and Kaggle free?
Listed pricing models: Grably — Paid; Kaggle — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Grably and Kaggle?
The primary listed category is Datenbeschriftung for Grably, and Datensätze for Kaggle. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche