hystruct
Scraping
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Scraping
Scraping
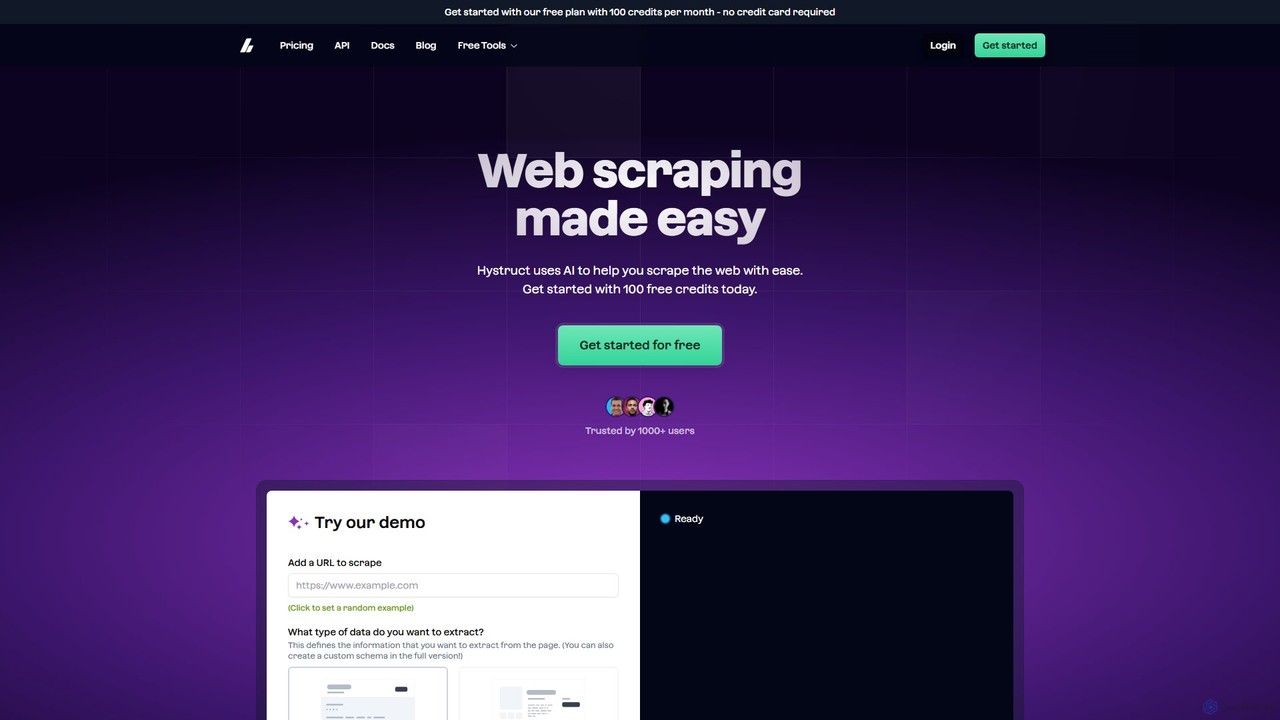
hystruct ist ein KI-gestütztes Web-Scraping-Tool, das die Datenextraktion vereinfacht. Es ermöglicht Benutzern, unstrukturierte Webinhalte einfach in strukturierte Daten umzuwandeln, indem vordefinierte oder benutzerdefinierte Schemata verwendet werden, ohne dass Code erforderlich ist. Mit Integrationen wie Zapier automatisiert es Arbeitsabläufe für Marktforschung, Lead-Generierung und mehr. Es ist für jeden konzipiert, vom Anfänger bis zum Enterprise-Team.
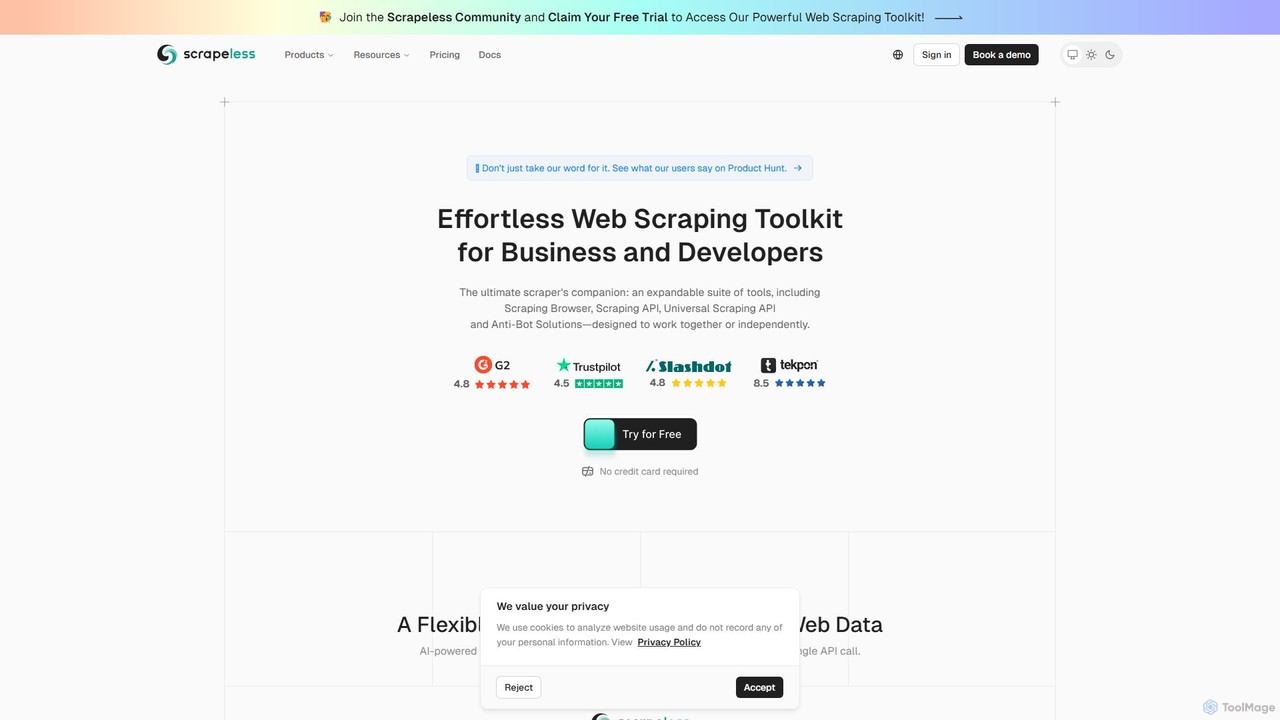
Ein KI-gestütztes Web-Scraping-Toolkit für Entwickler und Unternehmen. Es bietet eine Suite von Tools, einschließlich eines Scraping-Browsers, einer universellen Scraping-API und einer Deep-SERP-API, um mühelos öffentliche Webdaten in großem Maßstab zu extrahieren. Es ist spezialisiert auf die Umgehung von Anti-Bot-Maßnahmen und liefert strukturierte Daten für E-Commerce, Marktforschung und das Training von KI-Modellen, mit einem Fokus auf Zuverlässigkeit und Benutzerfreundlichkeit.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Kerndaten | hystruct | Scrapeless |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Scraping | Scraping |
| Zielgruppen und Rollen | Nicht verifiziert | Nicht verifiziert |
| Kategorien | Scraping · API · Lead-Generierung · Automatisierung | Scraping · API · SEO · Automatisierung |
| Added | 04.08.2025 | 04.08.2025 |
| Aktualisiert | 19.11.2026 | 19.11.2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
hystruct ist eine fortschrittliche, KI-gesteuerte Web-Scraping-Plattform, die entwickelt wurde, um die Datenextraktion von jeder Website mühelos und effizient zu gestalten. Sie befähigt Benutzer, unabhängig von ihrer technischen Expertise, unstrukturierte Webseiten in saubere, strukturierte Daten umzuwandeln. Durch den Einsatz künstlicher Intelligenz eliminiert hystruct die Notwendigkeit manueller Dateneingabe oder komplexer Programmierung und automatisiert den gesamten Prozess von der URL-Eingabe bis zur Datenausgabe. Die Plattform ist für eine breite Palette von Benutzern konzipiert, von Einzelpersonen und kleinen Teams bis hin zu großen Unternehmen, und bietet eine skalierbare Lösung für vielfältige Datenanforderungen.
Die Verwendung von hystruct ist ein einfacher, dreistufiger Prozess, der auf maximale Effizienz ausgelegt ist:
hystruct ist vielseitig und kann in zahlreichen Szenarien angewendet werden:
hystruct bietet einen erheblichen Wettbewerbsvorteil, indem es eine traditionell komplexe Aufgabe vereinfacht. Seine Hauptvorteile sind Geschwindigkeit, durch die Automatisierung von Aufgaben, die Stunden manueller Arbeit oder Programmierung erfordern würden; Zugänglichkeit, durch die Bereitstellung einer No-Code-Lösung für alle Fähigkeitsstufen; und Flexibilität, durch die Unterstützung sowohl einfacher als auch komplexer Datenextraktionsanforderungen mit benutzerdefinierten Schemata und API-Zugang. Die Integrationsfähigkeiten steigern die Produktivität weiter, indem sie sich direkt in bestehende Geschäftsworkflows einfügen.
hystruct bietet ein gestaffeltes Preismodell, um unterschiedlichen Bedürfnissen gerecht zu werden:
Scrapeless ist eine fortschrittliche, KI-gesteuerte Web-Scraping-Plattform, die entwickelt wurde, um die Datenextraktion für Unternehmen und Entwickler zu vereinfachen und zu skalieren. Es ist nicht nur ein einzelnes Werkzeug, sondern ein flexibles Toolkit, das einen Scraping-Browser, eine universelle Scraping-API und eine spezialisierte Deep-SERP-API umfasst. Diese Suite ist darauf ausgelegt, alles von der einfachen Datenerfassung bis hin zu komplexen Anti-Bot-Herausforderungen zu bewältigen und einen nahtlosen Zugriff auf öffentliche Webdaten zu gewährleisten. Durch den Einsatz von KI automatisiert Scrapeless den Prozess der Umgehung von Blockaden, des Parsens von Inhalten und der Bereitstellung strukturierter, verwertbarer Daten und wird so zu einem unverzichtbaren Begleiter für jeden, der zuverlässige Webinformationen benötigt.
Die Verwendung von Scrapeless ist als unkomplizierter Prozess konzipiert, der leistungsstarke Scraping-Funktionen über eine einfache API-Schnittstelle integriert. Hier ist ein typischer Arbeitsablauf:
1. Anmelden & API-Schlüssel erhalten: Registrieren Sie sich für ein kostenloses Konto auf der Scrapeless-Website. Für die Testversion ist keine Kreditkarte erforderlich, und Sie erhalten sofortigen Zugriff auf Ihren persönlichen API-Schlüssel im Dashboard.
2. Das richtige Werkzeug wählen: Wählen Sie je nach Bedarf den passenden Dienst aus. Verwenden Sie die universelle Scraping-API für das allgemeine Scraping jeder öffentlichen Website. Entscheiden Sie sich für die Deep-SERP-API für die gezielte Echtzeit-Extraktion strukturierter Suchmaschinenergebnisse. Für Websites mit viel JavaScript und komplexen Anti-Bot-Maßnahmen ist der Scraping-Browser die ideale Wahl.
3. In Ihren Code integrieren: Verwenden Sie die im Dashboard verfügbaren Codebeispiele, um Scrapeless in Ihre Anwendung zu integrieren. Es ist vollständig kompatibel mit allen wichtigen Programmiersprachen wie Python, Node.js, Java, Go und mehr.
4. Einen API-Aufruf tätigen: Erstellen Sie Ihre API-Anfrage mit Ihrer Ziel-URL und allen spezifischen Parametern, die Sie benötigen, wie z. B. Geolokalisierung für SERP-Abfragen oder Sitzungsverwaltungseinstellungen.
5. Lassen Sie Scrapeless die Arbeit machen: Sobald die Anfrage gesendet wurde, kümmert sich Scrapeless im Hintergrund um alle Komplexitäten. Dazu gehören die Verwaltung eines riesigen Proxy-Netzwerks, die Rotation von IP-Adressen, das Lösen von CAPTCHAs und die Verwendung echter Browser-Fingerabdrücke, um menschliches Verhalten nachzuahmen und Blockaden zu vermeiden.
6. Strukturierte Daten erhalten: Sie erhalten saubere, strukturierte Daten im JSON-Format, die sofort in Ihren Anwendungen, Datenbanken oder KI-Modellen verwendet werden können. Sie zahlen nur für erfolgreiche Anfragen, was die Kosteneffizienz gewährleistet.
Scrapeless ist ein vielseitiges Werkzeug, das in verschiedenen Branchen und Funktionen anwendbar ist:
• E-Commerce & Marktintelligenz: Verfolgen Sie die Produktpreise von Wettbewerbern, überwachen Sie Lagerbestände, analysieren Sie Preisstrategien und sammeln Sie Kundenbewertungen von jeder E-Commerce-Plattform oder jedem Marktplatz.
• SEO & Content-Strategie: Nutzen Sie die Deep-SERP-API, um Keyword-Rankings in Echtzeit zu überwachen, SERP-Funktionen zu analysieren, Markenerwähnungen zu verfolgen und Content-Möglichkeiten zu entdecken.
• KI und Maschinelles Lernen: Versorgen Sie große Sprachmodelle (LLMs) und Retrieval-Augmented Generation (RAG)-Systeme mit frischen, strukturierten und relevanten Daten aus dem gesamten Web, um die Genauigkeit und Aktualität von KI-gesteuerten Erkenntnissen zu verbessern.
• Lead-Generierung: Extrahieren Sie systematisch Kontaktinformationen, Firmendetails und andere relevante Daten aus Branchenverzeichnissen, beruflichen Netzwerken und Unternehmenswebsites, um gezielte Lead-Listen zu erstellen.
• Finanzdatenanalyse: Sammeln Sie Echtzeit-Börsendaten, Finanznachrichten und Wirtschaftsindikatoren aus verschiedenen Online-Quellen, um Markttrendanalysen durchzuführen und Anlagestrategien zu untermauern.
Die Plattform bietet durch mehrere Schlüsselvorteile einen deutlichen Wettbewerbsvorteil:
• Einfachheit und Geschwindigkeit: Eine einzige, einheitliche API ersetzt die Notwendigkeit, eine komplexe Infrastruktur aus Proxys, Headless-Browsern und Parsern aufzubauen und zu warten, was erhebliche Entwicklungszeit und Betriebskosten spart.
• Hohe Erfolgsquote: Die intelligente, KI-gesteuerte Anti-Bot-Technologie gewährleistet eine konstant hohe Erfolgsquote bei Anfragen und minimiert Fehler, Wiederholungsversuche und Datenlücken.
• Kosteneffizienz: Mit einem 'Pay-for-Success'-Modell werden den Nutzern nur erfolgreich abgerufene Daten in Rechnung gestellt, was den Return on Investment maximiert und Budgetverschwendung durch fehlgeschlagene Versuche eliminiert.
• Unübertroffene Skalierbarkeit: Die robuste Infrastruktur ist darauf ausgelegt, Millionen von Anfragen zu bewältigen, sodass Ihre Datenoperationen mühelos von kleinen Projekten auf unternehmensweite Arbeitslasten skaliert werden können.
• Garantierte Datenqualität: Optionale Datenbereinigungs- und Transformationsdienste stellen sicher, dass die von Ihnen erhaltenen Daten genau, strukturiert und sofort für die Analyse und Integration bereit sind.
• Ethisch und sicher: Scrapeless zeigt ein starkes Engagement für Datenschutz, DSGVO-Konformität und die ethische Nutzung von Web-Scraping-Technologie und bietet einen zuverlässigen und vertrauenswürdigen Dienst.
Scrapeless arbeitet mit einem flexiblen Freemium- und nutzungsbasierten Preismodell, das für eine breite Palette von Nutzern, von einzelnen Entwicklern bis hin zu großen Unternehmen, konzipiert ist.
• Kostenlose Testversion: Neue Benutzer können sich ohne Kreditkarte anmelden, um eine kostenlose Testversion zu erhalten. Diese Testversion bietet eine großzügige Anzahl von Credits, um die gesamte Suite von Tools, einschließlich der Universal API und der SERP API, vollständig zu testen.
• Pay-As-You-Go: Dieser Plan ist ideal für kleinere Projekte oder Benutzer mit intermittierendem Scraping-Bedarf. Sie können Credits nach Bedarf kaufen und zahlen nur für erfolgreiche API-Aufrufe. Verschiedene APIs können je nach Komplexität unterschiedliche Credit-Kosten haben.
• Abonnementpläne (z. B. Starter, Pro, Business): Für Benutzer mit konstantem, hohem Volumenbedarf bietet Scrapeless monatliche Abonnementpläne an. Diese Pläne bieten ein großes Volumen an Credits zu einem ermäßigten Preis im Vergleich zu Pay-As-You-Go, zusammen mit zusätzlichen Vorteilen wie höheren Gleichzeitigkeitsgrenzen, schnellerem Support und erweiterten Funktionen.
• Enterprise-Plan: Für Unternehmen mit groß angelegten oder einzigartigen Datenanforderungen bietet der Enterprise-Plan eine vollständig maßgeschneiderte Lösung. Dies umfasst eine dedizierte Infrastruktur, maßgeschneiderte Scraper, Datenverarbeitung und -bereinigung, Echtzeit-Datenlieferungspipelines und ein umfassendes Service Level Agreement (SLA), um Leistung und Verfügbarkeit zu garantieren.
Die Preisgestaltung ist transparent, wobei die Kosten oft pro 1.000 erfolgreiche Anfragen berechnet werden (z. B. wird die Deep Serp API mit 0,1 $/1k Abfragen beworben), sodass Sie Ihre Ausgaben leicht vorhersagen und verwalten können.
Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.
Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 100% | 1.4K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇻🇳Vietnam | 33.19% | 25.6K |
| 🇮🇳India | 20.82% | 16K |
| 🇺🇸United States | 18.39% | 14.2K |
| 🇳🇬Nigeria | 14.7% | 11.3K |
| 🇧🇷Brazil | 12.9% | 9.9K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Direkt | 60.21% | 46.4K |
| Verweis | 39.79% | 30.6K |
Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.