ToolMage
Anmelden

AI TOOL COMPARISON

Neosync vs PostgresML

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

Neosync Produktübersicht

Neosync ist eine Open-Source-Plattform zur Datenanonymisierung und Generierung synthetischer Daten. Sie hilft Entwicklern und Datenwissenschaftlern, sichere, datenschutzkonforme und realistische Datensätze für Tests, Entwicklung und das Training von KI-Modellen zu erstellen und gewährleistet dabei die referenzielle Integrität über Datenbanken hinweg.

Preview

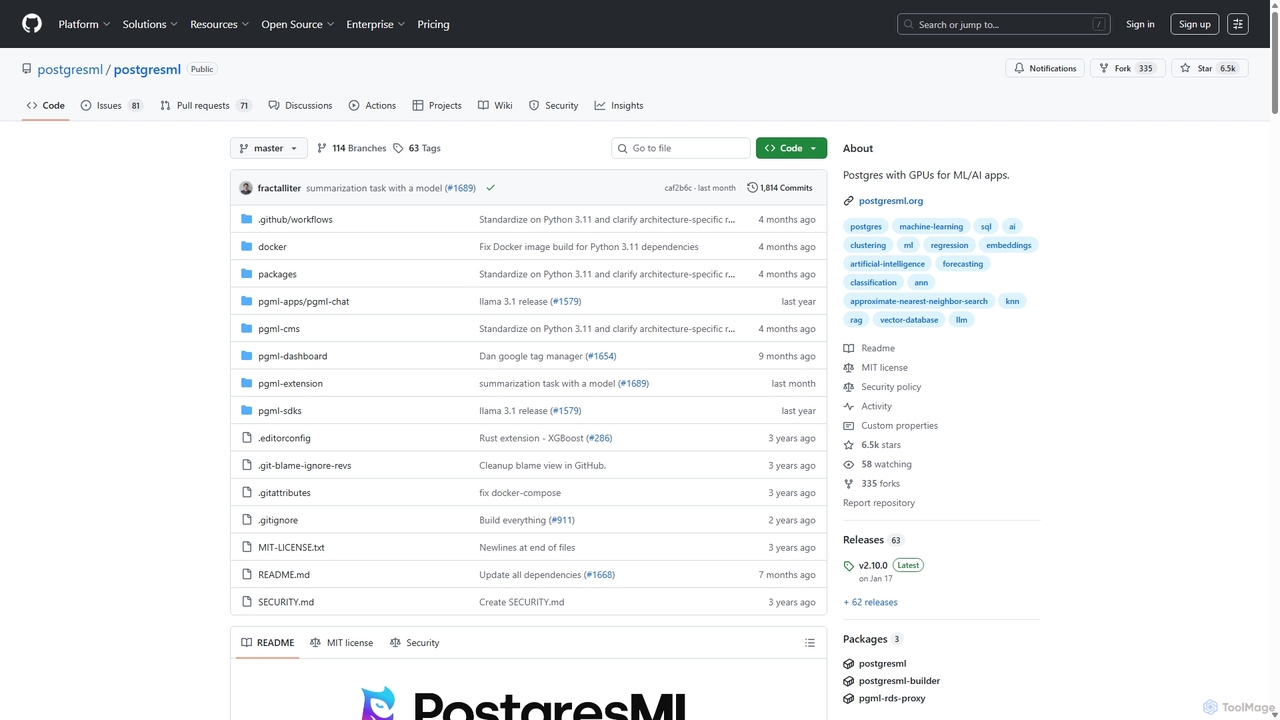
PostgresML Produktübersicht

PostgresML ist eine leistungsstarke Open-Source-Erweiterung, die maschinelles Lernen und KI direkt in Ihre PostgreSQL-Datenbank integriert. Es ermöglicht GPU-beschleunigte Inferenz, Vektorsuche und vollständige RAG-Pipelines mit einfachen SQL-Befehlen, wodurch Datenbewegungen eliminiert und der MLOps-Stack für hochleistungsfähige, skalierbare KI-Anwendungen vereinfacht wird.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Neosync VS PostgresML — Kerndaten
KerndatenNeosyncPostgresML
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusDatengenerierungMLOps
Zielgruppen und RollenDatenanalyst · Datenbankadministrator · Datenwissenschaftler · DevOps-Ingenieur · Machine Learning Ingenieur · Produktmanager · Sicherheitsanalyst · SoftwareentwicklerKI-Anwendungsentwickler · Backend-Ingenieur · Datenanalyst · Datenbankadministrator · Datenwissenschaftler · Machine Learning Ingenieur · Produktmanager · Softwareentwickler
KategorienDatengenerierung · Datenbank · DatenschutzMLOps · Vektordatenbank · Datenbank
Added02.10.202501.09.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Neosync

Neosync ist ein leistungsstarkes Open-Source-Tool, das entwickelt wurde, um kritische Herausforderungen in den Bereichen Datenschutz und Datennutzung zu bewältigen, mit denen moderne Entwicklungsteams konfrontiert sind. Es ist auf zwei Kernbereiche spezialisiert: Datenanonymisierung und die Generierung synthetischer Daten. Durch die Umwandlung sensibler Produktionsdaten in sichere, de-identifizierte Versionen ermöglicht Neosync Entwicklern, mit realistischen Datensätzen in lokalen und Staging-Umgebungen zu arbeiten, ohne Datenlecks zu riskieren oder Datenschutzbestimmungen wie DSGVO, HIPAA und CCPA zu verletzen.

Die Plattform wurde speziell für Entwickler konzipiert und bietet eine nahtlose Integration in bestehende Arbeitsabläufe. Sie kann sich mit verschiedenen Datenquellen verbinden, hauptsächlich mit relationalen Datenbanken wie PostgreSQL und MySQL, und ermöglicht es Benutzern, Regeln für die Datentransformation zu definieren, während die strukturelle und statistische Integrität erhalten bleibt. Das bedeutet, dass Beziehungen zwischen Tabellen (Fremdschlüssel) beibehalten werden, was sicherstellt, dass sich die anonymisierten oder synthetischen Daten wie die echten verhalten – ein entscheidender Faktor für genaue Tests und eine zuverlässige Anwendungsentwicklung.

Wie man Neosync verwendet

Die Verwendung von Neosync folgt typischerweise einem strukturierten, entwicklerzentrierten Arbeitsablauf:

  1. Mit einer Datenquelle verbinden: Konfigurieren Sie zunächst Neosync, um eine Verbindung zu Ihrer Produktions- oder Quelldatenbank (z. B. PostgreSQL, MySQL) herzustellen. Dies geschieht oft über eine Konfigurationsdatei oder eine Benutzeroberfläche.
  2. Datentransformationsjobs definieren: Erstellen Sie einen Job, um festzulegen, wie die Daten behandelt werden sollen. Sie identifizieren die Tabellen und Spalten, die Sie einbeziehen möchten.
  3. Anonymisierungsregeln konfigurieren: Wählen Sie für jede sensible Spalte (z. B. Namen, E-Mails, Telefonnummern, Sozialversicherungsnummern) einen „Transformer“. Neosync bietet eine Bibliothek mit vorgefertigten Transformatoren (z. B. Zufallszeichenfolgen-Generator, E-Mail-Maskierer, Adress-Randomizer), um echte Daten durch realistische, aber gefälschte Daten zu ersetzen.
  4. Synthetische Daten generieren: Wenn Sie Daten von Grund auf neu erstellen müssen, können Sie ein Schema definieren und Neosync verwenden, um es mit großen Mengen statistisch fundierter und referenziell intakter Daten zu füllen. Dies ist ideal für Lasttests oder das Training von ML-Modellen ohne echte Daten.
  5. Referenzielle Integrität wahren: Neosync behandelt Fremdschlüsselbeziehungen automatisch und stellt sicher, dass, wenn Sie eine Benutzer-ID in einer Tabelle anonymisieren, alle entsprechenden Datensätze in anderen Tabellen konsistent aktualisiert werden.
  6. Ausführen und Synchronisieren: Führen Sie den Job aus, um die Daten zu verarbeiten, und synchronisieren Sie den resultierenden sicheren Datensatz an ein Ziel Ihrer Wahl, z. B. eine lokale Entwicklerdatenbank, eine Staging-Umgebung oder einen Cloud-Speicher-Bucket.

Kernfunktionen von Neosync

  • Datenanonymisierung: Ein reichhaltiger Satz von Datentransformatoren zum Maskieren, Ersetzen oder Generieren von gefälschten Daten für verschiedene Datentypen, um personenbezogene Daten (PII) effektiv zu entfernen.
  • Generierung synthetischer Daten: Die Fähigkeit, große, hochgradig originalgetreue synthetische Datensätze zu erstellen, die die statistischen Eigenschaften und das Schema Ihrer Produktionsdaten widerspiegeln.
  • Wahrung der referenziellen Integrität: Intelligente Aufrechterhaltung von Beziehungen über Tabellen und Datenbanken hinweg, um fehlerhafte Verknüpfungen zu vermeiden und die Datenkonsistenz zu gewährleisten.
  • Daten-Subsetting: Erstellen Sie kleinere, gezielte und voll funktionsfähige Teilmengen Ihrer Produktionsdatenbank, um Entwicklungs- und Testzyklen zu beschleunigen.
  • Open-Source und erweiterbar: Als Open-Source-Projekt bietet es Transparenz, Community-Support und die Möglichkeit, benutzerdefinierte Transformatoren für spezifische Anforderungen zu erstellen.
  • Datenbankkompatibilität: Unterstützt nativ gängige Datenbanken wie PostgreSQL und MySQL, mit einer wachsenden Liste von Integrationen.

Anwendungsfälle für Neosync

Neosync ist in einer Vielzahl von Szenarien von unschätzbarem Wert:

  • Lokale Entwicklung & Tests: Stellt Entwicklern sichere, produktionsähnliche Daten auf ihren lokalen Rechnern zur Verfügung und eliminiert die Sicherheitsrisiken, die mit der Verwendung echter Produktionsdaten verbunden sind.
  • CI/CD-Pipelines: Automatisieren Sie die Erstellung frischer, anonymisierter Daten für jeden Testlauf in Ihren Continuous-Integration- und Deployment-Pipelines.
  • KI und Maschinelles Lernen: Trainieren Sie ML-Modelle mit großen, realistischen Datensätzen, ohne die Privatsphäre der Benutzer zu gefährden.
  • Verkaufsdemos und Präsentationen: Erstellen Sie überzeugende Produktdemonstrationen mit realistisch aussehenden Daten, die keine sensiblen Kundeninformationen enthalten.
  • Datenweitergabe an Dritte: Teilen Sie Daten sicher mit Partnern oder Forschern, indem Sie zuerst alle sensiblen Informationen anonymisieren.
  • Einhaltung gesetzlicher Vorschriften: Hilft Organisationen, die Anforderungen von Datenschutzgesetzen wie DSGVO, HIPAA und CCPA zu erfüllen, indem Daten, die in Nicht-Produktionsumgebungen verwendet werden, de-identifiziert werden.

Vorteile von Neosync

Neosync bietet mehrere entscheidende Vorteile:

  • Erhöhte Sicherheit und Datenschutz: Reduziert das Risiko von Datenlecks drastisch, indem sensible Daten aus Entwicklungs- und Testumgebungen entfernt werden.
  • Gesteigerte Entwicklergeschwindigkeit: Beschleunigt Entwicklungszyklen durch sofortigen Zugriff auf sichere und realistische Daten und beseitigt datenbezogene Engpässe.
  • Hochgradig originalgetreue Daten: Der Fokus auf referenzielle Integrität und statistische Erhaltung stellt sicher, dass die Testdaten ein wahres Abbild der Produktionsdaten sind, was zu weniger Fehlern führt.
  • Kosteneffektiv: Das Open-Source-Modell macht es zu einer zugänglichen Lösung für Teams jeder Größe, mit Optionen für Unternehmenssupport und Managed Services.
  • Flexibilität: Kann selbst gehostet und an einzigartige Datenstrukturen und Sicherheitsanforderungen angepasst werden.

Preise und Pläne

Neosync arbeitet nach einem Freemium-Modell. Die Kernplattform ist Open-Source und kostenlos nutzbar, sodass jeder sie selbst hosten und ihre Datenanonymisierungs- und Synthesefunktionen nutzen kann. Für Organisationen, die erweiterte Funktionen, Managed Services oder dedizierten Support benötigen, bietet Neosync in der Regel kostenpflichtige Enterprise- oder Cloud-Pläne an. Diese Pläne umfassen oft Funktionen wie rollenbasierte Zugriffskontrolle, priorisierten Support und verwaltete Infrastruktur.

PostgresML

PostgresML ist eine transformative Open-Source-Erweiterung, die Funktionen für maschinelles Lernen und KI direkt in die PostgreSQL-Datenbank bringt. Durch das Einbetten von Modellen und Algorithmen in die Datenschicht verändert es grundlegend, wie KI-Anwendungen erstellt werden. Die Kernphilosophie ist, dass es effizienter, handhabbarer und zuverlässiger ist, Modelle zu den Daten zu bewegen, anstatt ständig große, dynamische Datensätze zu den Modellen zu verschieben. Dieser Ansatz eliminiert komplexe Datenpipelines, reduziert die Latenz und erhöht die Sicherheit.

PostgresML verwandelt Ihre bestehende Datenbank in eine voll funktionsfähige KI-Plattform. Es unterstützt eine breite Palette von Funktionalitäten, von traditionellen maschinellen Lernmodellen wie Klassifizierung und Regression bis hin zu modernsten Deep-Learning-Anwendungen mit großen Sprachmodellen (LLMs) und Vektorsuche. Durch die Nutzung der Leistung von GPUs beschleunigt es Berechnungen und Modellinferenzen und macht Echtzeit-KI für Systeme mit hohem Durchsatz realisierbar.

Wie man PostgresML verwendet

Der Einstieg in PostgresML ist unkompliziert gestaltet und bietet Optionen für Cloud- und selbst gehostete Umgebungen.

  1. PostgresML Cloud (Empfohlen): Der einfachste Weg, um zu beginnen, ist die Anmeldung für ein kostenloses Konto in der PostgresML Cloud. Dies bietet Ihnen in Sekundenschnelle eine serverlose, vollständig verwaltete PostgreSQL-Datenbank mit Zugriff auf GPUs und hochmoderne LLMs ohne Einrichtungsaufwand.
  2. Selbst-Hosting: Für Benutzer, die ihre eigene Infrastruktur verwalten möchten, kann PostgresML mit Docker selbst gehostet werden. Sie können das offizielle Image herunterladen und mit einem einfachen Befehl ausführen, was Ihnen die volle Kontrolle über Ihre Umgebung gibt. Der Befehl lautet typischerweise: docker run -it -v postgresml_data:/var/lib/postgresql -p 5433:5432 -p 8000:8000 ghcr.io/postgresml/postgresml:latest.
  3. Abfragen ausführen: Nach der Einrichtung interagieren Sie mit PostgresML über Standard-SQL. Sie können Modelle trainieren (z. B. pgml.train()), Vorhersagen treffen (z. B. pgml.predict()) und komplexe KI-Pipelines ausführen. Zum Beispiel ist das Generieren von Texteinbettungen so einfach wie das Aufrufen der Funktion pgml.embed() auf einer Textspalte.
  4. Verwendung von SDKs: Für eine nahtlose Anwendungsintegration bietet PostgresML spezifische Client-Bibliotheken wie Korvus (für Python, JavaScript, Rust und C) und postgresml-django an, die die gesamte RAG-Pipeline in eine einzige Datenbankabfrage oder ORM-Operation integrieren.

Kernfunktionen von PostgresML

  • In-Database ML/AI: Führen Sie maschinelles Lernen und KI-Operationen direkt in PostgreSQL aus, wodurch separate Systeme und Datenübertragungen überflüssig werden.
  • GPU-Beschleunigung: Nutzt die GPU-Leistung für deutlich schnellere Berechnungen und Modellinferenzen, was für Echtzeitanwendungen entscheidend ist.
  • Große Sprachmodelle (LLMs): Integriert und nutzt hochmoderne LLMs von Hubs wie Hugging Face direkt in Ihrer Datenbank.
  • End-to-End RAG-Pipeline: Bietet integrierte SQL-Funktionen für den gesamten Retrieval-Augmented Generation (RAG)-Workflow: pgml.chunk zum Aufteilen von Text, pgml.embed zum Generieren von Vektoreinbettungen, pgml.rank zum Neusortieren von Ergebnissen und pgml.transform zur Textgenerierung.
  • Vektorsuche: Nahtlose Integration mit pgvector für eine effiziente und skalierbare hochdimensionale Vektorähnlichkeitssuche.
  • Vielfältige ML-Algorithmen: Enthält über 47 integrierte Klassifizierungs- und Regressionsalgorithmen (wie XGBoost) für traditionelle maschinelle Lernaufgaben.
  • Hohe Leistung & Skalierbarkeit: Liefert eine 8-40x schnellere Inferenz im Vergleich zu HTTP-basiertem Modell-Serving und ist für die Unterstützung von Millionen von Transaktionen pro Sekunde mit horizontaler Skalierung ausgelegt.
  • Umfassende NLP-Aufgaben: Unterstützt eine breite Palette von NLP-Aufgaben, einschließlich Textklassifizierung, Zusammenfassung, Übersetzung, Beantwortung von Fragen und Textgenerierung.

Anwendungsfälle für PostgresML

PostgresML ist ideal für Entwickler und Datenwissenschaftler, die eine neue Generation von KI-gestützten Anwendungen entwickeln.

  • Semantische Suche & Empfehlungssysteme: Erstellen Sie leistungsstarke Suchsysteme, die die Absicht des Benutzers verstehen, indem Sie Vektoreinbettungen verwenden, um semantisch ähnliche Elemente zu finden.
  • KI-gestützte Chatbots & Q&A-Systeme: Implementieren Sie anspruchsvolle RAG-Pipelines, um Chatbots zu erstellen, die Fragen auf der Grundlage einer privaten Wissensdatenbank beantworten können, die in der Datenbank gespeichert ist.
  • Echtzeit-Betrugserkennung: Trainieren und implementieren Sie Klassifizierungsmodelle direkt in der Datenbank, um Transaktionsdaten in Echtzeit zu analysieren und verdächtige Aktivitäten mit geringer Latenz zu kennzeichnen.
  • Datenanalyse & Business Intelligence: Verwenden Sie In-Database-NLP, um Kundenbewertungen zusammenzufassen, Support-Tickets zu klassifizieren oder Einblicke aus unstrukturierten Textdaten zu gewinnen, ohne sie jemals aus Postgres verschieben zu müssen.
  • Personalisierte Inhaltsgenerierung: Nutzen Sie LLMs, um personalisierte Marketingtexte, Produktbeschreibungen oder E-Mail-Antworten basierend auf den in der Datenbank gespeicherten Benutzerdaten zu generieren.

Vorteile von PostgresML

Der Hauptvorteil von PostgresML liegt in seiner architektonischen Einfachheit und Effizienz.

  • Reduzierte Latenz: Durch die gemeinsame Unterbringung von Modellen und Daten wird der Netzwerk-Overhead eliminiert, was zu einer schnelleren Abfrageleistung führt.
  • Erhöhte Sicherheit & Datenschutz: Die Daten bleiben in den sicheren Grenzen Ihrer Datenbank, was die Einhaltung von Vorschriften vereinfacht und das Risiko von Datenlecks verringert.
  • Vereinfachter MLOps-Stack: Es konsolidiert den Datenspeicher, das Modell-Serving und die Vektordatenbank in einem einzigen System, was die Infrastrukturkomplexität und die Betriebskosten reduziert.
  • Entwicklererfahrung: Ermöglicht es Entwicklern, vertrautes SQL zu verwenden, um komplexe KI-Funktionen zu erstellen und bereitzustellen, was die Einstiegshürde senkt und die Entwicklungszyklen beschleunigt.
  • Skalierbarkeit: Auf der robusten und skalierbaren Grundlage von PostgreSQL aufgebaut, kann es Workloads auf Unternehmensebene bewältigen.

Preise und Pläne

PostgresML arbeitet nach einem Freemium-Modell und bietet Flexibilität für unterschiedliche Bedürfnisse.

  • Open Source Self-Hosting: Die PostgresML-Erweiterung ist Open Source (MIT-Lizenz) und kann kostenlos selbst gehostet werden, was Ihnen die volle Kontrolle über Ihre Umgebung gibt.
  • PostgresML Cloud: Eine verwaltete, serverlose Cloud-Plattform ist verfügbar. Sie beinhaltet eine großzügige kostenlose Stufe, die es Entwicklern ermöglicht, schnell mit einer kostenlosen Datenbank, GPU-Zugang und vorkonfigurierten LLMs zu starten. Bezahlte Pläne sind für Anwendungen verfügbar, die mehr Ressourcen, dedizierte GPUs und Support auf Unternehmensebene erfordern.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Datenbank
Nur Neosync
DatengenerierungDatenschutz
Nur PostgresML
MLOpsVektordatenbank

Tags

Gemeinsam
DatenbankOpen Source
Nur Neosync
DatenanonymisierungDatenmaskierungEntwicklerwerkzeugeGDPRHIPAAPersonenbezogene DatenDatenschutzSicherheitsynthetische DatenTestdaten
Nur PostgresML
KI-InfrastrukturEinbettungenGPUGroßes Sprachmodellmaschinelles LernenMLOpsNLPPostgreSQLRetrieval-Augmentierte GenerierungSQLVektordatenbank

Zielgruppen und Rollen

Gemeinsam
DatenanalystDatenbankadministratorDatenwissenschaftlerMachine Learning IngenieurProduktmanagerSoftwareentwickler
Nur Neosync
DevOps-IngenieurSicherheitsanalyst
Nur PostgresML
KI-AnwendungsentwicklerBackend-Ingenieur

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Neosync

Nicht verifiziert

PostgresML

Nicht verifiziert

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

Neosync

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
166
Likes
155

PostgresML

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
183
Likes
167

Neosync vs PostgresML · Vergleichs-FAQ

What do Neosync and PostgresML have in common?
Both tools are listed under Datenbank. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Neosync and PostgresML free?
Listed pricing models: Neosync — Freemium; PostgresML — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Neosync and PostgresML?
The primary listed category is Datengenerierung for Neosync, and MLOps for PostgresML. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche