ToolMage
Anmelden

AI TOOL COMPARISON

No-Code Scraper vs ParseHub

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Produktübersicht

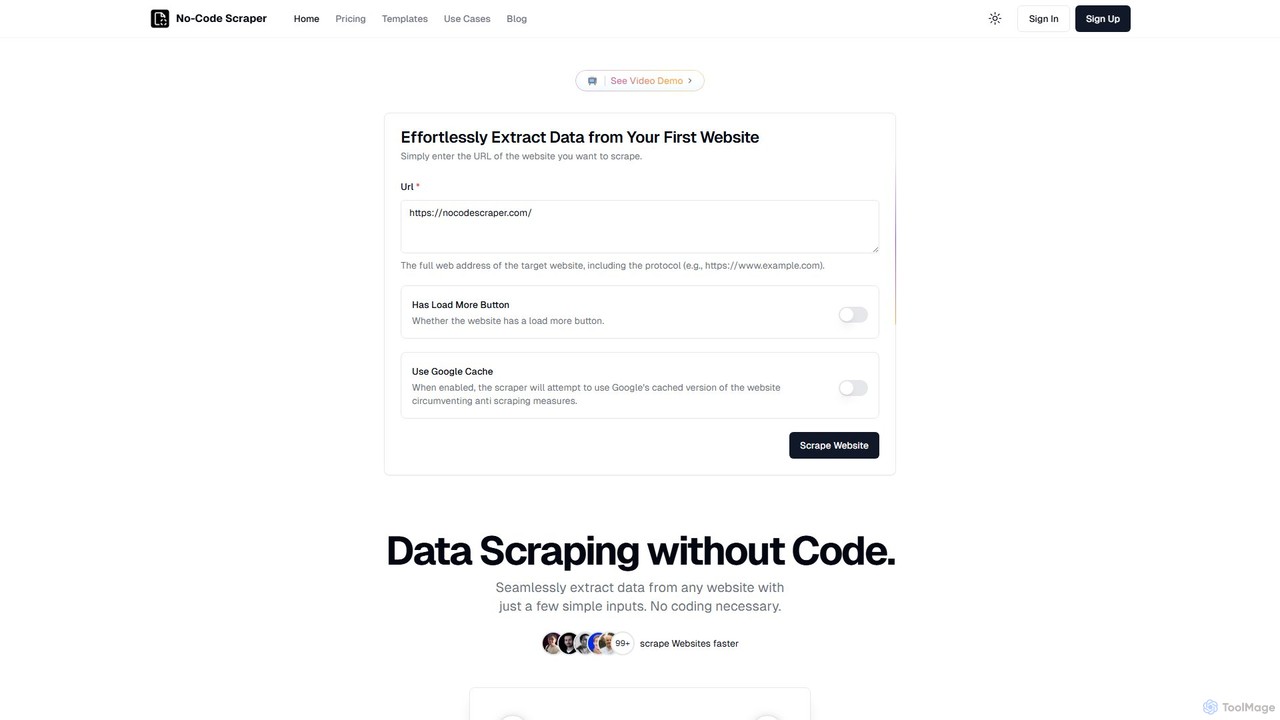
No-Code Scraper Produktübersicht

No-Code Scraper ist eine KI-gestützte Plattform, die es Benutzern ermöglicht, Daten von jeder Website zu extrahieren, ohne eine einzige Zeile Code zu schreiben. Sie verwendet große Sprachmodelle, um die Datenextraktion, -bereinigung und -strukturierung zu automatisieren und macht Web Scraping für jeden zugänglich, zuverlässig und effizient.

Preview

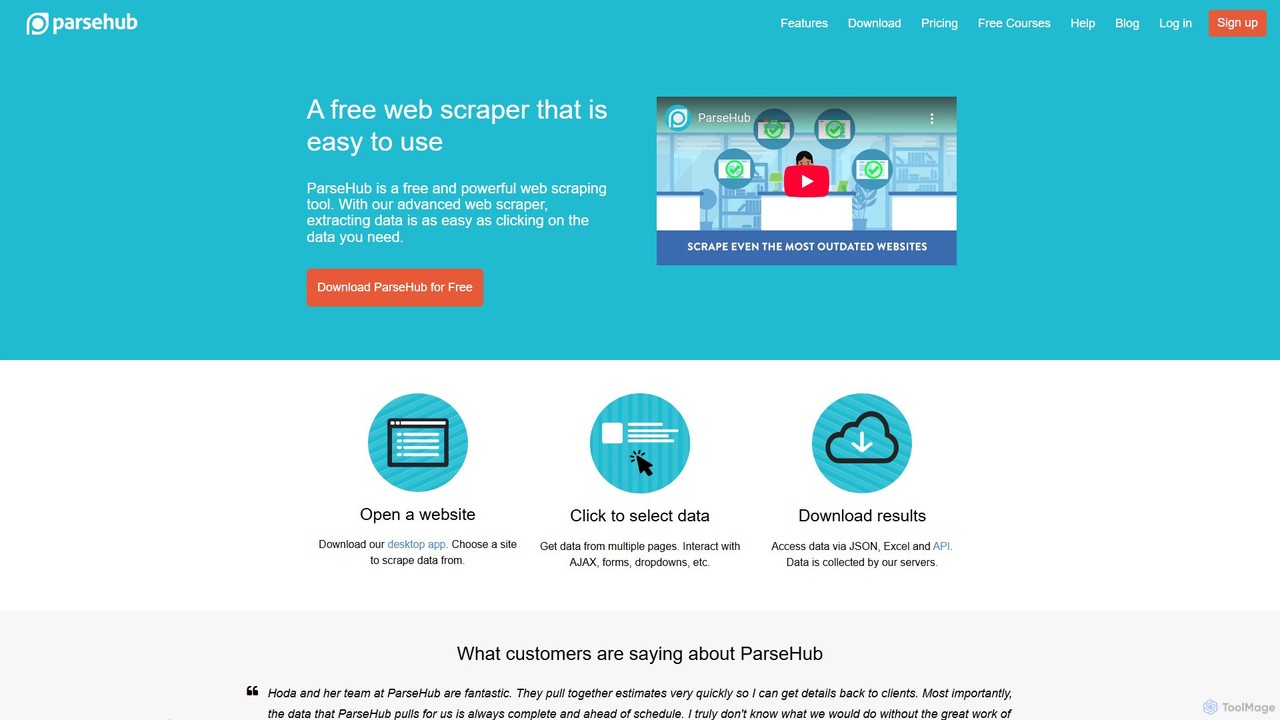
ParseHub Produktübersicht

ParseHub ist ein leistungsstarkes No-Code Web-Scraping-Tool, mit dem Benutzer Daten von jeder Website über eine einfache Point-and-Click-Oberfläche extrahieren können. Es ist für die Verarbeitung komplexer, dynamischer Websites mit JavaScript, AJAX, Formularen und unendlichem Scrollen konzipiert. Daten können nach Zeitplan gesammelt, als JSON/Excel exportiert oder über eine API abgerufen werden, was es ideal für die Lead-Generierung, Marktforschung und Datenaggregation macht.

Preview

Kerndaten

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

No-Code Scraper VS ParseHub — Kerndaten
KerndatenNo-Code ScraperParseHub
Pricing modelFreemiumFreemium
Product typeWebApp
Primary focusWeb ScrapingWeb Scraping
Zielgruppen und RollenNicht verifiziertNicht verifiziert
KategorienWeb Scraping · Lead-Generierung · Entwicklung · AutomatisierungWeb Scraping · Datenextraktion · Lead-Generierung · Automatisierung
Added10.08.202506.08.2025
Aktualisiert19.11.202619.11.2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

No-Code Scraper

No-Code Scraper ist ein revolutionäres Werkzeug, das entwickelt wurde, um die Extraktion von Webdaten zu demokratisieren. Es ermöglicht Benutzern, unabhängig von ihrem technischen Hintergrund, wertvolle Informationen nahtlos von jeder Website abzurufen. Durch die Nutzung der Leistungsfähigkeit fortschrittlicher KI und großer Sprachmodelle (LLMs) automatisiert die Plattform den traditionell komplexen und fragilen Prozess des Web Scrapings. Es löst häufige Probleme wie den Bedarf an Entwicklern, häufige Ausfälle von Scrapern aufgrund von Website-Updates und die zeitaufwändige Aufgabe der Bereinigung von Rohdaten.

Die Plattform basiert auf dem Prinzip der Einfachheit und Widerstandsfähigkeit. Benutzer können mit nur wenigen Klicks mit dem Scrapen beginnen, und die zugrunde liegende KI ist so konzipiert, dass sie sich an Änderungen in der Website-Struktur anpasst und so eine konsistente und zuverlässige Datenerfassung gewährleistet. Diese 'unzerbrechliche' Qualität bedeutet, dass Sie eine einzige Vorlage erstellen und sie auf Tausenden ähnlicher Websites ohne ständige Wartung verwenden können.

Wie man No-Code Scraper verwendet

Der Einstieg in No-Code Scraper ist ein unkomplizierter dreistufiger Prozess:

  1. Websites importieren: Beginnen Sie mit der Eingabe der URL der Zielwebsite. Sie können auch eine Liste von Websites aus einer CSV-Datei für Massen-Scraping-Operationen importieren.
  2. Zu extrahierende Datenpunkte definieren: Verwenden Sie die intuitive No-Code-Oberfläche, um eine Scraping-Vorlage zu erstellen. Beschreiben Sie einfach die Daten, die Sie extrahieren möchten (z. B. 'Produktname', 'Preis', 'Kundenbewertung'). Die KI wird Ihre Anforderungen verstehen und die Extraktion, Bereinigung und Validierung für Sie übernehmen. Sie können auch aus einer Vielzahl von vorgefertigten Vorlagen für beliebte Websites wie Yelp, Google Maps, Product Hunt und mehr wählen.
  3. Scraping-Job starten: Wenn Ihre Vorlage konfiguriert ist, starten Sie den Job mit einem einzigen Klick. Die KI beginnt mit der Arbeit und scrapt die Daten gemäß Ihren Spezifikationen. Nach Abschluss können Sie die perfekt strukturierten Ergebnisse als CSV-, Excel- oder JSON-Datei herunterladen oder sie mit höherstufigen Plänen direkt in Tools wie Google Sheets, Notion und Airtable exportieren.

Kernfunktionen von No-Code Scraper

  • KI-gestützte No-Code-Oberfläche: Richten Sie Scraper einfach ein, indem Sie die benötigten Daten in einfacher Sprache beschreiben, keine HTML- oder CSS-Kenntnisse erforderlich.
  • Unzerbrechliche Widerstandsfähigkeit: Die KI passt sich automatisch an Änderungen des Website-Layouts an, verhindert das Versagen von Scrapern und eliminiert die Notwendigkeit ständiger Wartung.
  • Automatisierte Datenbereinigung: Erhalten Sie sofort perfekt strukturierte, saubere und formatierte Daten und sparen Sie Stunden manueller Datenaufbereitung.
  • Umfangreiche vorgefertigte Vorlagen: Eine große Bibliothek von Vorlagen für gängige Anwendungsfälle und beliebte Websites wie Crunchbase, Glassdoor, Yelp und Kickstarter, um sofort mit dem Scrapen zu beginnen.
  • Erweiterte Scraping-Funktionen: Bewältigt komplexe Szenarien wie Paginierung, 'Mehr laden'-Schaltflächen und dynamisch durch JavaScript gerenderte Inhalte.
  • Google Cache-Integration: Eine Option, die zwischengespeicherte Version einer Website von Google zu verwenden, um einige Anti-Scraping-Maßnahmen zu umgehen.
  • Flexibler Datenexport: Laden Sie Daten in den Formaten CSV, Excel oder JSON herunter.
  • Integrationen & API-Zugang: Verbinden Sie sich mit Google Sheets, Notion und Airtable (Pro-Plan) oder erhalten Sie volle programmatische Kontrolle mit API-Zugang (Expert-Plan).
  • Geplantes Scrapen: Automatisieren Sie Ihre Datenerfassung, indem Sie Scraping-Jobs so planen, dass sie in regelmäßigen Abständen ausgeführt werden (Pro-Plan und höher).

Anwendungsfälle für No-Code Scraper

No-Code Scraper ist vielseitig und kann von Marketern, Gründern, Forschern und Vertriebsteams für verschiedene Zwecke verwendet werden:

  • Lead-Generierung: Extrahieren Sie Geschäftsdetails aus Verzeichnissen wie BBB oder Yelp oder berufliche Profile von Medium.
  • Marktforschung: Scrapen Sie Produktdaten von Product Hunt, App-Informationen aus App-Stores oder Markttrends von Crunchbase und Indie Hackers.
  • Wettbewerbsanalyse: Überwachen Sie die Preise von Wettbewerbern, Produktmerkmale und Kundenbewertungen von E-Commerce-Websites oder Bewertungsplattformen.
  • Personalbeschaffung: Sammeln Sie Stellenangebote von Plattformen wie Glassdoor, Upwork und Y Combinator, um Einstellungstrends zu analysieren und Möglichkeiten zu finden.
  • Immobilienanalyse: Scrapen Sie Immobilienangebote und -details von Websites wie Redfin, um Markttrends zu verfolgen und Investitionsmöglichkeiten zu finden.
  • Content-Aggregation: Erstellen Sie Verzeichnisse oder stellen Sie Journale zusammen, indem Sie Daten aus verschiedenen Quellen im Web extrahieren.

Vorteile von No-Code Scraper

Der Hauptvorteil ist seine Zugänglichkeit. Es öffnet die Welt der Webdaten für nicht-technische Benutzer. Seine KI-gesteuerte Widerstandsfähigkeit reduziert den Wartungsaufwand, der für traditionelle Scraper typisch ist, erheblich. Die automatische Datenbereinigung ist ein massiver Produktivitätssteigerer, der gebrauchsfertige Daten liefert. Die All-in-One-Plattform bewältigt alles von einfachen Datenabrufen bis hin zu komplexen, mehrseitigen Scraping-Szenarien und ist somit eine umfassende und kostengünstige Lösung.

Preise und Pläne

No-Code Scraper bietet eine 5-tägige kostenlose Testversion und mehrere Abonnementpläne auf Basis eines Credit-Systems. Credits werden für Aktionen wie das Scrapen einer Seite oder das Extrahieren von Daten verwendet.

  • Starter-Plan: 16,99 $/Monat für 400 Credits. Beinhaltet Javascript-Rendering und grundlegenden Datenexport (JSON, CSV, Excel).
  • Pro-Plan: 19,99 $/Monat für 400 Credits. Beinhaltet alle Starter-Funktionen sowie den Export nach Google Sheets, Notion und Airtable und geplante Scraping-Jobs.
  • Expert-Plan: 25,99 $/Monat für 400 Credits. Beinhaltet alle Pro-Funktionen sowie vollen API-Zugang und Premium-Proxy-Unterstützung für anspruchsvollere Aufgaben.

Die Anzahl der benötigten Credits variiert je nach Aufgabe. Zum Beispiel kostet ein einfacher Seiten-Scrape 1 Credit, während das Scrapen und Extrahieren von Daten von einer Seite mit einem Proxy 6 Credits kostet.

ParseHub

ParseHub ist ein kostenloses und leistungsstarkes Web-Scraping-Tool, das entwickelt wurde, um die Datenextraktion aus dem Web für jeden zugänglich zu machen, unabhängig von seinen Programmierkenntnissen. Mit seiner fortschrittlichen visuellen Oberfläche ist das Extrahieren von Daten so einfach wie das Klicken auf die benötigten Informationen. Es ist eine robuste Lösung für jeden, von Datenwissenschaftlern und Marketern bis hin zu Entwicklern und E-Commerce-Spezialisten, die effizient Daten aus dem Web sammeln müssen.

Das Tool ist besonders geschickt im Umgang mit modernen, komplexen Websites. Es kann durch interaktive Elemente wie Formulare, Dropdown-Menüs, Logins und Karten navigieren. Es verwaltet auch nahtlos Websites mit unendlichem Scrollen, Tabs und Pop-ups, die für andere Scraper oft eine Herausforderung darstellen. Die Machine-Learning-Beziehungs-Engine von ParseHub analysiert intelligent die Seitenstruktur, versteht die Hierarchie der Elemente und extrahiert die gewünschten Daten in Sekunden, wodurch die Notwendigkeit der manuellen Dateneingabe oder des Schreibens komplexer Skripte entfällt.

Wie man ParseHub verwendet

Der Einstieg in ParseHub ist ein unkomplizierter dreistufiger Prozess:

  1. Herunterladen und Installieren: Laden Sie zuerst die kostenlose ParseHub-Desktop-Anwendung für Ihr Betriebssystem herunter und installieren Sie sie.
  2. Daten auswählen: Öffnen Sie die Anwendung und geben Sie die URL der Website ein, von der Sie Daten extrahieren möchten. Sobald die Seite geladen ist, klicken Sie einfach auf die Datenfelder, die Sie extrahieren möchten. Das Auswahlwerkzeug von ParseHub erkennt intelligent ähnliche Elemente, um Daten von mehreren Elementen auf einer Seite zu erfassen. Sie können es trainieren, die Paginierung zu handhaben, um mehrere Seiten zu scrapen, mit Formularen zu interagieren, um Suchanfragen zu senden, und vieles mehr.
  3. Ausführen und Herunterladen: Sobald Ihr Projekt konfiguriert ist, können Sie das Scraping ausführen. Die Daten werden auf den Cloud-Servern von ParseHub gesammelt, was bedeutet, dass Sie die App schließen können, während sie arbeitet. Nach Abschluss des Laufs können Sie auf die extrahierten Daten über die API zugreifen oder sie in verschiedenen Formaten, einschließlich Excel und JSON, herunterladen, bereit für die Analyse oder Integration in andere Systeme.

Kernfunktionen von ParseHub

  • No-Code-Oberfläche: Eine benutzerfreundliche, grafische Oberfläche, mit der Sie Scraper durch einfaches Klicken auf Elemente erstellen können.
  • Umgang mit dynamischen Websites: Kann Daten von Websites extrahieren, die JavaScript, AJAX, Cookies und Weiterleitungen verwenden. Es kann Logins, Pop-ups, Dropdowns und mehr verarbeiten.
  • Cloud-basiertes Scraping: Die gesamte Datenextraktion findet auf den Servern von ParseHub statt, wodurch die Ressourcen Ihres lokalen Computers geschont werden.
  • Geplante Sammlung: Stellen Sie Ihre Projekte so ein, dass sie automatisch täglich, wöchentlich oder nach einem benutzerdefinierten Zeitplan ausgeführt werden, um die neuesten Daten zu erhalten.
  • IP-Rotation: Rotiert automatisch durch einen großen Pool von IP-Adressen, um zu verhindern, dass Sie beim Scrapen blockiert werden.
  • Leistungsstarke Datenbereinigung: Verwenden Sie reguläre Ausdrücke (RegEx), um Text und HTML direkt in der App vor dem Herunterladen zu bereinigen und zu formatieren.
  • API und Integrationen: Greifen Sie programmgesteuert mit einer REST-API auf Ihre Daten zu und verwenden Sie Webhooks für Echtzeit-Benachrichtigungen. Es integriert sich auch mit Google Sheets, Tableau und Dropbox.
  • Flexible Datenexport: Laden Sie Ihre gescrapten Daten in den Formaten JSON, CSV und Excel herunter, um sie einfach zu analysieren und in anderen Anwendungen zu verwenden.

Anwendungsfälle für ParseHub

ParseHub ist ein vielseitiges Werkzeug, das in verschiedenen Branchen eingesetzt wird:

  • E-Commerce: Scrapen Sie Produktdetails, Preise, Bewertungen und Rezensionen von Wettbewerber-Websites zur Preisüberwachung und Marktanalyse.
  • Lead-Generierung: Extrahieren Sie Kontaktinformationen aus Online-Verzeichnissen, professionellen Netzwerken und Communities, um Vertriebstrichter aufzubauen.
  • Marktforschung: Aggregieren Sie Daten für Branchenanalysen, Wettbewerbsbeobachtung und die Identifizierung von Markttrends.
  • Datenjournalismus & Wissenschaft: Sammeln Sie große Datensätze aus öffentlichen Quellen für Forschungsprojekte, Berichte und datengesteuerte Geschichten.
  • Content-Aggregation: Sammeln Sie Artikel, Nachrichten und Beiträge von mehreren Websites, um einen Nachrichtenaggregator oder eine Content-Plattform zu betreiben.
  • Immobilien: Scrapen Sie Immobilienangebote, Preise und Maklerdetails von Immobilien-Websites.

Vorteile von ParseHub

ParseHub zeichnet sich aus mehreren wichtigen Gründen aus. Sein Hauptvorteil ist die Benutzerfreundlichkeit, die das Web-Scraping demokratisiert, indem sie die Programmierhürde beseitigt. Die Leistungsfähigkeit und Flexibilität, jede interaktive Website zu verarbeiten, machen es zu einem zuverlässigen Werkzeug für komplexe Aufgaben. Da es cloud-basiert und skalierbar ist, kann es Projekte jeder Größe bewältigen, von wenigen Seiten bis zu Millionen, ohne dass die Benutzer eine Infrastruktur verwalten müssen. Dies spart erheblich Zeit und Ressourcen und ermöglicht es den Benutzern, sich auf die Analyse der Daten anstatt auf deren Sammlung zu konzentrieren.

Preise und Pläne

ParseHub bietet eine Reihe von Plänen für unterschiedliche Bedürfnisse:

  • Kostenloser Plan: Ideal für kleine Projekte und zum Lernen. Beinhaltet 200 Seiten pro Lauf, 5 öffentliche Projekte und 14-tägige Datenaufbewahrung.
  • Standard-Plan (189 $/Monat): Für Profis konzipiert. Bietet 10.000 Seiten pro Lauf, 20 private Projekte, IP-Rotation und geplantes Scraping.
  • Professional-Plan (599 $/Monat): Für intensives Scraping. Beinhaltet unbegrenzte Seiten pro Lauf, 120 private Projekte, Prioritätssupport und 30-tägige Datenaufbewahrung.
  • ParseHub Plus (Enterprise): Ein maßgeschneiderter Plan für Unternehmen mit großem Datenbedarf, der dedizierten Support, benutzerdefinierte Funktionen und Expertenunterstützung bei der Einrichtung von Scraping-Projekten bietet.

Rabatte sind für gemeinnützige Organisationen, Studenten und akademische Einrichtungen verfügbar. Alle Preise sind in US-Dollar angegeben.

Positionierung

Die Taxonomie zeigt Überschneidungen und den jeweils eigenständigen Schwerpunkt. Unbekannte Felder werden klar ausgewiesen und nicht durch Annahmen ergänzt.

Kategorien

Gemeinsam
Web ScrapingLead-GenerierungAutomatisierung
Nur No-Code Scraper
Entwicklung
Nur ParseHub
Datenextraktion

Tags

Gemeinsam
AutomatisierungDatenextraktionData MiningLead-GenerierungMarktforschungNo-CodeWeb Scraping
Nur No-Code Scraper
KIDatenbereinigung
Nur ParseHub
DatenerfassungPreisverfolgung

Zielgruppen und Rollen

Gemeinsam
Keine verifizierten Daten
Nur No-Code Scraper
Keine verifizierten Daten
Nur ParseHub
Keine verifizierten Daten

Traffic-Vergleich

Traffic wird auf derselben Skala dargestellt, damit Sichtbarkeitsunterschiede realistisch bleiben.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

No-Code Scraper monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
3.3K
Ø Besuchsdauer
0:47
Seiten pro Besuch
2.03
Absprungrate
45.35%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5K
  • 2026-01: 2.6K
  • 2026-02: 2.2K
  • 2026-03: 5.1K
  • 2026-04: 3.9K
  • 2026-05: 3.3K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.52%1.3K
🇭🇰Hong Kong33.21%1.1K
🇮🇩Indonesia18.52%617
🇮🇳India8.75%292

Traffic-Quellen

Source typePercentageEstimated visits
Verweis94.54%3.2K
Direkt5.46%182

Suchbegriffe

instant data scraperinstant data scraper extensionno code scrapernocodescraperno code web scraper

ParseHub monthly traffic:

Latest traffic · 2026-05

Monatliche Besuche
68.7K
Ø Besuchsdauer
0:19
Seiten pro Besuch
1.89
Absprungrate
39.47%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 136.2K
  • 2026-01: 120.4K
  • 2026-02: 102.7K
  • 2026-03: 82.7K
  • 2026-04: 74K
  • 2026-05: 68.7K

Top-Regionen

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.93%27.4K
🇮🇳India23.24%16K
🇳🇬Nigeria14.19%9.7K
🇬🇧United Kingdom13.27%9.1K
🇧🇷Brazil9.37%6.4K

Traffic-Quellen

Source typePercentageEstimated visits
Direkt91.62%62.9K
Verweis6.21%4.3K
E-Mail2.17%1.5K

Suchbegriffe

free webscraping coursehow to get an html sentence for a specific value on a websitepareshubparsehubparse hub how to click on gdpr agreement first

Community-Signale

Bewertungen und Reaktionen sind Community-Signale, kein Ersatz für die Produkteignung.

No-Code Scraper

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
184
Likes
181

ParseHub

Bewertung
Nicht verifiziert
Kommentare
0
Favoriten
166
Likes
165

No-Code Scraper vs ParseHub · Vergleichs-FAQ

What do No-Code Scraper and ParseHub have in common?
Both tools are listed under Web Scraping、Lead-Generierung、Automatisierung. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are No-Code Scraper and ParseHub free?
Listed pricing models: No-Code Scraper — Freemium; ParseHub — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between No-Code Scraper and ParseHub?
The primary listed category is Web Scraping for No-Code Scraper, and Web Scraping for ParseHub. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Ähnliche Vergleiche