ToolMage
Iniciar sesión

Best 3 Evaluación del Modelo AI tools for Infraestructura de IA

Popular Evaluación del Modelo AI tools in Infraestructura de IA include Coval, Atla AI y The Foundry AI, helping you work more efficiently.

The Foundry AI
Paid

The Foundry AI

The Foundry AI es una plataforma especializada para desarrolladores que construyen agentes web de IA. Ofrece un simulador web determinista y un marco de anotación avanzado para probar, comparar y depurar agentes en un entorno reproducible, libre de la imprevisibilidad de la web en vivo.

Evaluación del Modelo
Visits 9KFavorites 145Likes 134
Coval
Paid

Coval

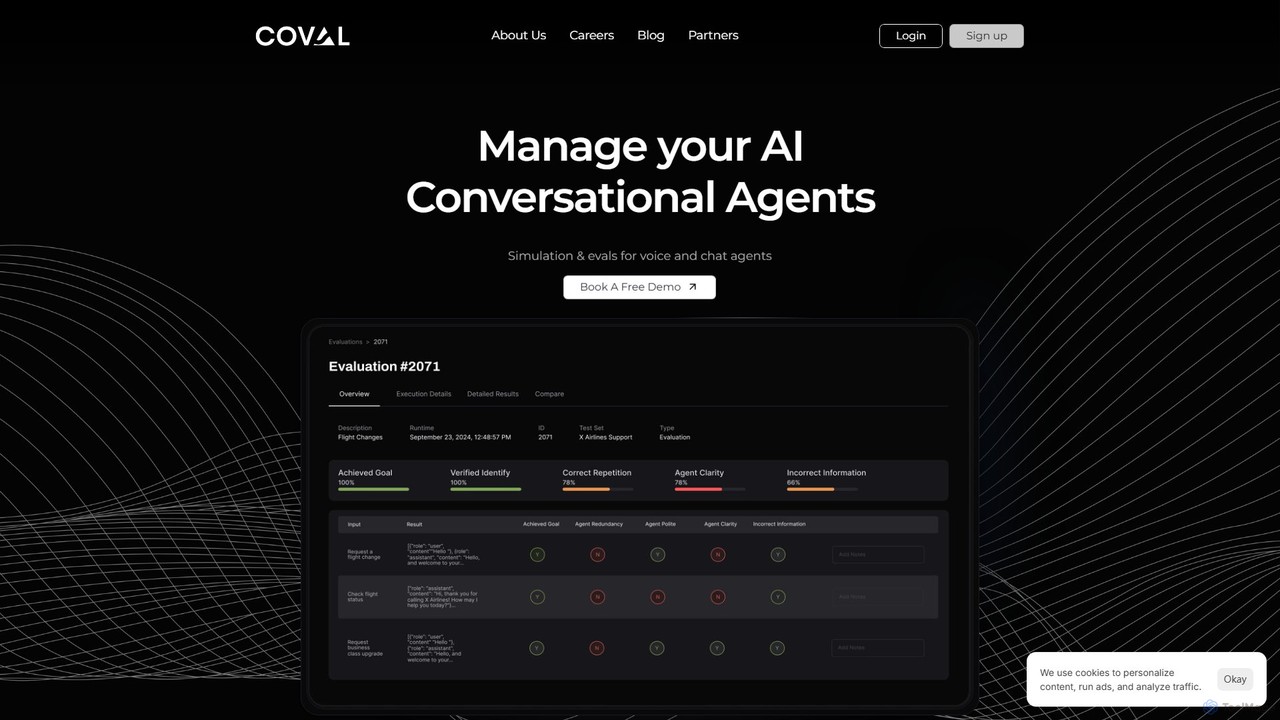
Coval es una plataforma avanzada para simular y evaluar agentes conversacionales de IA. Creada por expertos de Waymo, ayuda a los desarrolladores a probar agentes de voz y chat a escala, garantizando la fiabilidad y el rendimiento. Automatiza las pruebas simulando miles de escenarios, proporciona métricas de rendimiento detalladas y ofrece monitorización en producción para detectar regresiones y optimizar el comportamiento del agente.

Evaluación del Modelo
Visits 17.5KFavorites 156Likes 144
Atla AI
Freemium

Atla AI

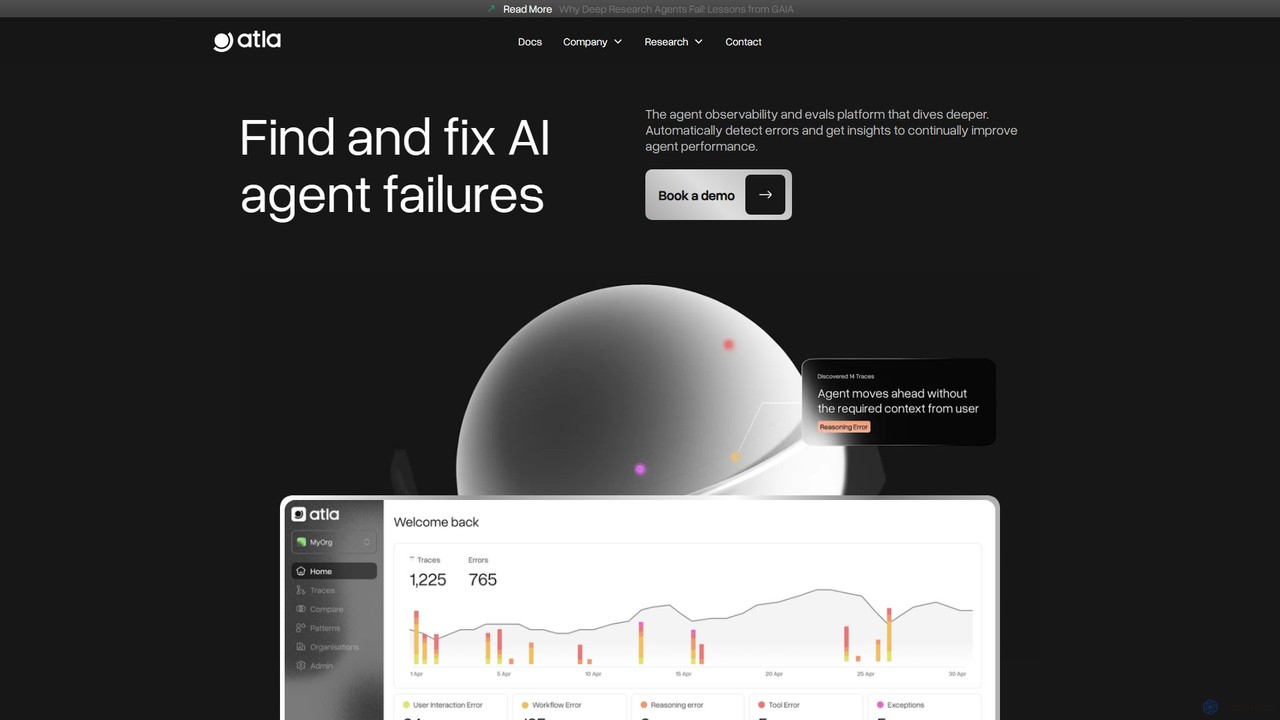
Atla AI es una plataforma de observabilidad y evaluación diseñada para agentes de IA. Ayuda a los desarrolladores a encontrar, entender y solucionar fallos de los agentes proporcionando información detallada sobre su comportamiento. La plataforma detecta errores automáticamente, identifica patrones recurrentes y ofrece sugerencias accionables para mejorar continuamente el rendimiento y las tasas de finalización del agente.

Evaluación del Modelo
Visits 10.3KFavorites 131Likes 131

About Evaluación del Modelo

Las herramientas de Evaluación de Modelos son una categoría especializada de infraestructura de IA diseñada para evaluar sistemáticamente el rendimiento, la equidad y la fiabilidad de los modelos de aprendizaje automático. Estas plataformas automatizan el proceso de cálculo de métricas clave como la exactitud, precisión y recall, al tiempo que proporcionan capacidades avanzadas para la detección de sesgos, el análisis de explicabilidad y las pruebas de robustez. Su valor principal radica en proporcionar información objetiva y basada en datos que ayuda a los desarrolladores a seleccionar el modelo con mejor rendimiento, garantizar prácticas de IA éticas y validar la preparación del modelo para entornos de producción. Esta evaluación rigurosa es un paso crítico en el ciclo de vida de MLOps, asegurando que los modelos desplegados sean efectivos, confiables y alineados con los objetivos de negocio.

Funciones Clave

  • Seguimiento de Métricas de Rendimiento: Calcula y visualiza automáticamente métricas estándar para clasificación (Exactitud, F1-Score, AUC) y regresión (MSE, MAE, R²).
  • Auditoría de Sesgo y Equidad: Identifica disparidades de rendimiento entre diferentes subgrupos demográficos para detectar y mitigar posibles sesgos en las predicciones del modelo.
  • Análisis de Explicabilidad (XAI): Genera información sobre las decisiones del modelo utilizando técnicas como SHAP y LIME, haciendo que los modelos de caja negra sean más transparentes.
  • Pruebas de Robustez y Estrés: Evalúa la estabilidad del modelo frente a ataques adversarios, deriva de datos y casos extremos para garantizar un rendimiento fiable en el mundo real.
  • Comparación y Versionado de Modelos: Proporciona un marco para comparar múltiples modelos o diferentes versiones del mismo modelo lado a lado en conjuntos de datos estandarizados.

Casos de Uso

Las herramientas de Evaluación de Modelos son esenciales para científicos de datos, ingenieros de aprendizaje automático y equipos de MLOps, particularmente en industrias reguladas como finanzas, salud y seguros. Se utilizan durante el ciclo de desarrollo para comparar y seleccionar modelos candidatos, en verificaciones previas al despliegue para validar el cumplimiento y la equidad, y para auditorías periódicas de modelos en vivo para garantizar un rendimiento y fiabilidad continuos.

Cómo Elegir

Al seleccionar una herramienta de Evaluación de Modelos, considere su compatibilidad con sus frameworks de aprendizaje automático (p. ej., TensorFlow, PyTorch, Scikit-learn). Evalúe la amplitud de sus características: ¿cubre rendimiento, equidad y explicabilidad? Analice sus capacidades de integración con su pila de MLOps existente, como los rastreadores de experimentos y los registros de modelos. Finalmente, considere la calidad de sus funciones de visualización e informes para comunicar los resultados a las partes interesadas tanto técnicas como no técnicas.

Evaluación del Modelo use cases

1

Auditoría de Modelos Financieros para la Equidad

Un científico de datos en una institución financiera tiene la tarea de garantizar que un nuevo modelo de calificación crediticia no discrimine a grupos demográficos protegidos. Usando una herramienta de evaluación de modelos, sube las predicciones del modelo en un conjunto de datos de prueba. La herramienta genera automáticamente un informe de equidad, destacando métricas de rendimiento como las tasas de falsos positivos en diferentes géneros y etnias. Al analizar estos resultados, el científico puede identificar y mitigar sesgos antes de que el modelo se despliegue, asegurando el cumplimiento de las regulaciones de préstamos justos y reduciendo el riesgo reputacional.

2

Comparación de Arquitecturas de Modelos de Visión por Computadora

Un ingeniero de aprendizaje automático está desarrollando una función de clasificación de imágenes para una aplicación móvil y necesita elegir entre tres arquitecturas de modelos diferentes (p. ej., ResNet, MobileNet, Vision Transformer). Utiliza una plataforma de evaluación de modelos para ejecutar los tres modelos en el mismo conjunto de datos de validación. La plataforma proporciona un panel de comparación lado a lado que muestra la exactitud, el F1-score, la latencia de inferencia y el tamaño del modelo para cada uno. Esta vista completa permite al ingeniero tomar una decisión de compromiso, seleccionando el modelo que ofrece el mejor equilibrio entre exactitud y rendimiento en el dispositivo.

3

Generación de Explicaciones para Diagnósticos Médicos

En un entorno de atención médica, un radiólogo utiliza un modelo de IA que detecta anomalías en escaneos médicos. Para generar confianza y ayudar en el diagnóstico, se utiliza una función de explicabilidad (XAI) dentro de una herramienta de evaluación de modelos. Cuando el modelo señala un posible problema, la herramienta genera un mapa de calor (como una visualización SHAP o LIME) superpuesto en el escaneo original. Este mapa de calor resalta los píxeles y regiones específicos que más influyeron en la decisión del modelo. Esto permite al radiólogo verificar rápidamente el razonamiento de la IA con su propia experiencia, lo que lleva a decisiones clínicas más seguras y transparentes.

4

Pruebas de Estrés para Modelos de Percepción de Vehículos Autónomos

Un equipo de ingeniería automotriz necesita asegurarse de que el modelo de percepción en un vehículo autónomo sea extremadamente fiable. Utilizan el módulo de pruebas de robustez de una herramienta de evaluación de modelos para simular condiciones adversas. Esto implica agregar programáticamente ruido digital, niebla y lluvia a las imágenes de prueba, y ejecutar ataques adversarios para encontrar los puntos ciegos del modelo. La herramienta informa sobre cuánto se degrada la exactitud del modelo bajo cada condición. Estas rigurosas pruebas de estrés ayudan al equipo a identificar debilidades y fortalecer el modelo contra los desafíos del mundo real, un paso crítico para garantizar la seguridad.

5

Benchmarking de Modelos NLP para Chatbots de Soporte al Cliente

Un gerente de producto de un chatbot de IA quiere actualizar su modelo subyacente de Procesamiento del Lenguaje Natural (NLP). El equipo ha preseleccionado dos nuevos modelos. Usando una suite de evaluación de modelos, comparan ambos modelos con el actual en un 'conjunto de datos dorado' de conversaciones históricas de clientes. La herramienta de evaluación mide la precisión en el reconocimiento de intenciones, el F1-score de extracción de entidades y la relevancia de la respuesta. Los resultados se muestran en formato de tabla de clasificación, lo que permite al gerente de producto ver claramente qué modelo funciona mejor con sus datos específicos y tomar una decisión basada en evidencia para la actualización.

6

Validación del Comportamiento del Modelo para el Cumplimiento Normativo

Un oficial de cumplimiento en una compañía de seguros necesita proporcionar a los reguladores pruebas de que su IA de procesamiento de reclamaciones es justa y transparente. Utiliza una plataforma de evaluación de modelos para realizar una auditoría completa. La plataforma genera un informe detallado que incluye:

  • Métricas de rendimiento generales (p. ej., precisión en la detección de fraudes).
  • Análisis de equidad entre subgrupos de edad, género y ubicación.
  • Explicaciones basadas en ejemplos (XAI) para decisiones específicas de denegación de reclamaciones.
Este informe único y consolidado sirve como evidencia auditable, demostrando la debida diligencia y el cumplimiento de las regulaciones de la industria, como las directrices de ética de la IA.

Evaluación del Modelo FAQ

¿Qué son las herramientas de Evaluación de Modelos?

Las herramientas de Evaluación de Modelos son plataformas de software especializadas que se utilizan para medir y analizar el rendimiento de los modelos de aprendizaje automático. Van más allá de las simples comprobaciones de exactitud para proporcionar una evaluación profunda y multifacética. Sus funciones clave incluyen el cálculo de una amplia gama de métricas de rendimiento (como precisión, recall, F1-score), la auditoría de equidad y sesgo en diferentes grupos de población, la prueba de robustez contra datos inesperados y la provisión de explicaciones para las decisiones de un modelo (IA Explicable). Estas herramientas son una parte crucial del pipeline de MLOps, asegurando que los modelos no solo sean efectivos, sino también fiables, éticos y listos para su despliegue en el mundo real.

¿Cómo elegir la herramienta de Evaluación de Modelos adecuada?

Elegir la herramienta adecuada depende de sus necesidades específicas. Considere estos factores clave:

  • Compatibilidad de Frameworks: Asegúrese de que la herramienta sea compatible con los frameworks de ML que utiliza, como TensorFlow, PyTorch, Scikit-learn o XGBoost.
  • Alcance de la Evaluación: Determine si necesita métricas de rendimiento básicas o características más avanzadas como auditorías de equidad, explicabilidad (XAI) y pruebas de robustez.
  • Integración: Verifique si se integra sin problemas con su ecosistema de MLOps existente, incluidos los rastreadores de experimentos (como MLflow), los registros de modelos y los pipelines de CI/CD.
  • Usabilidad y Visualización: Evalúe la interfaz de usuario y la calidad de sus paneles. Una buena herramienta debería facilitar la comparación de modelos y la comunicación de los hallazgos tanto a los interesados técnicos como a los de negocio.
¿Cuál es la diferencia entre Evaluación de Modelos y Monitoreo de Modelos?

La Evaluación de Modelos y el Monitoreo de Modelos son dos etapas distintas pero relacionadas en el ciclo de vida de MLOps. La Evaluación de Modelos es principalmente una actividad previa al despliegue. Implica probar rigurosamente un modelo en un conjunto de datos estático e histórico para evaluar su calidad, compararlo con otros modelos y decidir si está listo para producción. Su objetivo es seleccionar el mejor modelo posible. Por otro lado, el Monitoreo de Modelos es una actividad posterior al despliegue. Implica el seguimiento continuo del rendimiento de un modelo en vivo en el entorno de producción. Su objetivo principal es detectar problemas como la degradación del rendimiento, la deriva de datos (cuando los datos de entrada cambian con el tiempo) o la deriva de conceptos, y activar alertas para reentrenamiento o intervención.

¿Qué métricas clave rastrean las herramientas de Evaluación de Modelos?

Las herramientas de Evaluación de Modelos rastrean una amplia variedad de métricas adaptadas a diferentes tareas de aprendizaje automático. Para tareas de clasificación, las métricas comunes incluyen Exactitud, Precisión, Recall, F1-Score y AUC-ROC. Para tareas de regresión, rastrean el Error Absoluto Medio (MAE), el Error Cuadrático Medio (MSE) y el R-cuadrado. Más allá del rendimiento, también miden métricas de equidad como la Paridad Demográfica y las Probabilidades Igualadas para verificar sesgos, y proporcionan salidas para la explicabilidad, como los valores SHAP, que cuantifican el impacto de cada característica en una predicción.

¿Por qué es crucial la Evaluación de Modelos en el desarrollo de IA?

La Evaluación de Modelos es crucial porque va más allá de simplemente verificar si un modelo 'funciona' para asegurar que funcione de manera correcta, justa y fiable. Un modelo con alta exactitud puede ser inútil o incluso perjudicial si está sesgado contra un cierto grupo, no es robusto a cambios menores en los datos de entrada, o es una 'caja negra' que nadie puede entender o en la que nadie puede confiar. Una evaluación rigurosa ayuda a mitigar riesgos empresariales significativos, como tomar malas decisiones basadas en predicciones erróneas, enfrentar multas regulatorias por prácticas discriminatorias o perder la confianza del cliente debido a un comportamiento impredecible del modelo. Es una práctica fundamental para construir sistemas de IA responsables y listos para producción.