
ToolMage
Iniciar sesión

Best 1 Datos de Entrenamiento AI tools for Visión por Computadora

Popular Datos de Entrenamiento AI tools in Visión por Computadora include Scematics, helping you work more efficiently.

Scematics
Paid

Scematics

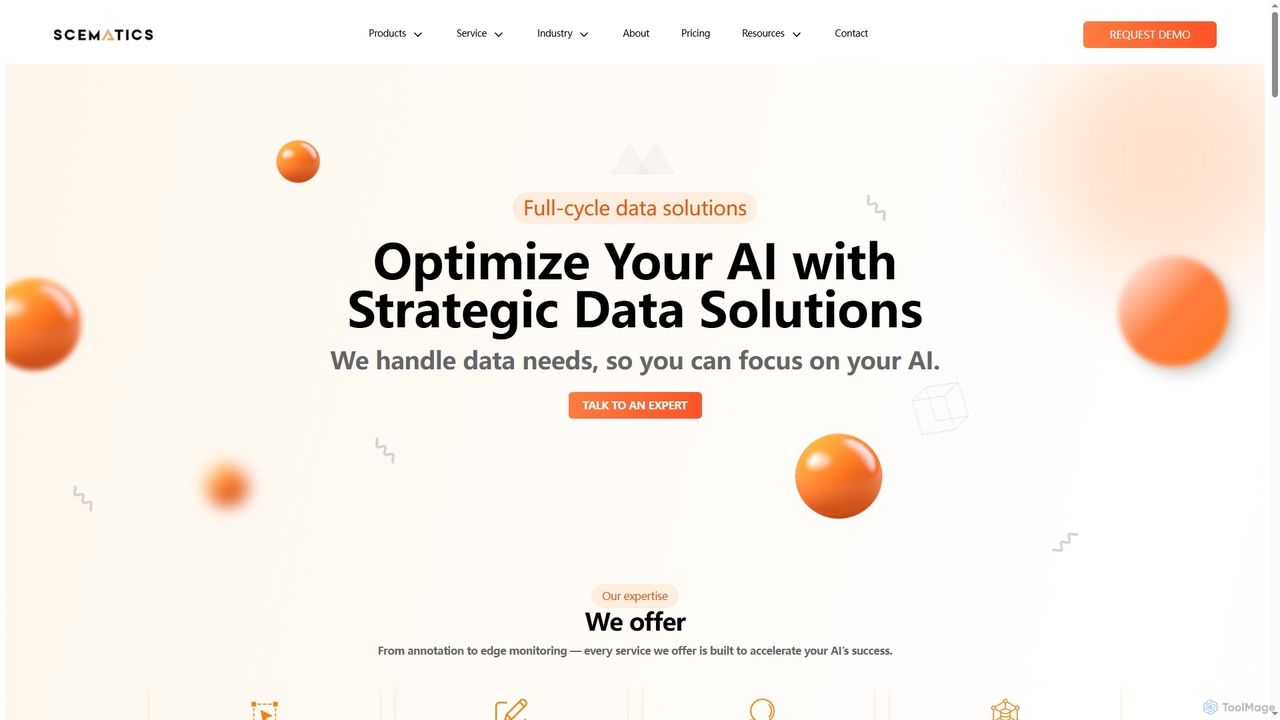
Scematics es una plataforma todo en uno de anotación y etiquetado de datos que proporciona soluciones de datos estratégicas para optimizar modelos de IA. Ofrece herramientas intuitivas, servicios de anotación expertos, monitoreo de casos extremos y generación de datos sintéticos, lo que permite a los equipos construir conjuntos de datos de entrenamiento escalables y de alta calidad para diversas aplicaciones de IA en múltiples industrias.

3D
Visits 6.4KFavorites 136Likes 137

About Datos de Entrenamiento

Los Datos de Entrenamiento son conjuntos de datos diseñados específicamente para entrenar modelos de aprendizaje automático, particularmente en el ámbito de la visión por computadora. Estos suelen comprender vastas colecciones de imágenes o videos etiquetados, proporcionando los patrones y ejemplos fundamentales para que los modelos de IA aprendan y reconozcan. Los datos de entrenamiento de alta calidad son primordiales para desarrollar sistemas de visión por computadora precisos y robustos, influyendo directamente en el rendimiento y la capacidad de generalización de un modelo. Estos datos se preparan meticulosamente mediante anotación manual, generación sintética o herramientas semiautomatizadas para cumplir con los requisitos precisos de tareas visuales específicas.

Características Principales

  • Anotación de Datos: Etiquetado preciso de objetos, regiones o atributos dentro de imágenes y videos utilizando cuadros delimitadores, polígonos o segmentación semántica.
  • Aumento de Datos: Expansión de conjuntos de datos existentes mediante transformaciones como rotación, escalado, recorte y ajustes de color para mejorar la robustez del modelo.
  • Limpieza y Deduplicación de Datos: Identificación y eliminación de puntos de datos erróneos, redundantes o de baja calidad para garantizar la integridad y pureza del conjunto de datos.
  • Generación de Datos Sintéticos: Creación de muestras de entrenamiento artificiales, pero realistas, utilizando técnicas como GANs o renderizado 3D, especialmente para escenarios raros o difíciles de obtener.
  • Gestión de Conjuntos de Datos: Herramientas para el control de versiones, almacenamiento, recuperación y uso compartido colaborativo de conjuntos de datos de entrenamiento a gran escala.

Escenarios de Aplicación

Los datos de entrenamiento son indispensables en diversas industrias y aplicaciones donde se requiere inteligencia visual. Son utilizados por ingenieros de IA para preparar conjuntos de datos para que los vehículos autónomos reconozcan peatones y señales de tráfico, por investigadores médicos para segmentar anomalías en radiografías y resonancias magnéticas, y por empresas manufactureras para entrenar modelos para la inspección de calidad automatizada de productos.

Cómo Elegir

Al seleccionar soluciones de datos de entrenamiento, priorice la precisión y la consistencia de las anotaciones, ya que esto afecta directamente el rendimiento del modelo. Evalúe la diversidad y la escala del conjunto de datos para asegurarse de que cubra una amplia gama de escenarios del mundo real. Considere la privacidad y el cumplimiento de los datos, especialmente para información sensible como el reconocimiento facial o los registros médicos. Finalmente, evalúe la rentabilidad, los plazos de entrega y la eficiencia de las herramientas de anotación y las plataformas de gestión proporcionadas.

Datos de Entrenamiento use cases

1

Anotación de Datos de Escenas Urbanas para Conducción Autónoma

Los ingenieros de conducción autónoma utilizan herramientas especializadas para anotar con precisión imágenes de escenas urbanas, marcando vehículos, peatones, señales de tráfico y líneas de carril con cuadros delimitadores o segmentación semántica. Estos datos de entrenamiento meticulosamente etiquetados se introducen en modelos de IA para permitir que los coches autónomos perciban y comprendan con precisión su entorno, lo cual es crucial para una navegación segura.

2

Segmentación Precisa de Lesiones en Imágenes Médicas

Los investigadores de IA médica utilizan plataformas de anotación profesionales para realizar la segmentación a nivel de píxel de tumores o regiones patológicas en imágenes de TC y RM. Este proceso genera datos de entrenamiento de alta calidad esenciales para desarrollar modelos de asistencia diagnóstica impulsados por IA, lo que permite una detección más precisa y temprana de enfermedades.

3

Preparación de Datos para la Detección de Defectos en Productos Industriales

Las empresas manufactureras recopilan imágenes de productos, y los expertos en control de calidad clasifican y localizan defectos como arañazos, abolladuras u objetos extraños mediante una anotación detallada. Este conjunto de datos se utiliza luego para entrenar modelos de IA para la inspección de calidad automatizada, reduciendo significativamente el tiempo de inspección manual y mejorando la consistencia en la identificación de fallas en los productos.

4

Construcción de Datos para el Reconocimiento de Atributos de Productos de E-commerce

Los equipos de operaciones de comercio electrónico realizan clasificación de múltiples etiquetas (por ejemplo, color, material, estilo) y anotación de puntos clave (por ejemplo, puños de manga, cuello) en vastas colecciones de imágenes de productos. Estos datos entrenan a la IA para reconocer automáticamente los atributos del producto, mejorando significativamente la funcionalidad de búsqueda, las recomendaciones personalizadas y la experiencia general del cliente en las plataformas de venta minorista en línea.

5

Anotación de Eventos para Comportamientos Anormales en Grabaciones de Seguridad

Los expertos en seguridad anotan videos de vigilancia para marcar segmentos de tiempo y regiones específicas donde ocurren comportamientos anormales como peleas, caídas o merodeo. Estos datos de entrenamiento etiquetados son cruciales para desarrollar sistemas de IA que puedan detectar y alertar automáticamente al personal de seguridad sobre posibles amenazas o incidentes en tiempo real, mejorando la seguridad pública y la eficiencia de respuesta.

6

Expansión de Conjuntos de Datos de Imágenes de Plagas y Enfermedades Agrícolas

Los investigadores agrícolas amplían los conjuntos de datos existentes de imágenes de plagas y enfermedades de cultivos mediante técnicas de aumento de datos (por ejemplo, rotación, escalado, ajustes de iluminación) o generación sintética. Este proceso crea un conjunto de datos de entrenamiento más diverso y robusto, mejorando significativamente la precisión de los modelos de IA en la identificación de problemas agrícolas en condiciones ambientales complejas, lo que ayuda en la intervención temprana y la protección de cultivos.

Datos de Entrenamiento FAQ

¿Qué son los Datos de Entrenamiento en Visión por Computadora?

Los Datos de Entrenamiento en Visión por Computadora se refieren a conjuntos de datos etiquetados utilizados para enseñar a los modelos de IA cómo interpretar y comprender la información visual. Consisten típicamente en entradas visuales crudas (imágenes, videos) emparejadas con anotaciones correspondientes, como cuadros delimitadores, máscaras de segmentación semántica o etiquetas de clasificación. Los datos de entrenamiento de alta calidad son la base del rendimiento del modelo, determinando directamente la precisión y robustez de una IA en aplicaciones del mundo real.

¿Cómo asegurar la calidad y precisión de los datos de entrenamiento?

Asegurar la calidad de los datos de entrenamiento implica procesos de anotación rigurosos, mecanismos de revisión en múltiples etapas y capacitación profesional para los anotadores. Los pasos clave incluyen establecer pautas de anotación claras, usar herramientas eficientes, realizar verificaciones de consistencia y evaluar regularmente los resultados de la anotación. La diversidad, representatividad y ausencia de sesgos en los datos también son cruciales para prevenir el sobreajuste o el sesgo del modelo, lo que lleva a sistemas de IA más confiables.

¿Cuáles son los principales tipos y métodos de anotación para los datos de entrenamiento?

Los tipos de datos de entrenamiento incluyen imágenes, videos y nubes de puntos. Los métodos de anotación comunes son la clasificación de imágenes (asignar una sola etiqueta a una imagen completa), la detección de objetos (dibujar cuadros delimitadores alrededor de los objetos), la segmentación semántica (enmascaramiento a nivel de píxel para categorías), la segmentación de instancias (enmascaramiento a nivel de píxel para instancias individuales), la detección de puntos clave (marcar puntos específicos como articulaciones) y el reconocimiento de actividad (anotar segmentos de tiempo en videos). La elección del método depende de la tarea específica de visión por computadora.

¿Qué papel juegan los datos sintéticos en el entrenamiento de la visión por computadora?

Los datos sintéticos, generados artificialmente a través de gráficos por computadora o Redes Generativas Antagónicas (GANs), juegan un papel crucial cuando los datos del mundo real son escasos, difíciles de adquirir o implican preocupaciones de privacidad. Pueden proporcionar un suministro ilimitado de muestras precisamente etiquetadas, ayudando a los modelos a aprender casos extremos y mejorar la generalización. Esto es particularmente valioso en campos como la conducción autónoma y la simulación robótica, donde se necesitan escenarios diversos y desafiantes para un entrenamiento robusto del modelo.

¿Cuál es la relación entre los datos de entrenamiento y los modelos preentrenados?

Los datos de entrenamiento son fundamentales para entrenar un modelo desde cero o para ajustar un modelo preentrenado. Los modelos preentrenados son modelos de IA que ya han sido entrenados en conjuntos de datos generales masivos (como ImageNet) y han aprendido características visuales universales. Al utilizar datos de entrenamiento específicos para la tarea para ajustar estos modelos preentrenados, los desarrolladores pueden acelerar significativamente el proceso de desarrollo y lograr un rendimiento superior con menos datos, aprovechando el conocimiento fundamental ya adquirido por el modelo preentrenado.