
ToolMage
Iniciar sesión

Best 1 Base de Datos Vectorial AI tools for Ciencia de Datos

Popular Base de Datos Vectorial AI tools in Ciencia de Datos include PostgresML, helping you work more efficiently.

PostgresML
Freemium

PostgresML

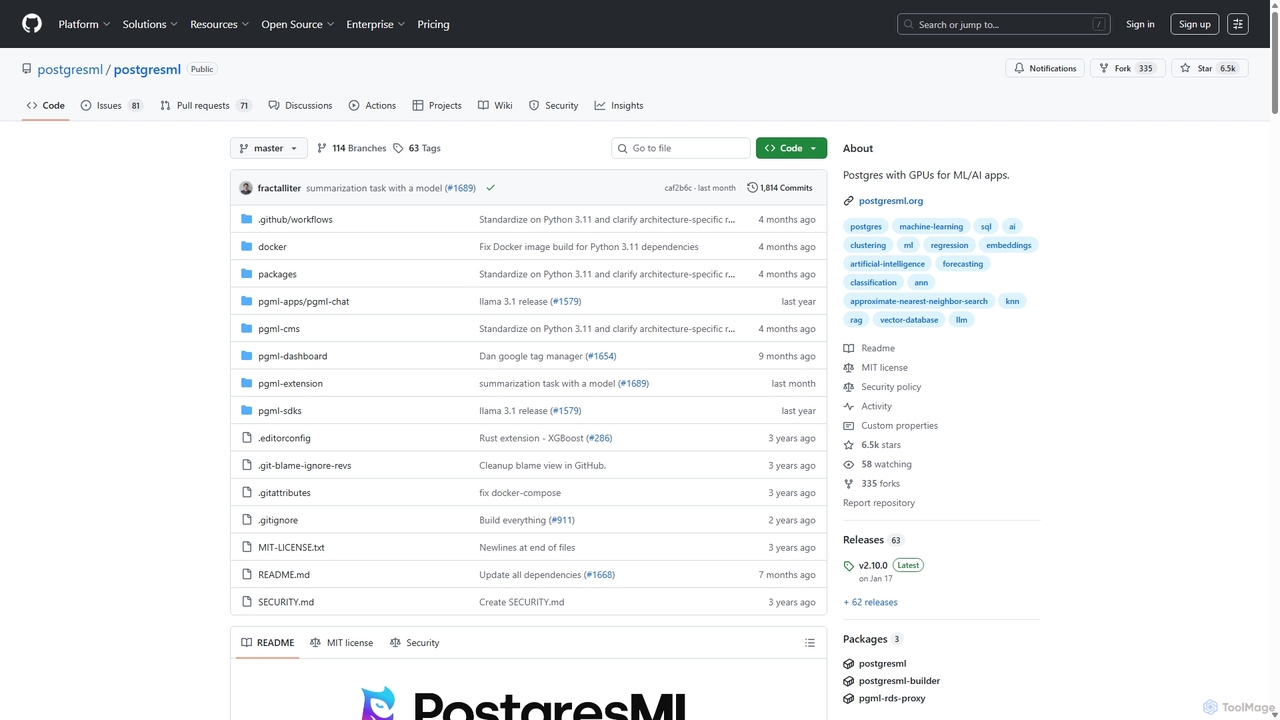
PostgresML es una potente extensión de código abierto que integra el aprendizaje automático y la IA directamente en su base de datos PostgreSQL. Permite la inferencia acelerada por GPU, la búsqueda vectorial y pipelines RAG completos utilizando simples comandos SQL, eliminando el movimiento de datos y simplificando la pila de MLOps para aplicaciones de IA escalables y de alto rendimiento.

MLOps
Visits 6.4KFavorites 137Likes 137

About Base de Datos Vectorial

Una Base de Datos Vectorial es una base de datos especializada diseñada para almacenar, gestionar y buscar eficientemente incrustaciones vectoriales de alta dimensión. A diferencia de las bases de datos tradicionales que consultan basándose en coincidencias exactas, las bases de datos vectoriales utilizan algoritmos de Vecino Más Próximo Aproximado (ANN) para encontrar elementos según su similitud semántica. Esto permite a las aplicaciones comprender el contexto y las relaciones en datos complejos y no estructurados como texto, imágenes y audio. Como componente clave en el stack de IA moderno, impulsan funciones avanzadas como la búsqueda semántica, los motores de recomendación y la memoria a largo plazo para los grandes modelos de lenguaje (LLM).

Características Principales

  • Almacenamiento de Vectores de Alta Dimensión: Maneja e indexa de forma nativa vectores con cientos o miles de dimensiones, que son salidas comunes de los modelos de IA.
  • Búsqueda de Vecino Más Próximo Aproximado (ANN): Proporciona una búsqueda de similitud ultrarrápida al encontrar los vectores 'más cercanos' en la base de datos, permitiendo un rendimiento en tiempo real en conjuntos de datos masivos.
  • Filtrado de Metadatos: Combina la búsqueda de similitud vectorial con el filtrado tradicional basado en atributos, permitiendo consultas complejas como "encontrar imágenes similares a esta, pero solo aquellas etiquetadas como 'exteriores'".
  • Escalabilidad y Rendimiento: Diseñada para el escalado horizontal para gestionar miles de millones de vectores manteniendo respuestas de consulta de baja latencia.
  • Indexación en Tiempo Real: Admite la adición continua de nuevos vectores de datos sin una degradación significativa del rendimiento o tiempo de inactividad.

Casos de Uso

Las bases de datos vectoriales son cruciales para desarrolladores y científicos de datos que construyen aplicaciones nativas de IA. Se utilizan ampliamente en el comercio electrónico para crear sistemas de recomendación de productos, en software empresarial para construir búsquedas inteligentes en bases de conocimiento y en aplicaciones de IA generativa para proporcionar memoria a largo plazo a los chatbots a través de la Generación Aumentada por Recuperación (RAG).

Cómo Elegir

Al seleccionar una base de datos vectorial, considere sus métricas de rendimiento, como la latencia de consulta y la velocidad de indexación. Evalúe el modelo de implementación: si necesita un servicio en la nube totalmente gestionado, una solución autoalojada o una opción sin servidor. Además, evalúe su ecosistema, incluidas las integraciones con marcos de IA populares como LangChain y LlamaIndex, y la flexibilidad de sus algoritmos ANN y capacidades de filtrado compatibles.

Base de Datos Vectorial use cases

1

Construcción de Búsqueda Semántica para Bases de Conocimiento

Un equipo de desarrollo de software necesita construir una función de búsqueda inteligente para su extensa documentación técnica. En lugar de depender de la coincidencia de palabras clave, que a menudo no encuentra artículos relevantes, utilizan una base de datos vectorial. Cada documento es convertido en una incrustación vectorial por un modelo de IA. Cuando un desarrollador busca una consulta como "cómo arreglar errores de autenticación", el sistema convierte la consulta en un vector y utiliza la búsqueda ANN de la base de datos para encontrar los vectores de documentos semánticamente más similares. Esto proporciona resultados muy relevantes, incluso si las palabras clave exactas no están presentes, reduciendo significativamente el tiempo de resolución de problemas.

2

Impulsando Recomendaciones de Productos en E-commerce

Un minorista de moda en línea quiere mejorar su función 'También te podría gustar'. Utilizan un modelo de IA multimodal para generar incrustaciones vectoriales para cada imagen de producto y su descripción. Estos vectores se almacenan en una base de datos vectorial. Cuando un cliente ve un producto, el sistema consulta la base de datos para encontrar productos con los vectores más similares. Esto permite recomendaciones basadas en el estilo visual, patrones de color y descripciones textuales (p. ej., 'vestido de verano'), creando una experiencia de compra más atractiva y personalizada que puede aumentar las tasas de conversión.

3

Creación de Memoria a Largo Plazo para Chatbots de IA

Una empresa implementa un chatbot de soporte al cliente con IA. Para garantizar que las conversaciones sean consistentes y personalizadas, utilizan una base de datos vectorial como la memoria a largo plazo del chatbot. La información clave de cada interacción del usuario (p. ej., preferencias del usuario, problemas pasados) se resume, se convierte en un vector y se almacena. Antes de responder a una nueva consulta, el chatbot busca en la base de datos vectorial interacciones pasadas relevantes. Este proceso, conocido como Generación Aumentada por Recuperación (RAG), permite al chatbot recordar el contexto, evitar hacer preguntas repetitivas y proporcionar un soporte más útil y consciente del contexto.

4

Implementación de Búsqueda Visual para Activos Multimedia

Una gran agencia de marketing gestiona una biblioteca de activos digitales con millones de imágenes y videos. Etiquetar manualmente cada activo es inviable. Al usar una base de datos vectorial, pueden implementar una potente función de búsqueda visual. Un modelo de IA procesa cada imagen y genera un vector que representa su contenido visual. Un diseñador puede luego subir una imagen (p. ej., una foto de una puesta de sol sobre una ciudad) para encontrar todos los activos visualmente similares en la biblioteca. Pueden refinar aún más la búsqueda con filtros de metadatos, como 'orientación horizontal' o 'contiene personas', agilizando el flujo de trabajo creativo y el proceso de descubrimiento de activos.

5

Detección de Anomalías en Transacciones Financieras

Una empresa de tecnología financiera tiene como objetivo detectar transacciones fraudulentas en tiempo real. Modelan cada transacción como un vector de alta dimensión que contiene características como el monto, la hora, la ubicación y el tipo de comerciante. Estos vectores se transmiten a una base de datos vectorial. El sistema identifica anomalías buscando vectores que están distantes de cualquier clúster establecido de patrones de transacciones normales. Cuando se encuentra que un nuevo vector de transacción es un valor atípico, se marca para su revisión inmediata por parte de un analista de fraudes. Este enfoque basado en la similitud puede descubrir nuevos patrones de fraude que los sistemas basados en reglas podrían pasar por alto.

6

Aceleración del Descubrimiento de Fármacos con Búsqueda Molecular

En la investigación farmacéutica, los científicos necesitan identificar moléculas con propiedades estructurales o funcionales similares. Representan vastas bibliotecas de compuestos químicos como incrustaciones vectoriales (p. ej., huellas dactilares moleculares). Un investigador puede entonces tomar una molécula objetivo, convertirla a su representación vectorial y consultar una base de datos vectorial para encontrar los k compuestos más similares de entre millones de candidatos. Esta búsqueda de similitud acelera drásticamente el proceso de selección inicial de nuevos candidatos a fármacos, ayudando a los investigadores a centrar sus esfuerzos en las moléculas más prometedoras y reduciendo el tiempo de desarrollo.

Base de Datos Vectorial FAQ

¿Qué es una base de datos vectorial?

Una base de datos vectorial es un tipo de base de datos diseñada específicamente para almacenar y consultar vectores de alta dimensión, también conocidos como incrustaciones (embeddings). En lugar de buscar coincidencias exactas como una base de datos tradicional, se especializa en encontrar los elementos más similares basándose en la distancia matemática entre sus vectores. Esta capacidad es fundamental para aplicaciones de IA como la búsqueda semántica, los sistemas de recomendación y la habilitación de memoria a largo plazo para grandes modelos de lenguaje (LLM) a través de la Generación Aumentada por Recuperación (RAG).

¿En qué se diferencia una base de datos vectorial de una base de datos relacional tradicional (p. ej., SQL)?

La diferencia principal radica en el tipo de datos y el método de consulta. Una base de datos relacional tradicional almacena datos estructurados (como texto, números, fechas) en tablas y utiliza SQL para encontrar coincidencias exactas basadas en valores específicos. En cambio, una base de datos vectorial almacena datos no estructurados representados como vectores numéricos y utiliza algoritmos de Vecino Más Próximo Aproximado (ANN) para encontrar datos que son semánticamente 'similares' o 'cercanos' a un vector de consulta. Las bases de datos SQL son para consultas estructuradas e integridad de datos, mientras que las bases de datos vectoriales son para la búsqueda de similitud en datos complejos.

¿Cuáles son las características clave a buscar al elegir una base de datos vectorial?

Al seleccionar una base de datos vectorial, considere estos factores críticos:

  • Rendimiento: Evalúe la latencia de la consulta (qué tan rápido devuelve los resultados) y la velocidad de indexación (qué tan rápido puede agregar nuevos datos).
  • Escalabilidad: Evalúe su capacidad para manejar el volumen de datos esperado (miles de millones de vectores) y la carga de consultas sin degradación del rendimiento.
  • Modelo de implementación: Elija entre un servicio en la nube totalmente gestionado para facilitar el uso, una opción autoalojada para un control máximo o un modelo sin servidor para un escalado flexible.
  • Filtrado y búsqueda híbrida: Verifique si tiene capacidades robustas de filtrado de metadatos para combinar la búsqueda de similitud con consultas estructuradas.
  • Ecosistema e integraciones: Asegúrese de que se integre bien con su pila tecnológica existente, incluidos los marcos de IA como LangChain o LlamaIndex y las plataformas en la nube.
¿Quién usa las bases de datos vectoriales?

Las bases de datos vectoriales son utilizadas principalmente por ingenieros de IA/ML, científicos de datos y desarrolladores de software que están construyendo aplicaciones con características impulsadas por IA. Por ejemplo, un equipo que desarrolla un chatbot de IA generativa usaría una base de datos vectorial para su memoria (RAG). El equipo de ciencia de datos de una empresa de comercio electrónico la usaría para construir un motor de recomendaciones. Una empresa de software la usaría para potenciar una función de búsqueda semántica en la documentación de ayuda de su producto. Esencialmente, cualquier persona que trabaje con incrustaciones de modelos de IA para habilitar funcionalidades basadas en la similitud es un usuario potencial.

¿Qué es una 'incrustación' (embedding) en el contexto de una base de datos vectorial?

Una 'incrustación' (embedding) es una representación numérica de datos complejos, como una palabra, una oración, una imagen o un clip de audio, en forma de un vector de alta dimensión (una lista de números). Estas incrustaciones son generadas por modelos de IA (como grandes modelos de lenguaje o modelos de visión por computadora) y están diseñadas para capturar el significado semántico o las características de los datos originales. La idea clave es que los elementos similares tendrán incrustaciones que están cerca unas de otras en el espacio vectorial. El trabajo principal de una base de datos vectorial es almacenar estas incrustaciones y encontrar las más cercanas muy rápidamente.