ToolMage
Iniciar sesión

Best 2 Extracción de Datos AI tools for Herramientas para Desarrolladores

Popular Extracción de Datos AI tools in Herramientas para Desarrolladores include Thordata y GetOData, helping you work more efficiently.

Thordata
Freemium

Thordata

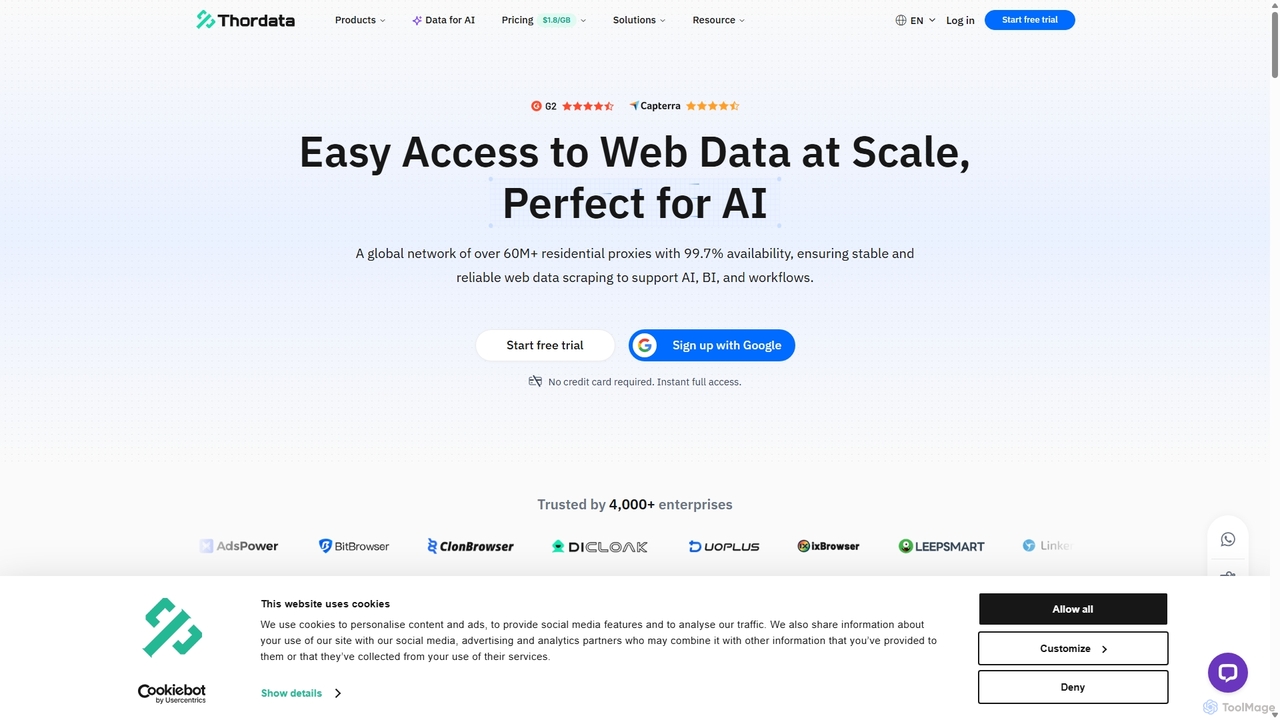
Thordata es un proveedor de servicios de proxy de alto rendimiento diseñado para el web scraping a gran escala y aplicaciones de IA. Ofrece una red global de más de 60 millones de proxies residenciales, móviles, de ISP y de centro de datos con alta disponibilidad y baja latencia. Thordata también proporciona potentes APIs de scraping y un mercado de datos para simplificar la adquisición de datos para tareas como el entrenamiento de modelos de IA, el monitoreo de comercio electrónico, el análisis SEO y la protección de marca, garantizando un acceso fiable y escalable a los datos web públicos.

Recopilación de Datos
Visits 333.1KFavorites 135Likes 148
GetOData
Freemium

GetOData

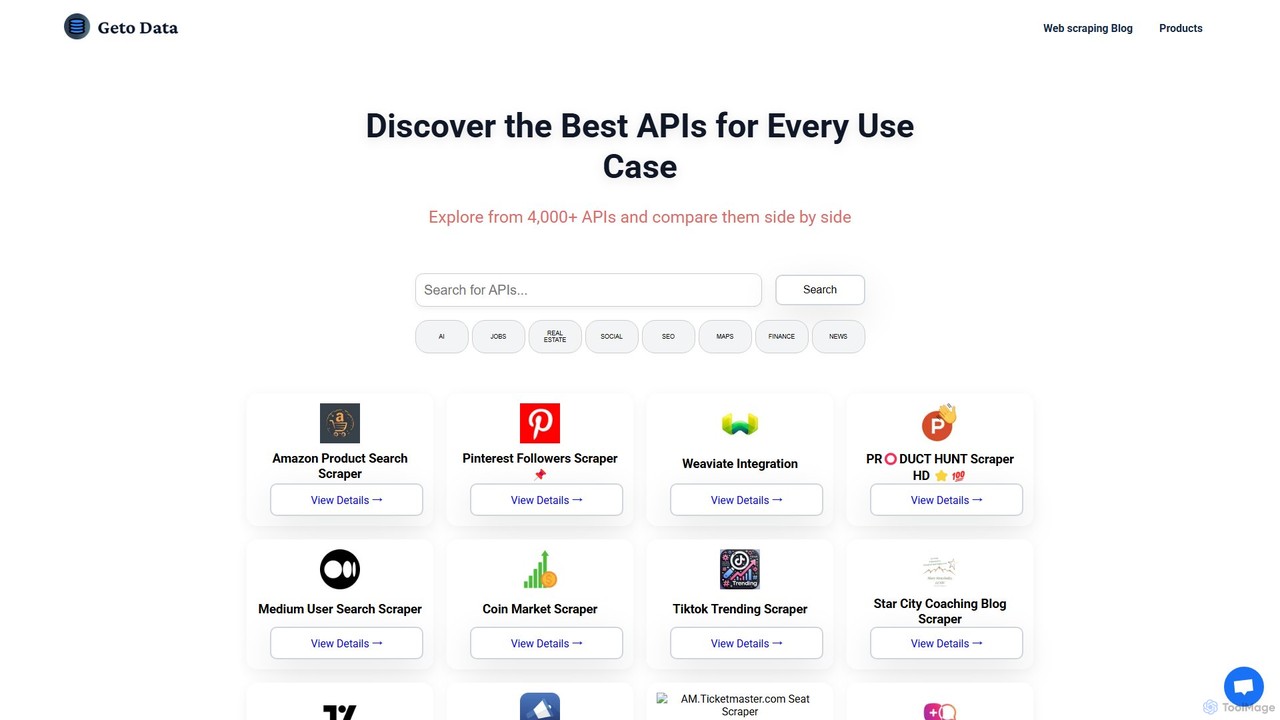
Un directorio completo para descubrir, comparar y utilizar más de 4,000 API preconstruidas y raspadores web sin código. Extraiga datos estructurados de sitios web para investigación de mercado, generación de leads y automatización de procesos sin escribir ningún código.

Análisis
Visits 6.8KFavorites 149Likes 126

About Extracción de Datos

Las herramientas de Extracción de Datos (Data Scraping) son una clase de software diseñado para extraer automáticamente grandes cantidades de datos de sitios web. Funcionan analizando la estructura HTML de las páginas web para identificar y recopilar información específica, como texto, imágenes, precios o detalles de contacto. Esto permite a las empresas y desarrolladores recopilar inteligencia de mercado, monitorear a la competencia y realizar investigaciones sin la tediosa entrada manual de datos. Los modernos scrapers impulsados por IA pueden manejar sitios complejos con mucho JavaScript, gestionar proxies y eludir muchas medidas anti-bot, haciendo la recopilación de datos más fiable y eficiente.

Características Principales

  • Extracción Automatizada de Datos: Rastrea automáticamente sitios web y extrae puntos de datos predefinidos de la estructura de la página.
  • Mecanismos Anti-Bloqueo: Utiliza proxies rotativos, simulación de user-agent y resolución de CAPTCHA para evitar la detección y el bloqueo de IP.
  • Estructuración y Exportación de Datos: Convierte datos web no estructurados en formatos estructurados como JSON, CSV o Excel para su análisis.
  • Scraping Programado: Permite a los usuarios configurar tareas de scraping recurrentes para monitorear los cambios de datos a lo largo del tiempo.
  • Herramientas de Selección Visual: Proporciona una interfaz sin código para que los usuarios hagan clic y seleccionen los datos que desean extraer directamente de una página web.

Casos de Uso

Las herramientas de Extracción de Datos se utilizan ampliamente en diversas industrias. En el comercio electrónico, son esenciales para el monitoreo de precios y el análisis de la competencia. Los equipos de ventas y marketing las utilizan para la generación de leads extrayendo información de contacto de directorios. Los investigadores de mercado y analistas de datos confían en ellas para recopilar grandes conjuntos de datos para análisis de tendencias, análisis de sentimientos y estudios académicos.

Cómo Elegir

Al seleccionar una herramienta de Extracción de Datos, considere su nivel de habilidad técnica; los scrapers visuales sin código son ideales para no desarrolladores, mientras que las bibliotecas y APIs ofrecen más flexibilidad para los programadores. Evalúe la escalabilidad de la herramienta y su capacidad para manejar sitios web complejos y dinámicos. Además, verifique sus capacidades anti-bloqueo, los formatos de exportación de datos disponibles y su modelo de precios, que a menudo se basa en el volumen de datos extraídos.

Extracción de Datos use cases

1

Monitoreo de Precios en Comercio Electrónico

Un gerente de comercio electrónico necesita mantener precios competitivos. Utiliza una herramienta de extracción de datos para rastrear automáticamente los precios, niveles de stock y promociones de productos clave en docenas de sitios web de la competencia diariamente. La herramienta se programa para ejecutarse cada pocas horas y los datos extraídos se exportan a un archivo CSV. Estos datos se importan luego a un panel de control, lo que permite al equipo de precios realizar ajustes dinámicos e informados a sus propios precios, maximizando las ventas y los márgenes de beneficio sin verificaciones manuales.

2

Generación de Leads para Equipos de Ventas

Un equipo de ventas B2B necesita construir una lista específica de clientes potenciales. Utilizan una herramienta de extracción de datos para extraer nombres de empresas, cargos y información de contacto de directorios de negocios en línea y sitios de redes profesionales basándose en criterios específicos como industria, tamaño de la empresa y ubicación. El scraper se ejecuta durante la noche y compila la información en una hoja de cálculo estructurada. Este proceso automatizado proporciona al equipo de ventas una lista fresca y relevante de leads cada mañana, ahorrando cientos de horas de investigación manual.

3

Investigación de Mercado y Análisis de Tendencias

Un analista de mercado tiene la tarea de comprender el sentimiento del público sobre una nueva categoría de productos electrónicos de consumo. Configura un scraper de datos para recopilar miles de reseñas y calificaciones de clientes de los principales sitios web de venta y reseñas. La herramienta extrae el texto de la reseña, la calificación por estrellas y la fecha. Estos datos brutos se introducen luego en una herramienta de análisis de sentimientos para identificar elogios, quejas y solicitudes de características comunes, proporcionando al analista información cuantitativa sobre las tendencias del mercado y las necesidades de los consumidores.

4

Agregación de Datos del Mercado Inmobiliario

Una agencia inmobiliaria quiere crear una base de datos interna completa de listados de propiedades locales. En lugar de visitar manualmente múltiples portales inmobiliarios, implementan una herramienta de extracción de datos. El scraper está configurado para extraer detalles clave de cada listado, incluyendo precio, dirección, número de dormitorios/baños, superficie y información de contacto del agente. Estos datos agregados permiten a sus agentes buscar y comparar rápidamente propiedades de todo el mercado, brindando un mejor servicio a sus clientes.

5

Recopilación de Datos para Investigación Académica

Un sociólogo está estudiando los patrones del discurso en línea. Necesita un gran conjunto de datos de comentarios públicos de secciones de comentarios de artículos de noticias y foros públicos. Usando una herramienta de extracción de datos, el investigador especifica los sitios web objetivo y los elementos HTML que contienen los comentarios. La herramienta luego rastrea sistemáticamente miles de páginas, extrayendo el texto de cada comentario, su marca de tiempo y cualquier metadato asociado. Este proceso de recopilación automatizado proporciona un rico conjunto de datos para análisis cualitativo y cuantitativo, que sería imposible de reunir manualmente.

6

Agregación de Noticias y Contenido

Una startup de medios quiere construir una plataforma de agregación de noticias. Utilizan una herramienta de extracción de datos para monitorear cientos de fuentes de noticias en tiempo real. El scraper está configurado para extraer el titular, el autor, la fecha de publicación y un fragmento de resumen de cada nuevo artículo a medida que se publica. Estos datos se categorizan y muestran automáticamente en su plataforma, proporcionando a los usuarios una vista completa y actualizada de las noticias sobre diversos temas sin necesidad de construir integraciones de API individuales para cada fuente.

Extracción de Datos FAQ

¿Qué son las herramientas de Extracción de Datos con IA?

Las herramientas de Extracción de Datos con IA son aplicaciones avanzadas que automatizan la extracción de datos de sitios web. A diferencia de los scrapers tradicionales que se basan en reglas fijas, las herramientas impulsadas por IA pueden comprender inteligentemente la estructura de una página web, identificar datos relevantes incluso si el diseño cambia, manejar contenido dinámico cargado con JavaScript y resolver CAPTCHAs complejos. Esto las hace más resilientes, eficientes y capaces de extraer datos de sitios web modernos y complejos donde los scrapers básicos fallarían.

¿Cuál es la diferencia entre la Extracción de Datos y el uso de una API?

La diferencia clave radica en el método de acceso a los datos. Una API (Interfaz de Programación de Aplicaciones) es un canal oficial y estructurado proporcionado por el propietario de un sitio web para que los desarrolladores accedan a datos específicos en un formato limpio y predecible. La Extracción de Datos, por otro lado, extrae datos directamente del código HTML de una página web, que está destinado a la visualización humana.

  • APIs: Más estables, fiables y oficialmente sancionadas, pero a menudo proporcionan campos de datos limitados y pueden tener límites de uso o costos.
  • Extracción de Datos: Más flexible ya que puede acceder a cualquier dato visible en una página, pero es más frágil y puede romperse si cambia el diseño del sitio web.

¿Es legal la Extracción de Datos?

La legalidad de la extracción de datos es compleja y varía según la jurisdicción y las circunstancias específicas. Generalmente, extraer datos disponibles públicamente que no están protegidos por derechos de autor o leyes de privacidad personal se considera legal. Sin embargo, puede violar los Términos de Servicio de un sitio web. Es crucial actuar de manera ética:

  • No extraer datos personales o con derechos de autor.
  • Respetar el archivo `robots.txt` del sitio web, que indica qué páginas no deben ser rastreadas.
  • Asegurarse de que sus actividades de extracción no sobrecarguen los servidores del sitio web.
En caso de duda, se recomienda consultar con un profesional legal.

¿Cómo elegir la herramienta de Extracción de Datos adecuada?

Seleccionar la mejor herramienta depende de sus necesidades específicas. Considere estos factores:

  • Facilidad de uso: ¿Necesita una interfaz visual sin código o se siente cómodo escribiendo código con una biblioteca como BeautifulSoup de Python o un framework como Scrapy?
  • Complejidad del sitio web objetivo: ¿Puede la herramienta manejar sitios web dinámicos con mucho JavaScript o es solo para páginas HTML estáticas y simples?
  • Escalabilidad: ¿Necesita extraer miles de páginas simultáneamente? Busque herramientas con infraestructura basada en la nube y una gestión de proxies robusta.
  • Funciones anti-bloqueo: Verifique el soporte integrado para proxies rotativos, simulación de user-agent y servicios de resolución de CAPTCHA.
  • Salida de datos: Asegúrese de que la herramienta pueda exportar datos en el formato que necesita, como CSV, JSON, o directamente a una base de datos o API.

¿Cuáles son los principales desafíos en la Extracción de Datos?

La extracción de datos implica varios obstáculos técnicos. Los desafíos más comunes incluyen:

  • Ser bloqueado: Los sitios web intentan activamente bloquear los scrapers utilizando técnicas como la limitación de velocidad de IP, CAPTCHAs y huellas dactilares del navegador.
  • Contenido dinámico: Muchos sitios web modernos utilizan JavaScript para cargar datos de forma asíncrona. Un scraper debe ser capaz de renderizar la página como un navegador para acceder a este contenido.
  • Cambios en la estructura del sitio web: Los scrapers a menudo se construyen para apuntar a estructuras HTML específicas. Si un sitio web rediseña su diseño, el scraper puede romperse y necesitará ser actualizado.
  • Limpieza de datos: Los datos brutos extraídos suelen ser desordenados y no estructurados. Requiere una limpieza y un procesamiento significativos para ser útil para el análisis.