
ToolMage
Iniciar sesión

Best 1 Bibliotecas de Aprendizaje Automático AI tools for Herramientas para Desarrolladores

Popular Bibliotecas de Aprendizaje Automático AI tools in Herramientas para Desarrolladores include Cleora, helping you work more efficiently.

Cleora
Free

Cleora

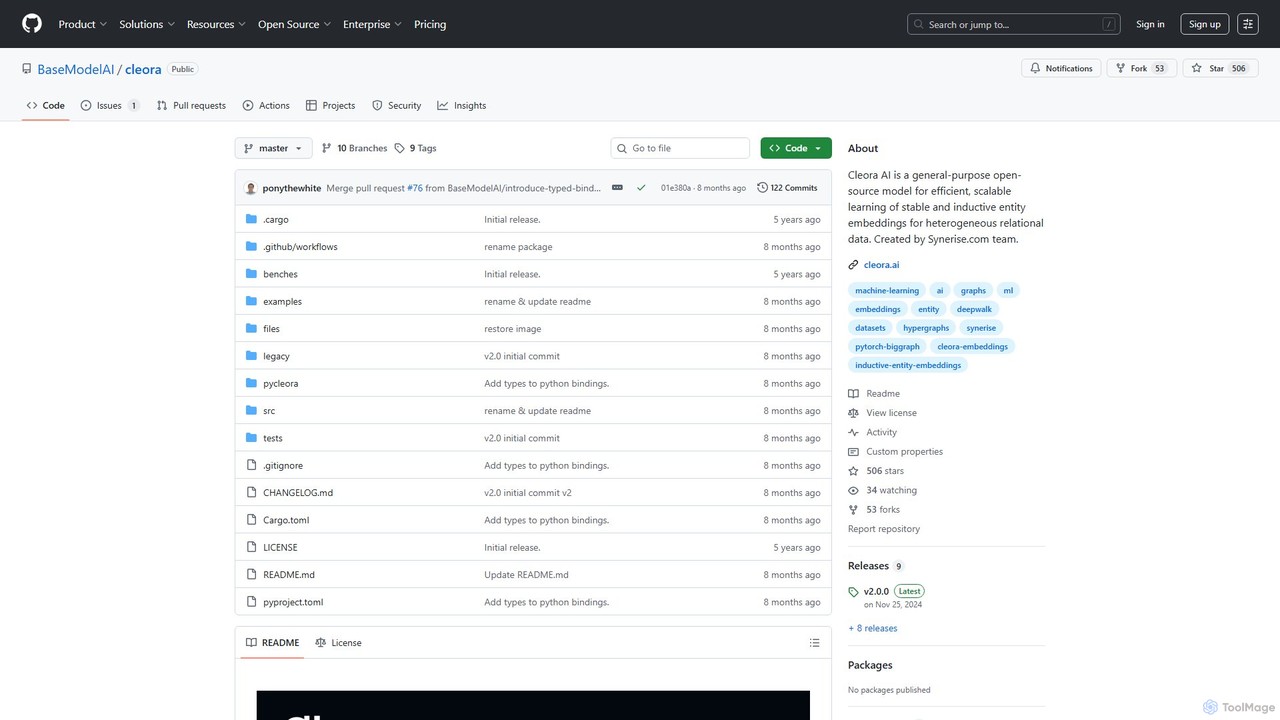
Cleora es un modelo de código abierto y alto rendimiento para crear embeddings de entidades estables e inductivos a partir de datos relacionales heterogéneos e hipergrafos a gran escala. Escrito en Rust con una API de Python, ofrece una velocidad y escalabilidad inigualables para tareas como sistemas de recomendación y análisis de grafos.

Modelos de Embedding
Visits 58.6KFavorites 110Likes 110

About Bibliotecas de Aprendizaje Automático

Las Bibliotecas de Aprendizaje Automático son colecciones especializadas de código preescrito, algoritmos y herramientas diseñadas para simplificar y acelerar el desarrollo de modelos de aprendizaje automático. Como componente crucial dentro de las Herramientas para Desarrolladores, estas bibliotecas abstraen operaciones matemáticas complejas, proporcionando APIs de alto nivel que permiten a los científicos de datos y desarrolladores construir, entrenar y desplegar aplicaciones impulsadas por IA de manera eficiente. Empoderan a los usuarios para centrarse en los datos y la arquitectura del modelo en lugar de los detalles de implementación de bajo nivel, acelerando significativamente el flujo de trabajo de aprendizaje automático.

Características Principales

  • Implementaciones de Algoritmos: Algoritmos preconstruidos para clasificación, regresión, agrupamiento y más, listos para su uso inmediato.
  • Herramientas de Preprocesamiento de Datos: Funciones para limpiar, transformar y preparar datos brutos para el entrenamiento del modelo.
  • Métricas de Evaluación de Modelos: Métricas y herramientas estandarizadas para evaluar el rendimiento del modelo e identificar áreas de mejora.
  • Marcos de Aprendizaje Profundo: Módulos especializados para construir y entrenar redes neuronales, incluyendo arquitecturas convolucionales y recurrentes.
  • Persistencia del Modelo: Capacidades para guardar y cargar modelos entrenados para uso futuro o despliegue.

Escenarios de Aplicación

Las Bibliotecas de Aprendizaje Automático son indispensables en varios dominios. Los científicos de datos las aprovechan para análisis predictivos en finanzas y atención médica, mientras que los ingenieros de software las integran en aplicaciones para sistemas de recomendación o procesamiento de lenguaje natural. Los investigadores también utilizan estas bibliotecas para el prototipado rápido y la experimentación con nuevos modelos de IA.

Cómo Elegir

Seleccionar la Biblioteca de Aprendizaje Automático adecuada implica considerar varios factores: el tipo específico de tarea de ML (por ejemplo, aprendizaje profundo, ML tradicional), el lenguaje de programación requerido, el soporte de la comunidad y la documentación, las necesidades de rendimiento y la facilidad de integración con los sistemas existentes. Evalúe el diseño de la API de la biblioteca y la escalabilidad para el crecimiento futuro de su proyecto.

Bibliotecas de Aprendizaje Automático use cases

1

Construcción de Sistemas de Análisis Predictivo

Los científicos de datos utilizan bibliotecas de aprendizaje automático para desarrollar modelos predictivos robustos para diversas necesidades empresariales. Por ejemplo, en finanzas, pueden construir modelos para pronosticar precios de acciones o detectar transacciones fraudulentas entrenando algoritmos con datos históricos, lo que permite una toma de decisiones proactiva y la mitigación de riesgos.

2

Desarrollo de Motores de Recomendación

Las plataformas de comercio electrónico y los servicios de streaming emplean bibliotecas de ML para crear motores de recomendación personalizados. Los desarrolladores entrenan modelos de filtrado colaborativo o basados en contenido sobre el comportamiento del usuario y los atributos de los artículos para sugerir productos, películas o música relevantes, mejorando significativamente la participación del usuario y las ventas.

3

Implementación de Soluciones de Procesamiento de Lenguaje Natural (PLN)

Los ingenieros de IA y lingüistas utilizan bibliotecas para construir aplicaciones sofisticadas de PLN. Esto incluye el desarrollo de herramientas de análisis de sentimientos para la retroalimentación de clientes, chatbots para soporte automatizado o sistemas de resumen de texto, lo que permite a las empresas procesar y comprender grandes cantidades de datos textuales de manera eficiente.

4

Entrenamiento de Modelos de Visión por Computadora

Investigadores y desarrolladores en campos como la conducción autónoma o la imagen médica aprovechan las bibliotecas de aprendizaje profundo para entrenar modelos de visión por computadora. Pueden construir sistemas de detección de objetos para identificar vehículos en carreteras o modelos de clasificación de imágenes para diagnosticar enfermedades a partir de escaneos, empujando los límites de la IA visual.

5

Automatización de Flujos de Trabajo de Preprocesamiento de Datos

Los ingenieros y analistas de datos utilizan con frecuencia las bibliotecas de ML para automatizar tareas complejas de limpieza, transformación y ingeniería de características de datos. Esto agiliza la preparación de conjuntos de datos brutos para el entrenamiento de modelos, asegurando la calidad y consistencia de los datos, lo cual es crítico para resultados precisos de aprendizaje automático.

6

Prototipado Rápido e Investigación

Los investigadores y académicos de aprendizaje automático confían en estas bibliotecas para prototipar y experimentar rápidamente con nuevos algoritmos y arquitecturas de modelos. Las APIs de alto nivel y las amplias funcionalidades permiten una rápida iteración y prueba de hipótesis, acelerando la innovación en el dominio de la IA.

Bibliotecas de Aprendizaje Automático FAQ

¿Qué son las Bibliotecas de Aprendizaje Automático?

Las Bibliotecas de Aprendizaje Automático son colecciones de código, funciones y algoritmos preescritos que simplifican el proceso de construcción, entrenamiento y despliegue de modelos de aprendizaje automático. Proporcionan abstracciones de alto nivel para operaciones matemáticas complejas, permitiendo a los desarrolladores y científicos de datos centrarse en el diseño del modelo y los datos en lugar de la implementación de bajo nivel. Sus características clave incluyen un amplio soporte de algoritmos, herramientas de preprocesamiento de datos y capacidades de evaluación de modelos.

¿Cómo elijo la Biblioteca de Aprendizaje Automático adecuada para mi proyecto?

Elegir la biblioteca adecuada depende de varios factores. Considere la tarea específica de ML (por ejemplo, aprendizaje profundo, clasificación tradicional), el lenguaje de programación que prefiera (Python es dominante), el tamaño y la complejidad de sus datos, y el rendimiento requerido. Evalúe el soporte de la comunidad, la calidad de la documentación y la facilidad de integración con su pila tecnológica existente. Las opciones populares incluyen Scikit-learn para ML tradicional y TensorFlow/PyTorch para aprendizaje profundo.

¿Cuáles son los principales tipos de Bibliotecas de Aprendizaje Automático?

Las Bibliotecas de Aprendizaje Automático se pueden clasificar ampliamente en bibliotecas de ML tradicional y marcos de aprendizaje profundo. Las bibliotecas de ML tradicional (como Scikit-learn) ofrecen una amplia gama de algoritmos para clasificación, regresión, agrupamiento y reducción de dimensionalidad. Los marcos de aprendizaje profundo (como TensorFlow y PyTorch) están diseñados específicamente para construir y entrenar redes neuronales, destacando en tareas como la visión por computadora y el procesamiento del lenguaje natural debido a su soporte optimizado para GPU y capacidades de diferenciación automática.

¿Quién utiliza las Bibliotecas de Aprendizaje Automático y con qué fines?

Las Bibliotecas de Aprendizaje Automático son utilizadas principalmente por científicos de datos, ingenieros de aprendizaje automático, investigadores de IA y desarrolladores de software. Los científicos de datos las emplean para el modelado predictivo y el análisis de datos. Los ingenieros las integran en aplicaciones para funciones como sistemas de recomendación o detección de fraudes. Los investigadores las aprovechan para experimentar con nuevos algoritmos y avanzar en las capacidades de la IA. Esencialmente, cualquiera involucrado en la construcción o despliegue de soluciones impulsadas por IA se beneficia de estas herramientas.

¿Cuáles son los beneficios de usar Bibliotecas de Aprendizaje Automático en comparación con construir modelos desde cero?

El uso de Bibliotecas de Aprendizaje Automático ofrece ventajas significativas en comparación con la construcción de modelos desde cero. Ahorran una inmensa cantidad de tiempo de desarrollo al proporcionar algoritmos y funciones preoptimizados y probados. Las bibliotecas reducen la probabilidad de errores, aseguran un rendimiento consistente y a menudo vienen con una extensa documentación y soporte comunitario. Esto permite a los desarrolladores centrarse en la resolución de problemas de nivel superior y la innovación, en lugar de reinventar componentes matemáticos y algorítmicos fundamentales.