
ToolMage
Iniciar sesión

Best 1 Serverless AI tools for Desarrollo

Popular Serverless AI tools in Desarrollo include Trigger.dev, helping you work more efficiently.

Trigger.dev
Freemium

Trigger.dev

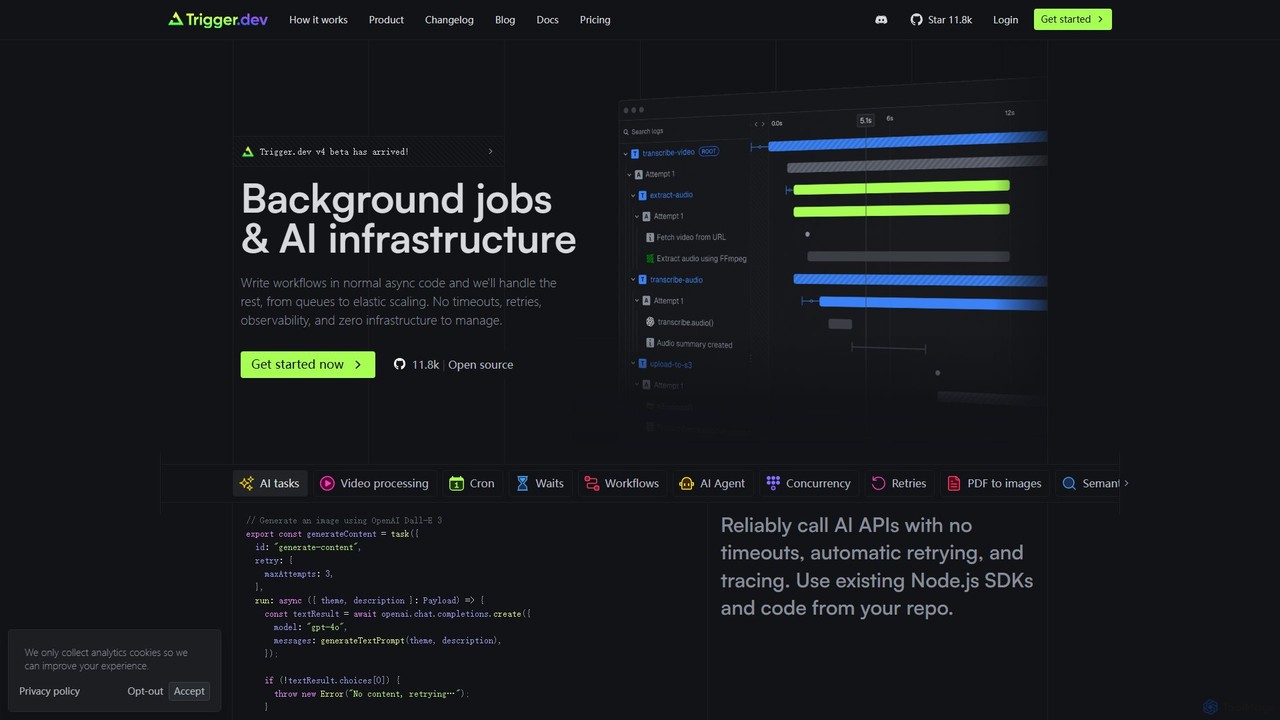
Trigger.dev es una plataforma de código abierto para que los desarrolladores construyan, ejecuten y gestionen trabajos en segundo plano de larga duración y flujos de trabajo de IA. Proporciona una infraestructura robusta que maneja tiempos de espera, reintentos y escalado, permitiéndole escribir tareas resilientes directamente en su base de código de TypeScript o Python. Ideal para orquestar agentes de IA complejos, pipelines de procesamiento de datos y aplicaciones en tiempo real sin gestionar servidores.

Orquestación de Modelos
Visits 255.1KFavorites 111Likes 101

About Serverless

Las plataformas Serverless son un modelo de ejecución de computación en la nube que permite a los desarrolladores construir y ejecutar aplicaciones sin gestionar la infraestructura de servidores subyacente. Estas herramientas operan sobre una base orientada a eventos, ejecutando código en respuesta a disparadores específicos y escalando automáticamente los recursos para ajustarse precisamente a la demanda. Este enfoque permite a los equipos de desarrollo centrarse exclusivamente en escribir la lógica de la aplicación, acelerando significativamente el tiempo de lanzamiento al mercado y reduciendo la sobrecarga operativa. Un beneficio clave es el modelo de precios de pago por uso, donde los costos se incurren solo por el tiempo de cómputo real consumido, eliminando gastos por recursos inactivos.

Características Clave

  • Ejecución Orientada a Eventos: Las funciones se activan por eventos como solicitudes HTTP, actualizaciones de bases de datos o cargas de archivos, permitiendo arquitecturas reactivas.
  • Escalado Automático: La plataforma gestiona automáticamente el escalado desde cero hasta miles de solicitudes concurrentes sin intervención manual.
  • Abstracción de Infraestructura: Libera a los desarrolladores del aprovisionamiento de servidores, la aplicación de parches de software y el mantenimiento del sistema operativo.
  • Facturación de Pago por Uso: Los costos se calculan en función del número de ejecuciones y la duración precisa del tiempo de cómputo, optimizando el gasto.
  • Funciones sin Estado (Stateless): Las funciones suelen diseñarse para no tener estado, lo que simplifica el escalado y promueve una arquitectura de aplicación limpia y desacoplada.

Casos de Uso

Serverless es altamente efectivo para construir backends de API para aplicaciones web y móviles, crear pipelines de procesamiento de datos en tiempo real e implementar arquitecturas de microservicios. Es ampliamente adoptado por startups para la creación rápida de prototipos debido a su bajo costo inicial, y por grandes empresas para manejar cargas de trabajo asíncronas y orientadas a eventos como el procesamiento de imágenes o la ingesta de datos de IoT.

Cómo Elegir

Al seleccionar una herramienta Serverless, considere el ecosistema del proveedor y su integración con otros servicios como bases de datos y almacenamiento. Evalúe los lenguajes de programación y los entornos de ejecución compatibles para garantizar la compatibilidad con su pila tecnológica. Analice las características de rendimiento, en particular la latencia de 'arranque en frío' para aplicaciones sensibles al tiempo. Finalmente, revise las capacidades de monitoreo, registro y depuración de la plataforma para garantizar la visibilidad operativa.

Serverless use cases

1

Construcción de Backends de API Escalables

Un desarrollador de backend que crea una nueva aplicación móvil necesita una API que pueda manejar un tráfico impredecible, desde unos pocos usuarios en el lanzamiento hasta potencialmente millones. En lugar de aprovisionar y gestionar servidores, utiliza una plataforma sin servidor como AWS Lambda. Cada punto final de la API (por ejemplo, inicio de sesión de usuario, recuperación de datos) se implementa como una función separada. Cuando un usuario interactúa con la aplicación, se activa la función correspondiente. La plataforma escala automáticamente el número de instancias de la función para manejar la carga, asegurando tiempos de respuesta rápidos. Este enfoque es muy rentable, ya que solo pagan por el tiempo de cómputo utilizado, lo que lo hace ideal para startups y proyectos con demanda fluctuante.

2

Pipelines de Procesamiento de Datos en Tiempo Real

Un ingeniero de datos de una empresa de IoT necesita procesar un flujo continuo de datos de sensores. Configura una función sin servidor que se activa cada vez que llegan nuevos datos a una cola de mensajes como AWS Kinesis. La función lee el paquete de datos entrante, realiza la validación y transformación, y luego almacena la información procesada en una base de datos de series temporales para su análisis. Este pipeline sin servidor escala automáticamente con el volumen de datos, manejando miles de eventos por segundo durante las horas pico sin ninguna intervención manual. La empresa evita el costo y la complejidad de mantener una flota de servidores para la ingesta de datos, pagando solo por los milisegundos de ejecución de cada punto de datos.

3

Procesamiento Automatizado de Imágenes y Vídeos

Una plataforma de redes sociales necesita generar automáticamente miniaturas y transcodificar vídeos cada vez que un usuario sube un archivo. Un desarrollador configura una función sin servidor para que se active en un evento de carga de archivos en un bucket de almacenamiento como Amazon S3. Cuando se sube un nuevo vídeo, se invoca la función. Utiliza una biblioteca de procesamiento de medios para crear múltiples versiones del vídeo en diferentes resoluciones y genera una imagen en miniatura. Los archivos resultantes se guardan de nuevo en el bucket de almacenamiento. Esto automatiza una tarea intensiva en recursos de manera eficiente, ya que los recursos de cómputo solo se asignan y pagan durante el tiempo de procesamiento real, que puede ser de unos pocos segundos o minutos por archivo.

4

Tareas Programadas y Trabajos Cron

Un ingeniero de DevOps necesita ejecutar un script nocturno que limpia archivos temporales de una base de datos y genera un informe de resumen. En lugar de mantener un servidor dedicado solo para ejecutar trabajos cron, crea una función sin servidor con la lógica del script. Luego, utiliza un servicio de programación como Amazon EventBridge para activar esta función todos los días a las 3 AM. La función se ejecuta, realiza sus tareas de limpieza e informes, y luego se apaga. Este enfoque es más fiable y rentable que un servidor cron tradicional, ya que el proveedor de la nube gestiona el entorno de ejecución y la facturación se limita a los pocos minutos que el script se ejecuta realmente cada día.

5

Potenciando Chatbots y Asistentes de Voz

Un desarrollador de IA conversacional está construyendo el backend para un chatbot de servicio al cliente. Utiliza una arquitectura sin servidor donde cada mensaje del usuario desencadena una solicitud HTTP a una puerta de enlace de API, que a su vez invoca una función sin servidor. Esta función procesa la entrada de lenguaje natural del usuario, interactúa con otros servicios (como una base de conocimientos o un CRM) para encontrar una respuesta y luego devuelve una respuesta. La naturaleza sin estado de las funciones sin servidor se adapta perfectamente al ciclo de solicitud-respuesta de un chatbot. La arquitectura puede manejar sin esfuerzo miles de conversaciones concurrentes, escalando bajo demanda sin ninguna degradación del rendimiento ni necesidad de planificación de capacidad.

6

Lógica de Autenticación de Aplicaciones Web

Un ingeniero de seguridad está implementando un proceso de registro de usuario personalizado para una aplicación web utilizando un servicio como AWS Cognito. Necesita validar el correo electrónico de un usuario contra un servicio de terceros antes de completar el registro. Escribe una función sin servidor que contiene esta lógica de validación. Esta función se configura como un 'hook' previo al registro en Cognito. Cuando un nuevo usuario intenta registrarse, Cognito activa automáticamente la función, pasándole los detalles del usuario. La función realiza la validación y devuelve una respuesta de éxito o fracaso a Cognito, que luego procede o deniega el registro. Esto desacopla la lógica de seguridad personalizada de la aplicación principal y la ejecuta en un entorno seguro y aislado.

Serverless FAQ

¿Qué es la computación Serverless (sin servidor)?

La computación sin servidor (Serverless) es un modelo de ejecución en la nube donde los desarrolladores pueden ejecutar código sin aprovisionar ni gestionar servidores. El proveedor de la nube se encarga automáticamente de la infraestructura, el escalado y el mantenimiento. No se trata de la ausencia de servidores, sino de la abstracción de los mismos de la preocupación del desarrollador. Las características clave incluyen la ejecución basada en eventos, el escalado automático desde cero y un modelo de facturación de pago por uso, lo que lo hace muy eficiente para aplicaciones con cargas de trabajo variables.

¿Cómo elijo una plataforma Serverless?

Al elegir una plataforma sin servidor, considere estos factores:

  • Integración del Ecosistema: Seleccione una plataforma que se integre bien con otros servicios en la nube que utiliza, como bases de datos, almacenamiento y autenticación (por ejemplo, AWS Lambda con S3 y DynamoDB).
  • Soporte de Lenguajes y Entornos de Ejecución: Asegúrese de que la plataforma admita los lenguajes de programación preferidos de su equipo y versiones específicas del entorno de ejecución.
  • Necesidades de Rendimiento: Evalúe métricas como la latencia de 'arranque en frío'. Para aplicaciones orientadas al usuario y sensibles a la latencia, este puede ser un factor crítico.
  • Dependencia del Proveedor (Vendor Lock-in): Sea consciente de cuán estrechamente la plataforma acopla su código a los servicios y API de un proveedor específico. El uso de marcos de código abierto puede ayudar a mitigar esto.
¿Cuál es la diferencia entre Serverless y Contenedores (por ejemplo, Docker)?

La principal diferencia es el nivel de abstracción. Los contenedores, como Docker, empaquetan una aplicación con sus dependencias, pero usted sigue siendo responsable de gestionar el entorno de ejecución (por ejemplo, una máquina virtual o un clúster de Kubernetes). Serverless abstrae esto por completo. Usted solo proporciona el código de la función, y el proveedor de la nube gestiona todo lo demás, desde el sistema operativo hasta el escalado. Serverless es ideal para tareas de corta duración y basadas en eventos, mientras que los contenedores son más adecuados para aplicaciones de larga duración y microservicios complejos que requieren más control sobre el entorno.

¿Cuáles son las principales ventajas de usar una arquitectura Serverless?

Las principales ventajas de una arquitectura sin servidor incluyen:

  • Reducción de la Sobrecarga Operativa: Elimina la necesidad de gestión de servidores, aplicación de parches y mantenimiento, permitiendo a los desarrolladores centrarse en el código.
  • Eficiencia de Costos: El modelo de pago por uso significa que solo paga por los recursos de cómputo cuando su código se está ejecutando, lo que puede reducir significativamente los costos para aplicaciones con tráfico inconsistente.
  • Escalabilidad Automática: Las aplicaciones escalan de forma automática y sin problemas para manejar cualquier carga, desde cero hasta picos de tráfico masivos.
  • Tiempo de Lanzamiento al Mercado más Rápido: Al abstraer las preocupaciones de la infraestructura, los equipos pueden construir y desplegar aplicaciones más rápidamente.
¿Cuándo NO es una buena opción Serverless?

Serverless puede no ser la mejor opción para todos los casos de uso. Generalmente es menos adecuado para aplicaciones de larga duración y con estado, como una base de datos relacional tradicional o una conexión websocket persistente que debe mantener el estado durante períodos prolongados. Las cargas de trabajo con un tráfico alto, constante y predecible podrían ser más rentables en servidores aprovisionados después de una cierta escala. Además, las aplicaciones que son extremadamente sensibles a la latencia podrían verse afectadas por los 'arranques en frío', el retraso inicial cuando se invoca una función por primera vez después de un período de inactividad.