
ToolMage
Iniciar sesión

Best 1 Preparación de Datos AI tools for Aprendizaje automático

Popular Preparación de Datos AI tools in Aprendizaje automático include Scematics, helping you work more efficiently.

Scematics
Paid

Scematics

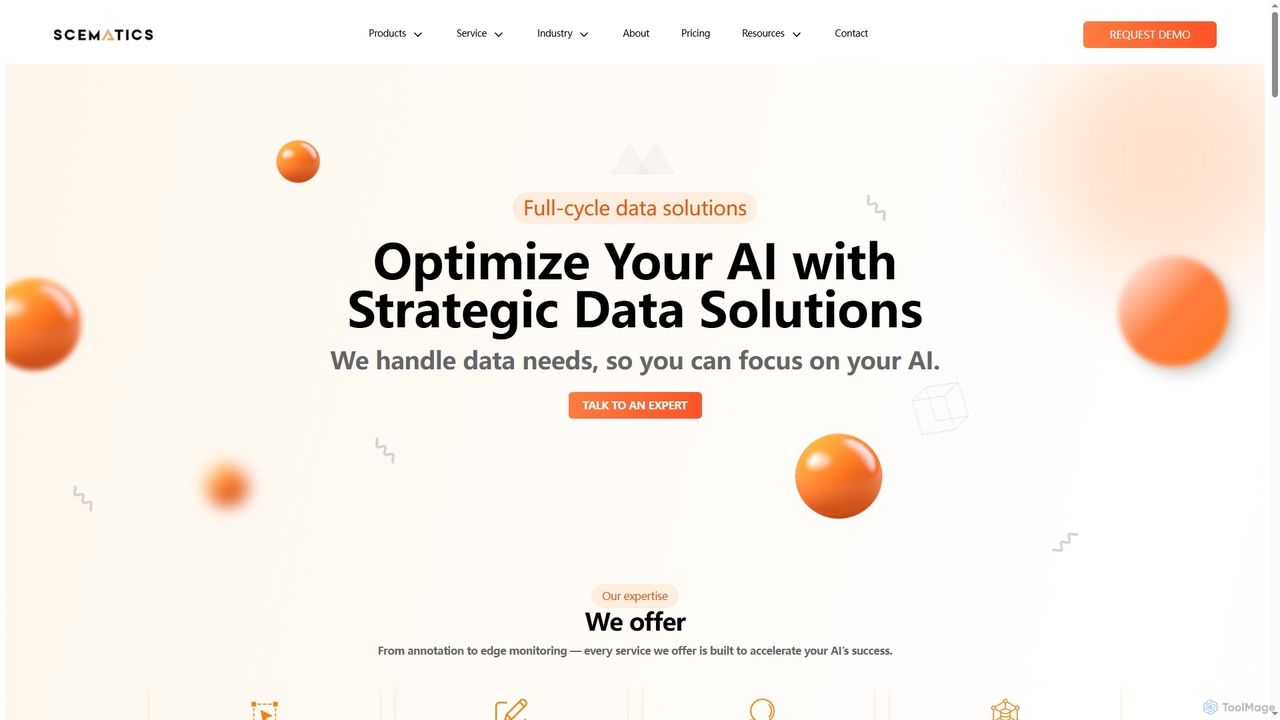
Scematics es una plataforma todo en uno de anotación y etiquetado de datos que proporciona soluciones de datos estratégicas para optimizar modelos de IA. Ofrece herramientas intuitivas, servicios de anotación expertos, monitoreo de casos extremos y generación de datos sintéticos, lo que permite a los equipos construir conjuntos de datos de entrenamiento escalables y de alta calidad para diversas aplicaciones de IA en múltiples industrias.

3D
Visits 6.6KFavorites 138Likes 137

About Preparación de Datos

Las herramientas de Preparación de Datos son soluciones impulsadas por IA diseñadas para transformar datos brutos y no estructurados en un formato limpio, estructurado y utilizable para modelos de aprendizaje automático. Estas herramientas aprovechan algoritmos avanzados para la limpieza, transformación y ingeniería de características de datos, mejorando significativamente la precisión y eficiencia del modelo. Son esenciales para que los científicos de datos e ingenieros de ML agilicen las etapas iniciales, a menudo lentas, de la tubería de aprendizaje automático, asegurando una entrada de alta calidad para un entrenamiento de modelos robusto.

Funciones Principales

  • Limpieza de Datos: Identifica y corrige automáticamente errores, maneja valores faltantes y elimina duplicados o inconsistencias.
  • Ingeniería de Características: Crea características nuevas y más informativas a partir de datos brutos, mejorando el poder predictivo de los modelos.
  • Transformación de Datos: Normaliza, escala o codifica datos en formatos adecuados para varios algoritmos de aprendizaje automático.
  • Aumento de Datos: Genera puntos de datos sintéticos para expandir conjuntos de datos, particularmente útil para clases raras o datos limitados.
  • Detección de Anomalías: Identifica valores atípicos o patrones inusuales en los datos que podrían sesgar el entrenamiento del modelo.

Escenarios de Aplicación

Las herramientas de Preparación de Datos son cruciales en todas las industrias donde la calidad de los datos impacta directamente en los resultados analíticos. Los científicos de datos las utilizan para refinar conjuntos de datos antes de entrenar modelos predictivos, asegurando la integridad de los datos. Los analistas de negocios aprovechan estas herramientas para preparar datos de clientes para la segmentación y campañas de marketing personalizadas. Además, los investigadores en campos como la genómica o las finanzas las aplican para estandarizar conjuntos de datos complejos para análisis estadísticos avanzados y reconocimiento de patrones.

Cómo Elegir

Al seleccionar herramientas de Preparación de Datos, considere los tipos y el volumen de datos que maneja, así como la complejidad de las transformaciones requeridas. Evalúe las capacidades de integración de la herramienta con sus fuentes de datos y plataformas de aprendizaje automático existentes. Busque opciones robustas de ingeniería de características, interfaces de usuario intuitivas y escalabilidad para adaptarse a las crecientes necesidades de datos. Finalmente, evalúe el nivel de automatización y la capacidad de la herramienta para manejar desafíos específicos de calidad de datos relevantes para su dominio.

Preparación de Datos use cases

1

Preparación de Datos de Clientes para la Predicción de Abandono

Un analista de datos en una empresa de telecomunicaciones necesita predecir el abandono de clientes. Utiliza herramientas de Preparación de Datos para limpiar registros brutos de interacción con clientes, fusionar datos de facturación con el uso del servicio y diseñar características como 'duración promedio de llamadas' o 'número de tickets de soporte' de fuentes dispares. Este proceso asegura que el conjunto de datos esté listo para que un modelo de aprendizaje automático identifique con precisión a los clientes en riesgo de abandono, permitiendo estrategias de retención proactivas.

2

Limpieza de Datos de Sensores para Mantenimiento Predictivo

Un ingeniero industrial que trabaja con dispositivos IoT necesita predecir fallas en equipos. Los datos brutos de los sensores a menudo contienen ruido, lecturas faltantes y marcas de tiempo inconsistentes. Las herramientas de Preparación de Datos se utilizan para filtrar el ruido, imputar valores faltantes basándose en tendencias históricas y sincronizar las marcas de tiempo en múltiples sensores. Este conjunto de datos limpio y consistente se alimenta luego a un modelo de aprendizaje automático para predecir con precisión cuándo se requiere mantenimiento, minimizando el tiempo de inactividad y los costos operativos.

3

Ingeniería de Características para la Detección de Fraude

Una institución financiera busca mejorar sus capacidades de detección de fraude. Los datos de transacciones, aunque abundantes, requieren una preparación significativa. Las herramientas de Preparación de Datos ayudan a crear nuevas características como 'frecuencia de transacciones por cuenta en la última hora', 'valor promedio de transacciones durante la última semana' o 'desviación de los patrones de gasto típicos'. Estas características diseñadas proporcionan un contexto más rico al modelo de detección de fraude, permitiéndole identificar actividades sospechosas de manera más efectiva que solo con datos brutos.

4

Estandarización de Registros Médicos para la Predicción de Enfermedades

Los investigadores médicos necesitan analizar grandes cantidades de datos de pacientes de varios hospitales para predecir brotes de enfermedades o resultados de pacientes. Los registros de atención médica a menudo vienen en diversos formatos, con terminología inconsistente y campos faltantes. Las herramientas de Preparación de Datos se utilizan para estandarizar códigos médicos, imputar resultados de laboratorio faltantes y armonizar la demografía de los pacientes en diferentes conjuntos de datos. Esto asegura un conjunto de datos unificado y de alta calidad para que los modelos de aprendizaje automático identifiquen patrones y realicen predicciones precisas.

5

Optimización de Datos de Productos de Comercio Electrónico para Motores de Recomendación

Una plataforma de comercio electrónico busca mejorar su motor de recomendación de productos. Los datos de productos, a menudo obtenidos de varios proveedores, pueden ser inconsistentes en descripciones, categorías y metadatos de imágenes. Las herramientas de Preparación de Datos se emplean para normalizar los atributos del producto, mapear categorías dispares a una taxonomía unificada y enriquecer las descripciones de productos con palabras clave relevantes. Estos datos refinados permiten que el motor de recomendación ofrezca sugerencias más precisas y personalizadas a los clientes, impulsando las ventas y la participación del usuario.

6

Aumento de Datos para Modelos de Reconocimiento de Imágenes

Un ingeniero de visión por computadora está construyendo un modelo de reconocimiento de imágenes para el diagnóstico de una enfermedad rara, pero tiene un conjunto de datos limitado de imágenes médicas. Las herramientas de Preparación de Datos con capacidades de aumento se utilizan para generar variaciones sintéticas de imágenes existentes aplicando transformaciones como rotación, volteo, zoom y ajustes de color. Esto expande significativamente el conjunto de datos de entrenamiento, ayudando al modelo a aprender características más robustas y mejorar su capacidad para identificar con precisión la enfermedad, incluso con ejemplos escasos del mundo real.

Preparación de Datos FAQ

¿Qué es la Preparación de Datos en el Aprendizaje Automático?

La Preparación de Datos en el Aprendizaje Automático se refiere al proceso de transformar datos brutos en un formato limpio, estructurado y adecuado para entrenar modelos de aprendizaje automático. Implica varios pasos cruciales como la limpieza de datos, la ingeniería de características, la transformación de datos y el manejo de valores faltantes. El objetivo principal es asegurar que los datos sean de alta calidad, consistentes y optimizados para maximizar el rendimiento del modelo y prevenir problemas como el sesgo o el sobreajuste.

¿Cómo mejoran las herramientas de Preparación de Datos el rendimiento de los modelos de ML?

Las herramientas de Preparación de Datos mejoran significativamente el rendimiento de los modelos de ML al asegurar que los datos de entrada sean de la más alta calidad. Reducen el ruido y los errores mediante la limpieza, lo que evita que los modelos aprendan patrones incorrectos. La ingeniería de características ayuda a crear variables más informativas, permitiendo que los modelos capturen relaciones complejas. Al transformar los datos a formatos óptimos, estas herramientas aseguran la compatibilidad con los algoritmos y aceleran el entrenamiento, lo que lleva a modelos más precisos, robustos y generalizables.

¿Cuál es la diferencia entre Preparación de Datos y Aumento de Datos?

La Preparación de Datos es un proceso amplio que abarca la limpieza, transformación y diseño de características a partir de datos existentes para hacerlos adecuados para ML. El Aumento de Datos es una técnica específica dentro de la preparación de datos, utilizada principalmente para datos de imagen, audio o texto, donde se generan nuevas muestras de datos sintéticos aplicando modificaciones menores a los datos existentes. Mientras que la preparación de datos se centra en refinar y estructurar los datos dados, el aumento de datos tiene como objetivo aumentar el tamaño y la diversidad del conjunto de datos para mejorar la generalización del modelo, especialmente cuando los datos son escasos.

¿Cuáles son los pasos clave involucrados en la Preparación de Datos?

Los pasos clave en la Preparación de Datos suelen incluir: Recopilación de Datos (reunir datos brutos), Limpieza de Datos (manejar valores faltantes, atípicos e inconsistencias), Transformación de Datos (normalizar, escalar o codificar datos), Ingeniería de Características (crear características nuevas y más predictivas) y Reducción de Datos (reducir la dimensionalidad o el tamaño de la muestra sin perder información crítica). Cada paso es vital para asegurar que los datos estén optimizados para los algoritmos de aprendizaje automático, lo que lleva a un entrenamiento de modelos más preciso y eficiente.

¿Quién se beneficia más del uso de herramientas de Preparación de Datos?

Las herramientas de Preparación de Datos benefician principalmente a científicos de datos, ingenieros de aprendizaje automático y analistas de datos que trabajan regularmente con conjuntos de datos grandes, complejos o desordenados. Los investigadores en varios campos (por ejemplo, atención médica, finanzas, marketing) también obtienen un valor significativo al optimizar sus flujos de trabajo de preprocesamiento de datos. Esencialmente, cualquier persona involucrada en la construcción o implementación de modelos basados en datos, donde la calidad de los datos es primordial para obtener información y predicciones precisas, encontrará estas herramientas indispensables para ahorrar tiempo y mejorar los resultados.

¿Cuáles son los desafíos comunes en la Preparación de Datos?

Los desafíos comunes en la Preparación de Datos incluyen el manejo de datos faltantes (estrategias de imputación), el tratamiento de valores atípicos y datos ruidosos, la gestión de formatos o unidades de datos inconsistentes entre diferentes fuentes, y la realización de una ingeniería de características efectiva. Además, la escalabilidad para conjuntos de datos muy grandes, la garantía de la privacidad y seguridad de los datos, y el enorme consumo de tiempo de la preparación manual son obstáculos significativos. Las herramientas de Preparación de Datos impulsadas por IA tienen como objetivo automatizar y agilizar muchas de estas tareas complejas y repetitivas, reduciendo el error humano y acelerando el proceso general.