
ToolMage
Iniciar sesión

Best 1 Ingeniería de Fiabilidad del Sitio AI tools for Operaciones

Popular Ingeniería de Fiabilidad del Sitio AI tools in Operaciones include Kubiks, helping you work more efficiently.

Kubiks
Freemium

Kubiks

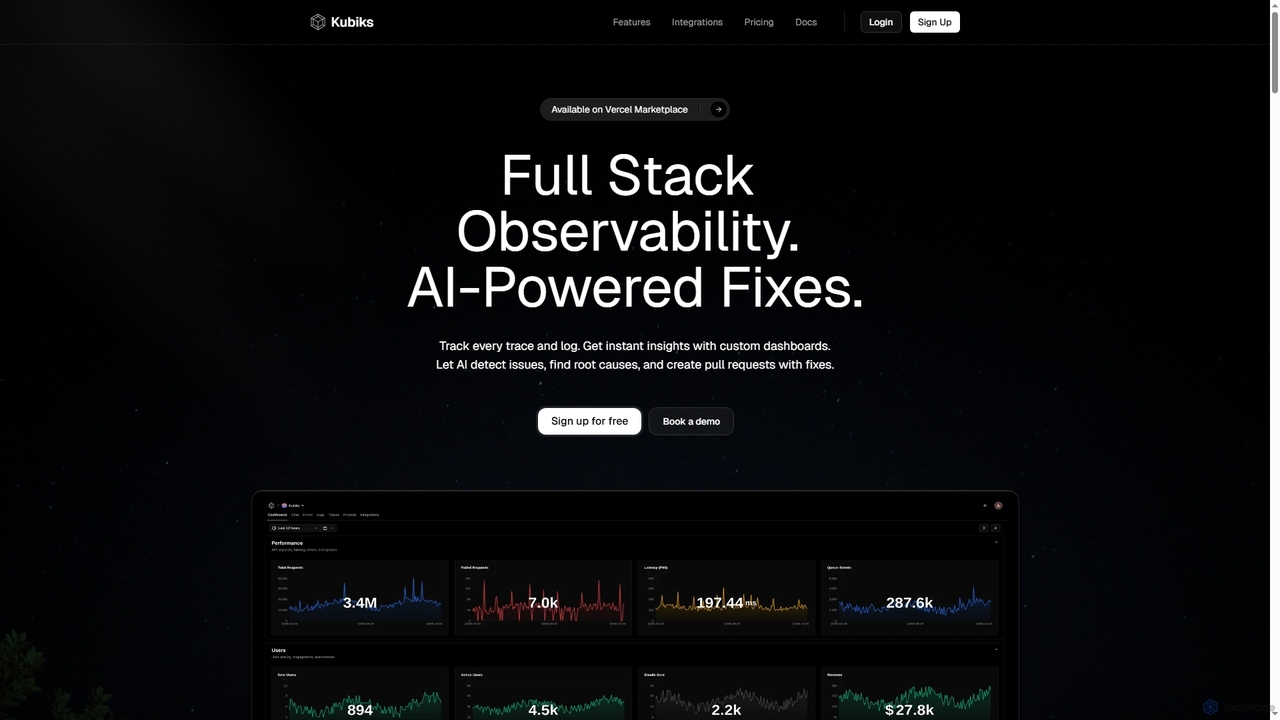
Kubiks es una plataforma de observabilidad full-stack impulsada por IA que proporciona trazado distribuido, registro y paneles personalizados. Detecta automáticamente problemas, identifica las causas raíz y genera solicitudes de extracción con soluciones, ayudando a los equipos de ingeniería a depurar más rápido y resolver problemas de forma proactiva.

Depuración
Visits 6.4KFavorites 130Likes 135

About Ingeniería de Fiabilidad del Sitio

La Ingeniería de Fiabilidad del Sitio (SRE) es una disciplina que aplica principios de ingeniería de software a problemas de infraestructura y operaciones, con el objetivo de crear sistemas altamente fiables y escalables. Aprovecha la automatización, la toma de decisiones basada en datos y un enfoque en los objetivos de nivel de servicio (SLO) para garantizar la estabilidad y el rendimiento de los servicios críticos. Como componente central dentro de la categoría más amplia de Operaciones, las herramientas SRE permiten a los equipos gestionar proactivamente la salud del sistema, responder eficientemente a los incidentes y mejorar continuamente la fiabilidad del servicio.

Características Clave

  • Monitorización de SLO/SLA: Rastrea e informa sobre los objetivos y acuerdos de nivel de servicio para asegurar que se cumplan los objetivos de rendimiento.
  • Gestión y Automatización de Incidentes: Agiliza los procesos de detección, alerta, respuesta y resolución de incidentes a través de flujos de trabajo automatizados.
  • Gestión del Presupuesto de Errores: Define y rastrea los niveles aceptables de falta de fiabilidad, guiando las prioridades de desarrollo y operación.
  • Observabilidad y Monitorización: Proporciona información completa sobre el comportamiento del sistema a través de registros, métricas y trazas para la identificación proactiva de problemas.
  • Planificación de Capacidad: Pronostica las necesidades de recursos y optimiza la infraestructura para manejar cargas anticipadas y prevenir interrupciones.

Escenarios Aplicables

Las herramientas SRE son esenciales para organizaciones que ejecutan sistemas complejos y distribuidos, como grandes plataformas de comercio electrónico, proveedores de SaaS y servicios financieros. Permiten a los equipos SRE, ingenieros de DevOps e ingenieros de plataforma mantener una alta disponibilidad, gestionar la fiabilidad de los microservicios y automatizar tareas operativas críticas, asegurando experiencias de usuario fluidas y la continuidad del negocio.

Cómo Elegir

Al seleccionar herramientas SRE, priorice soluciones que ofrezcan características de observabilidad robustas, integración perfecta con las tuberías de CI/CD y plataformas en la nube existentes, y capacidades integrales de gestión de incidentes. Considere la escalabilidad de la herramienta, las características de informes para el cumplimiento de SLO y su capacidad para admitir el seguimiento del presupuesto de errores. La facilidad de uso y el soporte de la comunidad también son cruciales para una adopción efectiva por parte del equipo.

Ingeniería de Fiabilidad del Sitio use cases

1

Automatización de Flujos de Trabajo de Respuesta a Incidentes

Para ingenieros de guardia y equipos SRE, las herramientas SRE impulsadas por IA automatizan la detección de anomalías e incidentes críticos en sistemas distribuidos. Pueden activar alertas, iniciar scripts de diagnóstico e incluso sugerir pasos de remediación basados en datos históricos, reduciendo significativamente el tiempo medio de resolución (MTTR) y minimizando la interrupción del servicio durante interrupciones críticas.

2

Monitorización y Aplicación de Objetivos de Nivel de Servicio (SLOs)

Los equipos SRE utilizan estas herramientas para definir, monitorizar y aplicar los Objetivos de Nivel de Servicio (SLOs) para servicios críticos. Las herramientas recopilan y analizan continuamente métricas (por ejemplo, latencia, tasa de error, disponibilidad), proporcionando paneles en tiempo real y alertas cuando los SLOs están en riesgo, lo que permite a los equipos abordar proactivamente la degradación del rendimiento antes de que afecte a los usuarios.

3

Planificación Proactiva de Capacidad y Optimización de Recursos

Los arquitectos de infraestructura y los SRE aprovechan las herramientas SRE para la planificación de capacidad basada en datos. Al analizar los patrones de uso históricos y predecir la demanda futura, estas herramientas ayudan a optimizar la asignación de recursos, prevenir cuellos de botella y asegurar que los sistemas puedan escalar eficientemente para satisfacer los picos de tráfico, evitando así costosos excesos de aprovisionamiento o interrupciones del servicio debido a la falta de aprovisionamiento.

4

Realización de Análisis Post-Mortem Sin Culpa

Después de un incidente, las herramientas SRE facilitan un análisis post-mortem exhaustivo al agregar registros, métricas y trazas de diversas fuentes. Esto permite a los equipos SRE y de desarrollo identificar las causas raíz, comprender los factores contribuyentes y documentar las lecciones aprendidas sin asignar culpas, fomentando una cultura de mejora continua y previniendo la recurrencia de problemas similares.

5

Implementación y Gestión de Presupuestos de Errores

Los propietarios de productos y los SRE utilizan estas herramientas para implementar y gestionar presupuestos de errores, que cuantifican la cantidad aceptable de falta de fiabilidad para un servicio. Las herramientas rastrean el consumo del presupuesto de errores en tiempo real, proporcionando señales claras a los equipos de producto e ingeniería sobre cuándo priorizar el trabajo de fiabilidad sobre el desarrollo de nuevas características, equilibrando la innovación con la estabilidad.

6

Mejora de la Observabilidad en Sistemas Distribuidos Complejos

Los ingenieros de plataforma y los SRE implementan estas herramientas para obtener una profunda observabilidad en arquitecturas de microservicios y aplicaciones nativas de la nube. Al correlacionar métricas, registros y trazas a través de cientos o miles de servicios, las herramientas proporcionan una vista unificada de la salud del sistema, lo que permite una depuración rápida, el ajuste del rendimiento y una comprensión holística del comportamiento del sistema.

Ingeniería de Fiabilidad del Sitio FAQ

¿Qué es la Ingeniería de Fiabilidad del Sitio (SRE)?

La Ingeniería de Fiabilidad del Sitio (SRE) es un enfoque de ingeniería de software para las operaciones de TI, centrado en la construcción y operación de sistemas a gran escala y altamente fiables. Su objetivo es cerrar la brecha entre el desarrollo y las operaciones aplicando principios de ingeniería a los problemas operativos, enfatizando la automatización, la medición y la mejora continua para lograr objetivos de nivel de servicio (SLOs) específicos.

¿En qué se diferencia la Ingeniería de Fiabilidad del Sitio (SRE) de las Operaciones tradicionales?

SRE se diferencia de las Operaciones tradicionales al adoptar una mentalidad de ingeniería de software. Mientras que las Operaciones tradicionales a menudo se centran en tareas manuales y respuestas reactivas, SRE enfatiza la automatización, la resolución proactiva de problemas y el tratamiento de las operaciones como un problema de software. Los equipos SRE a menudo escriben código para automatizar tareas, gestionar sistemas programáticamente y utilizar presupuestos de errores para equilibrar la fiabilidad con la velocidad de las características, yendo más allá de la simple mentalidad de "mantener las luces encendidas".

¿Cuáles son las métricas clave en las que se centran los equipos SRE?

Los equipos SRE se centran principalmente en los Indicadores de Nivel de Servicio (SLIs), los Objetivos de Nivel de Servicio (SLOs) y los Acuerdos de Nivel de Servicio (SLAs). Los SLIs clave incluyen latencia, rendimiento, tasa de error y disponibilidad. Los SLOs son objetivos específicos para estos SLIs (por ejemplo, 99.9% de disponibilidad). Los SLAs son contratos formales basados en SLOs, a menudo con penalizaciones. Los presupuestos de errores, derivados de los SLOs, también son cruciales para guiar las prioridades de desarrollo.

¿Cómo pueden las herramientas de IA ayudar en la Ingeniería de Fiabilidad del Sitio?

Las herramientas de IA mejoran significativamente la SRE al automatizar tareas repetitivas, mejorar la detección de anomalías y predecir posibles interrupciones. Pueden analizar grandes cantidades de datos de telemetría (registros, métricas, trazas) para identificar patrones, correlacionar eventos en sistemas distribuidos e incluso sugerir causas raíz o pasos de remediación para incidentes. Esto permite a los SRE pasar de la resolución reactiva de problemas a un trabajo proactivo y estratégico, optimizando el rendimiento y la fiabilidad del sistema de manera más efectiva.

¿Qué debo considerar al elegir herramientas SRE?

Al seleccionar herramientas SRE, considere su capacidad para proporcionar una observabilidad integral (métricas, registros, trazas), una gestión de incidentes y alertas robusta, y soporte para definir y rastrear SLOs y presupuestos de errores. Busque sólidas capacidades de integración con su infraestructura existente (proveedores de la nube, CI/CD, sistemas de monitorización) y una interfaz fácil de usar. La escalabilidad, la seguridad y el soporte y la comunidad del proveedor también son factores vitales.