ToolMage
Iniciar sesión

Best 2 Base de datos AI tools for Recursos

Popular Base de datos AI tools in Recursos include abcdindex y llm_price, helping you work more efficiently.

llm_price
Free

llm_price

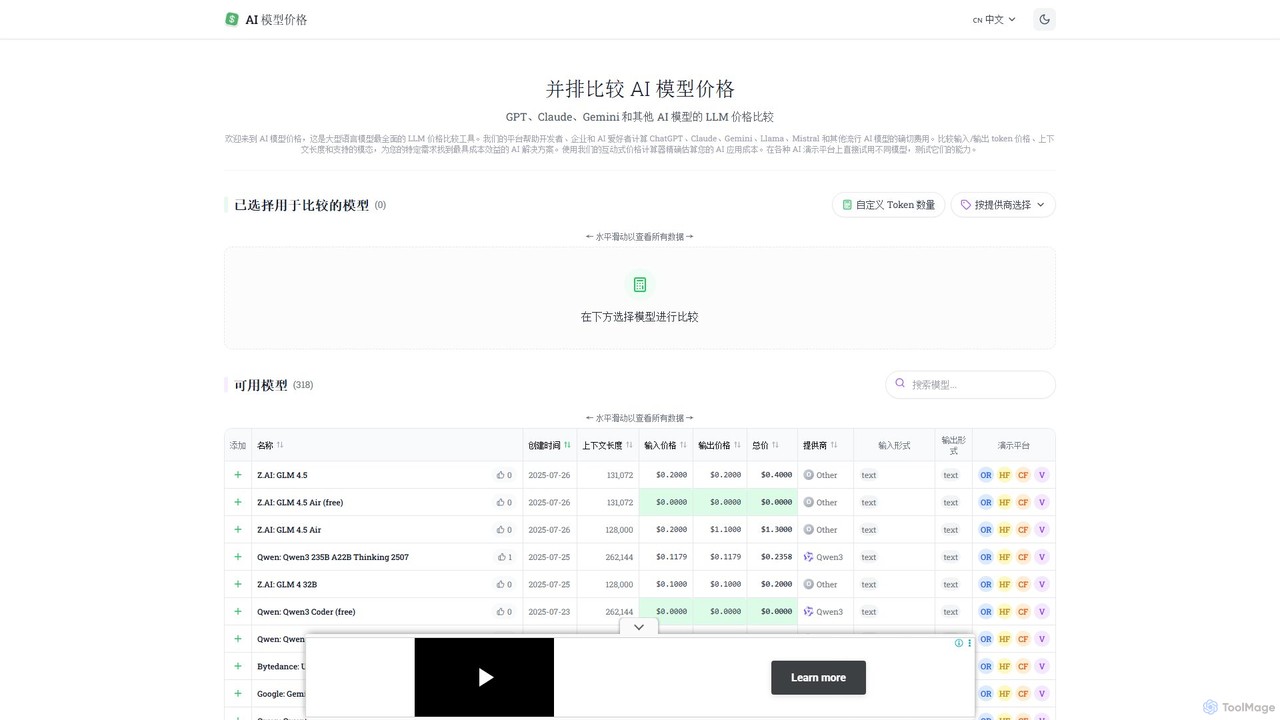
llm_price es una herramienta de comparación integral para los precios de API de Modelos de Lenguaje Grandes (LLM). Permite a desarrolladores, empresas y entusiastas de la IA comparar fácilmente los costos de cientos de modelos de proveedores como OpenAI, Google, Anthropic y Mistral. Con una calculadora de costos interactiva y un análisis lado a lado de los precios de los tokens, la longitud del contexto y las modalidades, simplifica el proceso de selección de la solución de IA más rentable para cualquier proyecto.

Gestión de API
Visits 13.1KFavorites 121Likes 136
abcdindex
Free

abcdindex

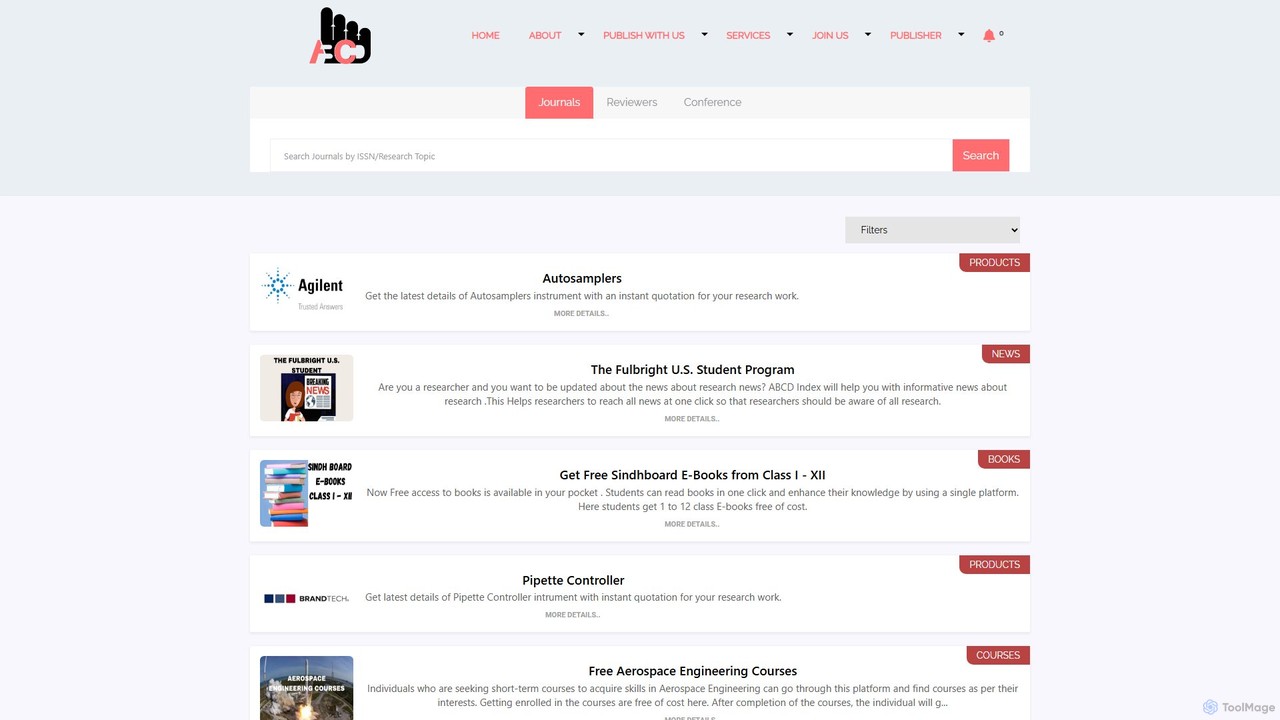
abcdindex (Academic Business Current Data Index) es una plataforma gratuita y completa para la comunidad académica. Proporciona una base de datos verificada y estructurada de revistas internacionales, artículos de investigación, oportunidades de financiación, becas y otros recursos académicos. La plataforma tiene como objetivo ayudar a investigadores, estudiantes y editores a navegar eficientemente por el panorama académico y evitar publicaciones depredadoras o inactivas ofreciendo información fiable y centralizada.

Investigación
Visits 158KFavorites 164Likes 154

About Base de datos

Las bases de datos de IA son colecciones curadas de datos estructurados que sirven como el recurso fundamental para entrenar, probar y desplegar modelos de inteligencia artificial. Estos recursos están preparados específicamente para el consumo por máquinas, a menudo conteniendo grandes cantidades de datos etiquetados o no etiquetados como imágenes, texto o cifras numéricas. Proporcionan la materia prima esencial para tareas de aprendizaje automático, procesamiento del lenguaje natural y visión por computadora. La calidad, escala y relevancia de estas bases de datos determinan directamente el rendimiento y las capacidades de un sistema de IA.

Características Clave

  • Datos Estructurados y Etiquetados: Los datos están organizados y a menudo anotados con etiquetas, lo que los hace adecuados para algoritmos de aprendizaje supervisado.
  • Gran Escala: Típicamente contienen millones o incluso miles de millones de puntos de datos para asegurar que los modelos puedan aprender patrones generalizables.
  • Especificidad de Dominio: Enfocados en campos particulares como la medicina, las finanzas o la conducción autónoma para construir IA especializada.
  • Calidad y Consistencia de los Datos: Limpiados y validados para minimizar el ruido y los sesgos, lo cual es crucial para construir modelos fiables.

Casos de Uso

Las bases de datos de IA son esenciales para científicos de datos, ingenieros de aprendizaje automático e investigadores. Se utilizan para entrenar sistemas de reconocimiento facial con conjuntos de datos de imágenes, desarrollar modelos de lenguaje utilizando corpus de texto masivos y construir algoritmos de detección de fraude a partir de datos históricos de transacciones. Las instituciones académicas también utilizan conjuntos de datos estandarizados para comparar el rendimiento de nuevos algoritmos de IA.

Cómo Elegir

Al seleccionar una base de datos de IA, considere su relevancia para su dominio de problema específico. Evalúe la calidad de los datos, la precisión de sus etiquetas y la presencia de posibles sesgos. Verifique los términos de la licencia para asegurarse de que se pueda utilizar para su propósito previsto (p. ej., académico vs. comercial). Finalmente, evalúe el formato y el tamaño de los datos para confirmar la compatibilidad con sus recursos computacionales y su cadena de herramientas.

Base de datos use cases

1

Entrenamiento de un modelo de análisis de imágenes médicas

Un investigador de IA en el sector de la salud necesita desarrollar un modelo que pueda detectar signos tempranos de enfermedades a partir de escaneos médicos como radiografías o resonancias magnéticas. Utilizan una base de datos especializada y de alta calidad de miles de imágenes médicas anonimizadas, cada una meticulosamente anotada por radiólogos. Al entrenar un modelo de visión por computadora en este conjunto de datos, el sistema aprende a identificar patrones sutiles asociados con condiciones específicas. La herramienta de IA resultante puede ayudar a los radiólogos destacando áreas potenciales de preocupación, lo que lleva a diagnósticos más rápidos y precisos.

2

Desarrollo de un modelo de Procesamiento del Lenguaje Natural (PLN)

Un equipo de ciencia de datos tiene la tarea de construir una herramienta de análisis de sentimientos para las opiniones de los clientes. Para lograrlo, aprovechan una base de datos de texto a gran escala que contiene millones de reseñas de productos, cada una etiquetada como positiva, negativa o neutral. Este corpus sirve como la verdad fundamental para entrenar su modelo de PLN. El modelo procesa el texto, aprende los matices del lenguaje e identifica patrones que se correlacionan con diferentes sentimientos. Después del entrenamiento, la herramienta puede clasificar automáticamente reseñas nuevas y no vistas, proporcionando a la empresa información valiosa sobre la satisfacción del cliente a gran escala.

3

Construcción de un sistema de detección de fraude financiero

Una empresa de tecnología financiera tiene como objetivo reducir las transacciones fraudulentas para sus usuarios. Sus ingenieros de aprendizaje automático utilizan una base de datos histórica masiva de datos de transacciones. Esta base de datos incluye características como el monto de la transacción, la hora, la ubicación y el tipo de comerciante, con cada transacción etiquetada como legítima o fraudulenta. Al entrenar un modelo de detección de anomalías con estos datos, el sistema aprende las características del comportamiento transaccional normal. Cuando ocurre una nueva transacción, el modelo puede predecir la probabilidad de que sea fraudulenta en tiempo real, lo que permite a la empresa bloquear actividades sospechosas y proteger a sus clientes.

4

Evaluación comparativa de nuevos algoritmos de IA

Un laboratorio de investigación académica desarrolla un nuevo algoritmo para el reconocimiento de objetos. Para demostrar su eficacia, deben comparar su rendimiento con los métodos de vanguardia existentes. Utilizan una base de datos pública y estandarizada como ImageNet o COCO, que son ampliamente aceptadas en la comunidad de investigación para la evaluación comparativa. Al ejecutar su nuevo algoritmo y los ya establecidos en el mismo conjunto de datos, pueden obtener métricas objetivas como la precisión y la velocidad de procesamiento. Esto les permite publicar sus hallazgos con resultados verificables, contribuyendo al avance del campo de la IA.

5

Potenciación de un sistema de preguntas y respuestas basado en conocimiento

Una empresa de tecnología legal quiere crear un asistente de IA que pueda responder preguntas legales complejas. En lugar de un corpus de texto general, utilizan una base de conocimientos especializada: una base de datos estructurada que contiene estatutos legales, jurisprudencia y artículos académicos, todos interconectados a través de un grafo de conocimiento. Cuando un abogado plantea una pregunta, la IA no solo busca palabras clave; navega por este grafo para comprender las relaciones y el contexto. Esto permite que el sistema proporcione respuestas muy precisas y conscientes del contexto, respaldadas por citas legales específicas, actuando como una poderosa herramienta de investigación para los profesionales del derecho.

6

Creación de datos sintéticos para pruebas de modelos de IA

Un equipo de desarrollo de IA está construyendo un sistema de conducción autónoma pero carece de suficientes datos del mundo real para casos extremos raros, como animales que cruzan la carretera de repente. Utilizan una base de datos fundamental de escenarios de conducción para generar grandes cantidades de datos sintéticos realistas. Este proceso les permite crear miles de variaciones de un solo escenario, alterando las condiciones climáticas, la iluminación y la velocidad de los objetos. Al probar su modelo con esta completa base de datos sintética, pueden asegurarse de que la IA sea robusta y fiable en situaciones que son demasiado peligrosas o infrecuentes para capturar en la realidad, todo sin comprometer la privacidad del usuario.

Base de datos FAQ

¿Qué es un recurso de base de datos de IA?

Una base de datos de IA es una colección grande y curada de datos organizada específicamente para entrenar y probar modelos de inteligencia artificial. A diferencia de las bases de datos de propósito general, estas están diseñadas como recursos, a menudo conteniendo millones de ejemplos etiquetados (como imágenes con descripciones o texto con etiquetas de sentimiento). Sirven como los 'libros de texto' de los cuales los algoritmos de aprendizaje automático aprenden a realizar tareas como reconocer objetos, entender el lenguaje o detectar anomalías.

¿Cómo elegir la base de datos de IA adecuada para un proyecto?

Elegir la base de datos de IA adecuada depende de varios factores. Primero, asegúrese de que los datos sean muy relevantes para su problema específico. Segundo, evalúe la calidad de los datos, incluyendo su limpieza, la precisión de las etiquetas y los posibles sesgos. Tercero, verifique el acuerdo de licencia para confirmar que permite su caso de uso (por ejemplo, comercial vs. académico). Finalmente, considere el formato y el tamaño de la base de datos para asegurarse de que sea compatible con su infraestructura técnica y herramientas.

¿Cuál es la diferencia entre un conjunto de datos público y una base de datos propietaria?

La principal diferencia radica en la accesibilidad y la propiedad.

  • Conjuntos de datos públicos (por ejemplo, ImageNet, Wikipedia Corpus) están disponibles abiertamente, a menudo de forma gratuita, principalmente para investigación académica y evaluación comparativa pública. Fomentan la colaboración y la evaluación estandarizada.
  • Bases de datos propietarias son activos privados propiedad de una empresa. A menudo contienen datos sensibles o altamente especializados (como transacciones de clientes o documentos internos) y proporcionan una ventaja competitiva significativa para desarrollar soluciones de IA únicas.

¿Por qué es tan importante la calidad de los datos en una base de datos de IA?

La calidad de los datos es primordial porque los modelos de IA aprenden directamente de los datos que se les proporcionan. El principio de 'basura entra, basura sale' es fundamental aquí. Datos de alta calidad —que son precisos, completos, consistentes y sin sesgos— conducen a modelos de IA más fiables, precisos y justos. Por el contrario, datos de baja calidad con errores, sesgos o inconsistencias darán como resultado un modelo que funciona mal y toma decisiones poco fiables o incluso perjudiciales.

¿Qué tipos de datos comunes se encuentran en las bases de datos de IA?

Las bases de datos de IA pueden contener una amplia variedad de tipos de datos, adaptados a la tarea de IA específica. Los tipos comunes incluyen:

  • Datos de imagen: Colecciones de fotos o videos, a menudo con etiquetas para la detección de objetos o la clasificación de imágenes.
  • Datos de texto: Grandes corpus de texto de libros, artículos o sitios web para entrenar modelos de lenguaje.
  • Datos tabulares: Datos estructurados en filas y columnas, como hojas de cálculo, utilizados para análisis predictivo y pronósticos.
  • Datos de audio: Grabaciones de voz o sonidos, típicamente con transcripciones, para sistemas de reconocimiento de voz.
  • Datos de series temporales: Puntos de datos indexados en orden de tiempo, como precios de acciones o lecturas de sensores, para modelos de pronóstico.