ToolMage
Iniciar sesión

Best 1 Bases de Datos AI tools for Recursos

Popular Bases de Datos AI tools in Recursos include AI_Database, helping you work more efficiently.

AI_Database
Paid

AI_Database

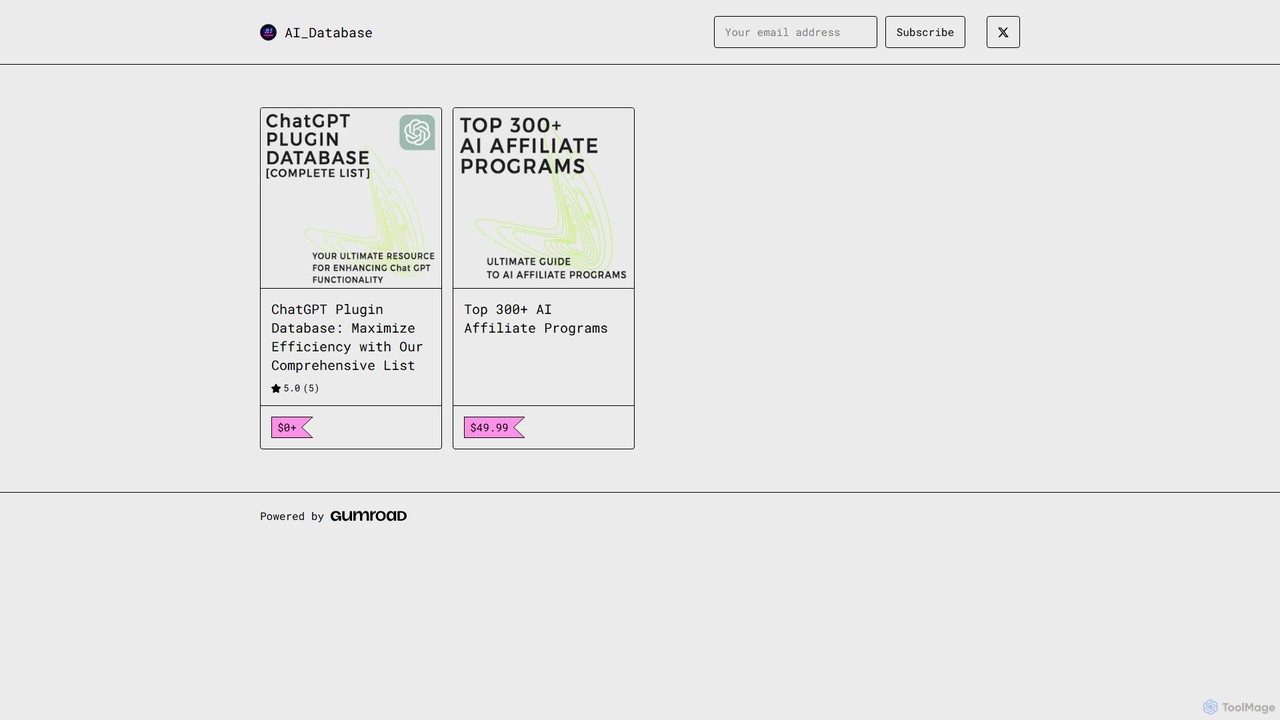
AI_Database es una lista premium y curada de más de 300 programas de afiliados de IA verificados. Diseñado para blogueros, especialistas en marketing e influencers, ahorra más de 80 horas de investigación, ayudando a los usuarios a monetizar su contenido conectándose con herramientas y servicios de IA de alta comisión en diversos nichos.

Monetización
Visits 6.4KFavorites 132Likes 134

About Bases de Datos

Las bases de datos de IA son repositorios de datos especializados diseñados para almacenar, gestionar y servir los datos necesarios para entrenar, evaluar y desplegar modelos de aprendizaje automático. Estas plataformas están optimizadas para manejar conjuntos de datos a gran escala, tipos de datos complejos como incrustaciones vectoriales y consultas de alto rendimiento comunes en aplicaciones de IA. Proporcionan los recursos fundamentales —desde conjuntos de datos públicos curados hasta almacenes de vectores de alto rendimiento— que impulsan los sistemas inteligentes. Usar una base de datos de IA dedicada garantiza la calidad, accesibilidad y rendimiento de los datos, aspectos críticos para construir soluciones de IA precisas y escalables.

Características Clave

  • Almacenamiento y Búsqueda de Vectores: Almacena eficientemente incrustaciones vectoriales de alta dimensión y realiza búsquedas rápidas de similitud (ANN).
  • Curación y Versionado de Datos: Ofrece herramientas para limpiar, etiquetar y versionar conjuntos de datos para asegurar la reproducibilidad y la calidad del modelo.
  • Alta Escalabilidad: Diseñadas para manejar petabytes de datos y millones de consultas por segundo para soportar sistemas de IA de nivel de producción.
  • Integración con Frameworks: Ofrece APIs nativas e integraciones para frameworks de aprendizaje automático populares como PyTorch y TensorFlow.

Casos de Uso

Las bases de datos de IA son esenciales para científicos de datos, ingenieros de aprendizaje automático e investigadores de IA. Se utilizan para entrenar modelos de visión por computadora con grandes conjuntos de datos de imágenes, potenciar motores de búsqueda semántica y de recomendación con bases de datos vectoriales, y para el ajuste fino de grandes modelos de lenguaje (LLM) con corpus de texto específicos de un dominio. También forman la columna vertebral de MLOps al proporcionar una ubicación centralizada para los almacenes de características y el seguimiento de experimentos.

Cómo Elegir

Al seleccionar una base de datos de IA, considere el tipo de dato principal (p. ej., vectores, imágenes, texto, tabular). Evalúe su escalabilidad y rendimiento de consultas en función de su carga de trabajo esperada. Analice sus capacidades de integración con su pila de IA y herramientas de MLOps existentes. Finalmente, examine la licencia de datos para conjuntos de datos públicos y el modelo de precios para servicios de bases de datos gestionadas para asegurarse de que se alinee con el presupuesto y los derechos de uso de su proyecto.

Bases de Datos use cases

1

Potenciando un Motor de Búsqueda Semántica

Un desarrollador en una empresa de comercio electrónico tiene la tarea de mejorar el descubrimiento de productos. En lugar de depender de la coincidencia de palabras clave, utiliza una base de datos vectorial. Las descripciones e imágenes de los productos se convierten en vectores de alta dimensión (embeddings) y se almacenan. Cuando un usuario busca 'zapatillas cómodas para correr', el sistema convierte la consulta en un vector y utiliza la base de datos para encontrar los vectores de productos más similares. Esto permite que el motor de búsqueda entienda la intención y el contexto del usuario, devolviendo resultados más relevantes como zapatillas de running con suelas acolchadas, incluso si las palabras clave exactas no están en el título del producto.

2

Entrenamiento de un Modelo de Reconocimiento de Imágenes Personalizado

Un científico de datos en una startup de salud necesita construir un modelo para detectar anomalías en escáneres médicos. Utiliza un conjunto de datos público y curado de miles de imágenes médicas etiquetadas (p. ej., radiografías, resonancias magnéticas). Esta base de datos sirve como la verdad fundamental (ground truth) para entrenar su red neuronal convolucional (CNN). Al alimentar el modelo con estas imágenes de alta calidad y pre-etiquetadas, pueden entrenarlo para identificar con precisión condiciones específicas, acelerando significativamente el proceso de desarrollo en comparación con la recopilación y etiquetado de datos desde cero. La función de versionado del conjunto de datos también les permite reproducir experimentos de manera fiable.

3

Ajuste Fino de un LLM para Análisis de Documentos Legales

Un bufete de abogados quiere usar un asistente de IA para resumir contratos legales. Un Modelo de Lenguaje Grande (LLM) de propósito general carece de la terminología específica. Un ingeniero de PNL utiliza una base de datos especializada que contiene un vasto corpus de documentos legales, jurisprudencia y estatutos. Utilizan estos datos específicos del dominio para ajustar finamente un LLM pre-entrenado. El modelo resultante entiende la jerga legal compleja y puede resumir contratos con precisión, identificar cláusulas y señalar riesgos potenciales, proporcionando una herramienta valiosa para abogados y asistentes legales que ahorra horas de revisión manual.

4

Construcción de un Grafo de Conocimiento para un Sistema de Preguntas y Respuestas

Una gran empresa quiere crear un bot interno de preguntas y respuestas para responder a las preguntas de los empleados sobre las políticas y procedimientos de la compañía. Un ingeniero de aprendizaje automático utiliza una base de datos de grafos para construir un grafo de conocimiento. Ingieren datos de diversas fuentes como documentos de RR.HH., wikis internas y PDFs de políticas. La base de datos almacena entidades (p. ej., 'empleado', 'política de vacaciones') y sus relaciones (p. ej., 'es elegible para'). Cuando un empleado pregunta, '¿Cuántos días de vacaciones tengo?', la IA puede recorrer este grafo para encontrar la respuesta directa basada en el rol y la antigüedad del empleado, proporcionando una respuesta mucho más precisa y consciente del contexto que una simple búsqueda de documentos.

5

Evaluación Comparativa del Rendimiento de Modelos de IA

Un laboratorio de investigación de IA desarrolla un nuevo algoritmo para la detección de objetos. Para demostrar su eficacia, necesitan compararlo con los modelos de vanguardia existentes. Utilizan una base de datos de referencia estandarizada como COCO (Common Objects in Context). Esta base de datos proporciona un gran conjunto de imágenes con anotaciones estandarizadas y una métrica de evaluación definida (p. ej., Precisión Promedio Media). Al ejecutar su nuevo modelo en este conjunto de datos y comparar la puntuación con los resultados publicados de otros modelos, pueden demostrar objetivamente las mejoras de rendimiento. Este proceso es crucial para las publicaciones académicas y para validar la viabilidad en el mundo real de las nuevas técnicas de IA.

6

Gestión de un Almacén de Características para MLOps

Un equipo de MLOps en una empresa de servicios financieros gestiona docenas de modelos en producción. Para garantizar la coherencia y evitar trabajo redundante, utilizan un almacén de características (feature store), que es una base de datos especializada. Almacena características precalculadas (p. ej., 'volumen_transacciones_7dias_cliente') que pueden reutilizarse en diferentes modelos. Cuando se desarrolla un nuevo modelo para la detección de fraudes, el científico de datos puede obtener características validadas y listas para producción directamente del almacén. Esta base de datos asegura que las características utilizadas para el entrenamiento sean consistentes con las utilizadas para la inferencia en tiempo real, reduciendo el sesgo entre entrenamiento y servicio y mejorando la fiabilidad del modelo.

Bases de Datos FAQ

¿Qué son las bases de datos de IA?

Las bases de datos de IA son repositorios de datos especializados que sirven como recursos fundamentales para proyectos de aprendizaje automático. A diferencia de las bases de datos de propósito general, están optimizadas para tareas específicas de IA. Esta categoría incluye varios tipos:

  • Conjuntos de datos públicos: Colecciones curadas de datos etiquetados (p. ej., ImageNet) para entrenar y evaluar modelos.
  • Bases de datos vectoriales: Diseñadas para almacenar y consultar incrustaciones vectoriales de alta dimensión para tareas como búsqueda semántica y recomendación.
  • Grafos de conocimiento: Almacenan datos como nodos y aristas para representar relaciones complejas, potenciando sistemas avanzados de preguntas y respuestas.
  • Almacenes de características (Feature Stores): Centralizan el almacenamiento y la gestión de características para el entrenamiento e inferencia de modelos, crucial para MLOps.

¿Cuál es la diferencia entre una base de datos tradicional y una base de datos vectorial?

La diferencia principal radica en cómo almacenan y recuperan los datos. Una base de datos tradicional (como SQL) almacena datos estructurados en filas y columnas y recupera información basada en coincidencias exactas con los valores de la consulta. Una base de datos vectorial, sin embargo, está diseñada para almacenar datos como vectores numéricos de alta dimensión (embeddings). En lugar de una coincidencia exacta, encuentra puntos de datos que son los 'más cercanos' o más similares en el espacio vectorial utilizando algoritmos como el Vecino Más Cercano Aproximado (ANN). Esto hace que las bases de datos vectoriales sean ideales para aplicaciones de IA como la búsqueda semántica, la búsqueda de similitud de imágenes y los sistemas de recomendación, donde comprender el contexto y el significado es más importante que la coincidencia exacta de palabras clave.

¿Cómo elijo la base de datos de IA adecuada para mi proyecto?

Seleccionar la base de datos de IA correcta depende de sus necesidades específicas. Considere estos factores clave:

  • Tipo de datos: ¿Está trabajando con texto, imágenes, datos tabulares o incrustaciones vectoriales? Elija una base de datos optimizada para su formato de datos principal (p. ej., una base de datos vectorial para incrustaciones).
  • Escala y rendimiento: Estime su volumen de datos y carga de consultas. Asegúrese de que la base de datos pueda escalar para satisfacer sus necesidades futuras y proporcione las respuestas de baja latencia requeridas para su aplicación.
  • Integración del ecosistema: Verifique la compatibilidad con su pila tecnológica existente, incluidos los lenguajes de programación, los frameworks de aprendizaje automático (PyTorch, TensorFlow) y las plataformas de MLOps.
  • Licencias y costo: Para conjuntos de datos públicos, revise cuidadosamente las licencias de uso. Para servicios gestionados, compare los modelos de precios (p. ej., pago por uso, suscripción) y evalúe el costo total de propiedad.

¿Por qué son importantes los conjuntos de datos públicos para el desarrollo de la IA?

Los conjuntos de datos públicos son recursos cruciales que aceleran la investigación y el desarrollo de la IA. Proporcionan una base común para la evaluación comparativa de nuevos modelos, permitiendo a los investigadores comparar resultados de manera justa y objetiva. Para las startups y los equipos más pequeños, estos conjuntos de datos reducen la barrera de entrada al proporcionar acceso a datos etiquetados de alta calidad y a gran escala sin el inmenso costo y tiempo requeridos para la recopilación y anotación de datos. Conjuntos de datos conocidos como ImageNet, COCO y The Pile han sido fundamentales para impulsar avances importantes en la visión por computadora y el procesamiento del lenguaje natural al permitir el entrenamiento de modelos potentes y a gran escala.

¿Quiénes son los principales usuarios de las bases de datos de IA?

Las bases de datos de IA sirven a una gama de profesionales técnicos involucrados en el ciclo de vida del aprendizaje automático. Los usuarios clave incluyen:

  • Científicos de datos: Utilizan conjuntos de datos públicos para análisis exploratorio y prototipado de modelos, y almacenes de características para acceder a datos preprocesados para el entrenamiento.
  • Ingenieros de aprendizaje automático: Se basan en bases de datos vectoriales y almacenes de características para construir y desplegar aplicaciones de IA escalables y en tiempo real, como motores de búsqueda y sistemas de recomendación.
  • Investigadores de IA: Utilizan conjuntos de datos de referencia para evaluar nuevos algoritmos y publicar resultados reproducibles.
  • Ingenieros de MLOps: Gestionan almacenes de características y otra infraestructura de datos para garantizar un pipeline fluido, fiable y automatizado desde el desarrollo del modelo hasta la producción.