ToolMage
Iniciar sesión

AI TOOL COMPARISON

Apify vs Crawlbase

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Apify Resumen del producto

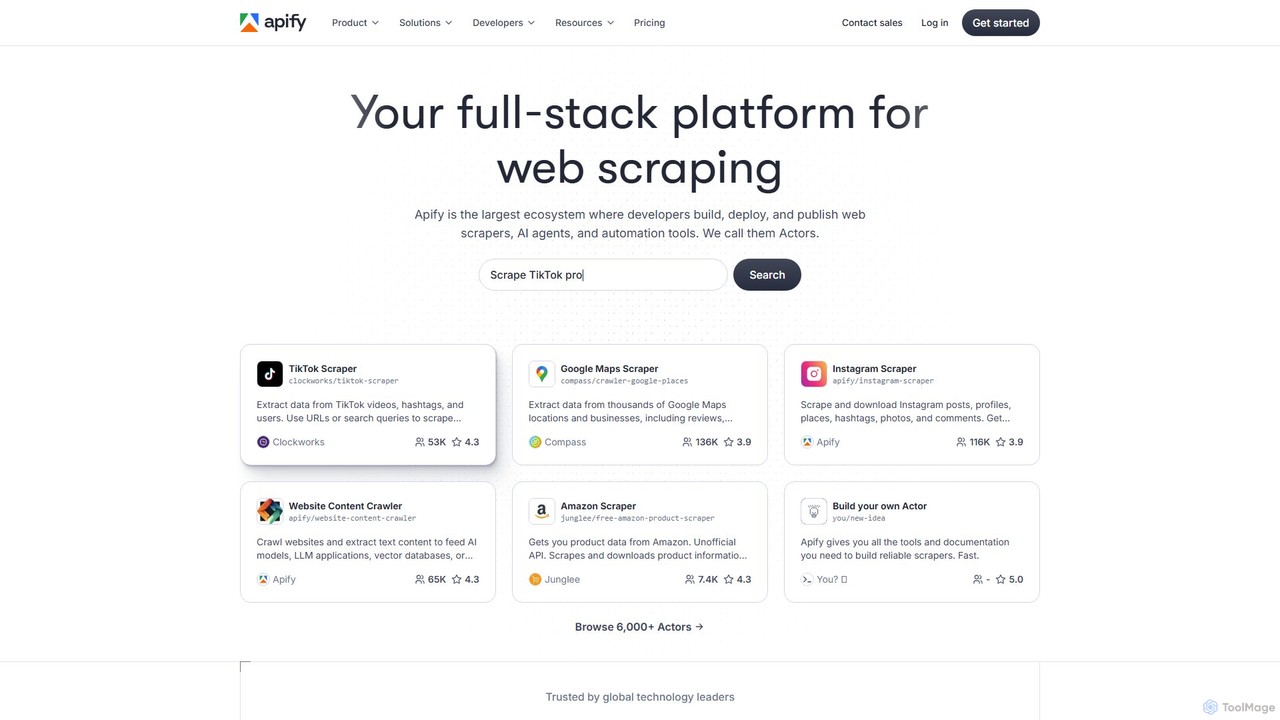
Apify es una plataforma full-stack de web scraping y automatización que permite a los desarrolladores construir, desplegar y publicar herramientas de extracción de datos, conocidas como 'Actors'. Ofrece un vasto mercado de scrapers preconstruidos para sitios web populares como Google Maps, Instagram y TikTok, junto con una robusta infraestructura en la nube para crear soluciones personalizadas. Con soporte para Python y JavaScript, bibliotecas de código abierto e integraciones fluidas, Apify simplifica la recopilación de datos web a cualquier escala.

Preview

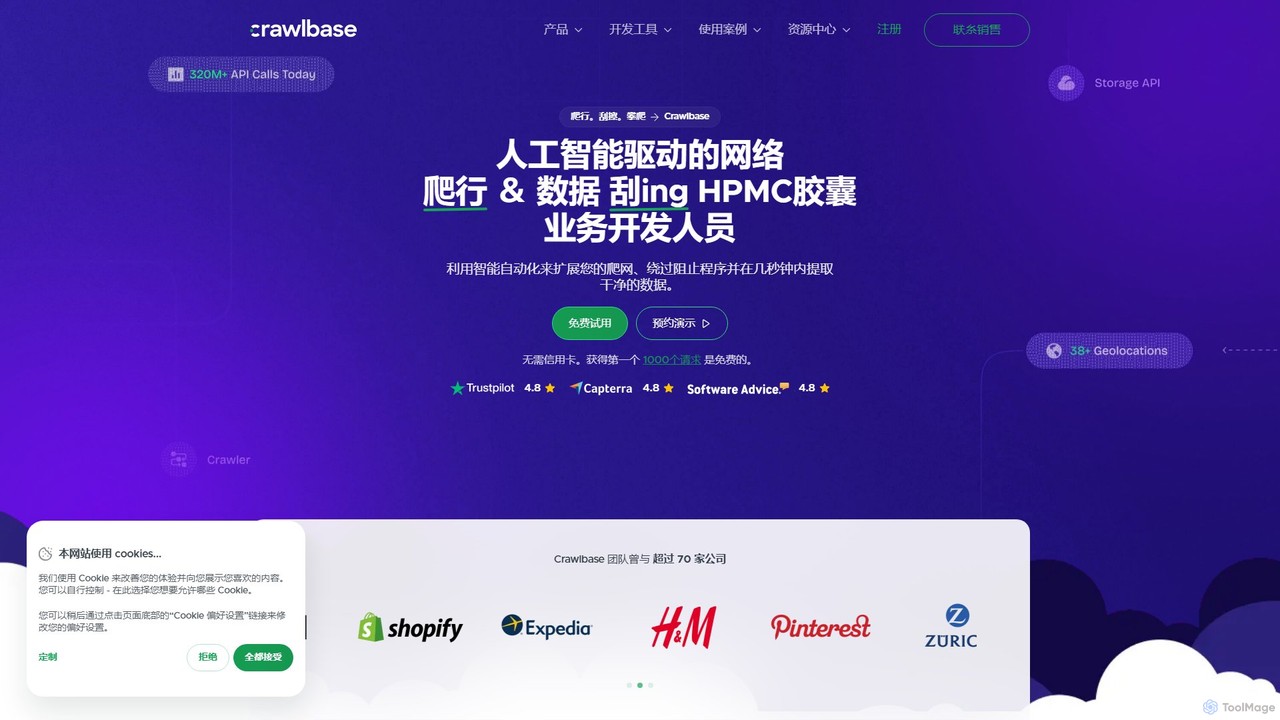
Crawlbase Resumen del producto

Crawlbase es una plataforma de web scraping y crawling impulsada por IA, diseñada para desarrolladores y empresas. Simplifica la extracción de datos manejando proxies, CAPTCHAs y sistemas anti-bot, permitiéndole rastrear anónimamente cualquier sitio web y obtener datos limpios y estructurados a escala. Ofrece un conjunto de herramientas que incluye una API de Crawling, Smart Proxy y Cloud Storage.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Apify VS Crawlbase — Datos clave
Datos claveApifyCrawlbase
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusRecopilación de DatosRecopilación de Datos
Audiencia y rolesSin verificarSin verificar
CategoríasRecopilación de Datos · Extracción de Datos · Web Scraping · AutomatizaciónRecopilación de Datos · Extracción de Datos · Web Scraping · SEO
Added16 ago 202515 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Apify

Apify es una plataforma integral en la nube diseñada para el web scraping, la extracción de datos y la automatización de procesos. Proporciona un ecosistema completo donde los desarrolladores y las empresas pueden construir, desplegar, gestionar y publicar scrapers web y herramientas de automatización, que se denominan 'Actors'. Apify se dirige a una amplia gama de usuarios, desde desarrolladores individuales que necesitan extraer datos para un pequeño proyecto hasta grandes empresas que requieren pipelines de datos fiables y escalables para inteligencia de negocio y aplicaciones de IA.

El núcleo de la plataforma es la Apify Store, un mercado con más de 6,000 Actors preconstruidos para extraer datos de sitios web populares como Google, Instagram, TikTok y Amazon. Esto permite a los usuarios obtener datos estructurados al instante sin escribir ningún código. Para necesidades más específicas, Apify proporciona un potente entorno de desarrollo con todas las herramientas necesarias para construir Actors personalizados desde cero utilizando lenguajes de programación y bibliotecas populares.

Cómo usar Apify

Usar Apify implica un flujo de trabajo sencillo que se puede adaptar a tu nivel de habilidad técnica:

  1. Elige tu método: Puedes seleccionar un 'Actor' ya hecho de la Apify Store para una tarea específica (por ejemplo, 'Google Maps Scraper') o decidir construir tu propio scraper personalizado.
  2. Configura el Actor: Si usas un Actor preconstruido, simplemente proporcionas las entradas necesarias, como URLs, palabras clave de búsqueda o datos de ubicación, a través de una interfaz fácil de usar.
  3. Construye un Actor Personalizado (Opcional): Para necesidades personalizadas, los desarrolladores pueden usar el SDK de Apify con Python o JavaScript (Node.js). La plataforma soporta bibliotecas populares como Crawlee, Playwright, Puppeteer y Scrapy. Puedes escribir tu código localmente y desplegarlo en la nube de Apify.
  4. Ejecuta y Monitorea: Ejecuta tu Actor en la infraestructura en la nube de Apify. La plataforma maneja los proxies, el escalado y los recursos de cómputo automáticamente. Puedes monitorear el progreso de tus trabajos de scraping en tiempo real a través del panel de control.
  5. Accede y Exporta Datos: Una vez que la ejecución se completa, los datos extraídos se almacenan y se pueden ver en varios formatos como JSON, CSV o Excel. Puedes descargar los datos directamente o acceder a ellos a través de la API de Apify.
  6. Integra y Automatiza: Programa tus Actors para que se ejecuten a intervalos regulares para un monitoreo continuo de datos. Integra el flujo de datos con otras aplicaciones y servicios como Zapier, Google Sheets, Pinecone, LangChain o tu propia base de datos.

Características principales de Apify

  • Apify Store: Un vasto mercado con más de 6,000 scrapers web y herramientas de automatización (Actors) preconstruidos para uso inmediato.
  • Plataforma de Desarrollador: Un entorno full-stack para construir, probar y desplegar scrapers personalizados con una robusta infraestructura en la nube, compatible con Python y JavaScript.
  • Bibliotecas de Código Abierto: Integración profunda con potentes bibliotecas de código abierto como Crawlee (propia de Apify), Playwright, Puppeteer, Selenium y Scrapy.
  • Proxies Integrados: Acceso a un gran grupo de proxies de centro de datos y residenciales para gestionar la rotación de IP, evitar bloqueos y asegurar una extracción de datos exitosa.
  • Infraestructura en la Nube Escalable: Escala los recursos automáticamente según la demanda. Los usuarios no necesitan gestionar servidores, almacenamiento o cómputo.
  • Programación y Monitoreo: Herramientas integradas para programar trabajos de scraping para que se ejecuten periódicamente y monitorear su estado, rendimiento y consumo de recursos.
  • Integración de Datos y API: Una potente API para ejecutar Actors y acceder a datos programáticamente, además de integraciones fluidas con herramientas como Zapier, Airbyte, LangChain y LlamaIndex.
  • Soluciones de Datos para IA: Actors especializados como el 'Website Content Crawler' están diseñados para extraer y limpiar contenido de texto para alimentar modelos de IA, bases de datos vectoriales y pipelines RAG.

Casos de uso para Apify

Apify es versátil y se puede utilizar para una amplia gama de tareas basadas en datos:

  • Generación de Leads: Extracción de información de contacto y detalles de negocios de Google Maps, LinkedIn o directorios sectoriales.
  • Análisis de Mercado y Competencia: Extraer precios de productos, reseñas y descripciones de sitios de comercio electrónico como Amazon para monitorear las tendencias del mercado.
  • Inteligencia de Redes Sociales: Recopilación de datos de plataformas como TikTok, Instagram y Twitter para análisis de sentimientos, seguimiento de influencers y monitoreo de campañas.
  • IA y Machine Learning: Rastrear sitios web para recopilar grandes conjuntos de datos de texto e imágenes para entrenar modelos de IA y potenciar sistemas RAG (Generación Aumentada por Recuperación).
  • Monitoreo de Marca: Seguimiento de menciones de una marca, producto o servicio en sitios de noticias, blogs y foros.
  • Agregación de Datos Financieros e Inmobiliarios: Recopilación de datos del mercado de valores, listados de propiedades e información de precios de diversas fuentes.

Ventajas de Apify

Apify se destaca por varias ventajas clave:

  • Solución Todo en Uno: Combina un mercado de herramientas listas para usar con una potente plataforma de desarrollo e infraestructura en la nube gestionada.
  • Eficiencia y Velocidad: Los Actors preconstruidos ahorran cientos de horas de desarrollo, permitiendo a los usuarios obtener datos en minutos.
  • Centrado en el Desarrollador: Soporta los lenguajes y herramientas que los desarrolladores ya conocen y aman, respaldado por una extensa documentación, plantillas de código y una fuerte comunidad.
  • Fiabilidad y Escalabilidad: Construido para un rendimiento a escala, ofreciendo fiabilidad de nivel empresarial con un 99.95% de tiempo de actividad y cumplimiento de SOC2.
  • Oportunidad de Monetización para Desarrolladores: Los desarrolladores pueden publicar sus Actors en la Apify Store y obtener ingresos recurrentes, mientras que Apify se encarga de la facturación, la infraestructura y el marketing.

Precios y planes

Apify opera con un modelo de precios freemium basado en el uso, lo que lo hace accesible para proyectos de todos los tamaños.

  • Plan Gratuito: Incluye una generosa cantidad de créditos de plataforma mensuales gratuitos ($5/mes), que es suficiente para pequeños proyectos, pruebas y aprendizaje. Los nuevos creadores también obtienen un bono de crédito significativo para empezar.
  • Plan Personal ($49/mes): Diseñado para individuos y freelancers, ofrece un mayor conjunto de créditos de plataforma y acceso a más funciones.
  • Plan de Equipo ($499/mes): Dirigido a pequeñas y medianas empresas, este plan incluye aún más créditos, funciones de colaboración, mayor retención de datos y soporte prioritario.
  • Plan Empresarial (Precio Personalizado): Adaptado para grandes organizaciones con necesidades específicas, ofrece cantidades de crédito personalizadas, funciones de seguridad premium (SOC2), soporte dedicado y acuerdos de nivel de servicio (SLAs) personalizados.

Todos los planes operan sobre una base de pago por uso para el uso más allá de los créditos incluidos, cubriendo unidades de cómputo, uso de proxy y almacenamiento de datos.

Crawlbase

Crawlbase es una plataforma integral de extracción de datos impulsada por IA que permite a desarrolladores y empresas acceder a datos web de forma libre y anónima. Construida sobre el principio de 'libertad de datos', Crawlbase proporciona un robusto conjunto de herramientas diseñadas para superar los desafíos comunes del web scraping, como bloqueos de IP, CAPTCHAs y restricciones geográficas. Con una infraestructura masiva de millones de proxies residenciales y de centros de datos rotativos, garantiza altas tasas de éxito y fiabilidad para cualquier proyecto de recolección de datos.

La plataforma está diseñada para la escalabilidad, atendiendo tanto a pequeños proyectos como a necesidades empresariales a gran escala, como lo demuestra su adopción por parte de grandes empresas como Intel. La filosofía central de Crawlbase es simplificar el complejo proceso de web crawling, permitiendo a los usuarios centrarse en el análisis de datos en lugar de la gestión de la infraestructura. Sus capacidades de IA son particularmente útiles para entrenar modelos de lenguaje, ya que la API puede navegar inteligentemente por sitios web, extraer información relevante y entregarla en un formato estructurado y legible por máquina.

Cómo usar Crawlbase

Empezar a usar Crawlbase está diseñado para ser rápido y sencillo, normalmente toma solo unos minutos. Primero, necesita crear una cuenta gratuita en el sitio web de Crawlbase, que no requiere tarjeta de crédito e incluye 1,000 solicitudes gratuitas para comenzar. Una vez registrado, recibirá un token de API. Para usar el servicio, simplemente realiza una llamada de API a uno de los endpoints de Crawlbase, como la API de Crawling o el Smart Proxy. Para la API de Crawling, pasa su token y la URL de destino que desea raspar. La API se encarga de todo el proceso de rotación de proxies, gestión de encabezados y evasión de bloqueos, devolviendo el HTML crudo de la página. Para un uso más avanzado, puede especificar parámetros para la renderización de JavaScript, geolocalización y más.

Características principales de Crawlbase

  • API de Crawling: Una potente API que obtiene el HTML de cualquier página web mientras maneja automáticamente navegadores sin cabeza, rotación de proxies y resolución de CAPTCHAs.
  • Smart Proxy: Una solución de proxy inteligente que le permite enrutar sus solicitudes a través de la vasta red de Crawlbase de más de 140 millones de proxies residenciales y de centros de datos, asegurando un alto anonimato y tasas de éxito.
  • Extracción de Datos con IA: Aprovecha la IA avanzada para analizar HTML crudo y extraer datos limpios y estructurados en formato JSON, ideal para alimentar bases de datos o entrenar modelos de machine learning.
  • Crawler a Gran Escala: Una solución dedicada para proyectos masivos de extracción de datos, diseñada para entregar grandes volúmenes de datos directamente a sus servidores de manera eficiente.
  • Cloud Storage: Una solución de almacenamiento en la nube segura y conveniente, diseñada específicamente para almacenar los datos que ha rastreado, simplificando su pipeline de datos.
  • Red Global de Proxies: Acceso a un enorme grupo de proxies de numerosos países, lo que permite una geolocalización precisa y la elusión de restricciones regionales.
  • Garantía de Uptime: Presume de una garantía de tiempo de actividad del 99.99%, asegurando que sus procesos de recolección de datos se ejecuten sin interrupciones.

Casos de uso para Crawlbase

Crawlbase es versátil y se puede aplicar a una amplia gama de tareas basadas en datos. Para las empresas de comercio electrónico, se utiliza para la inteligencia de precios, el seguimiento de los precios de la competencia y el seguimiento de la disponibilidad de productos. En marketing, es esencial para el monitoreo de SEO, el seguimiento de las clasificaciones de palabras clave y la recopilación de datos de investigación de mercado. Las instituciones financieras lo utilizan para agregar datos financieros de diversas fuentes para análisis y comercio. Un caso de uso significativo es en el campo de la inteligencia artificial, donde las empresas utilizan Crawlbase para recopilar vastos conjuntos de datos de la web para entrenar grandes modelos de lenguaje (LLM) y otros sistemas de IA. También se utiliza para la generación de leads, la agregación de datos inmobiliarios y la investigación académica.

Ventajas de Crawlbase

La principal ventaja de Crawlbase es su capacidad para abstraer las complejidades del web scraping. Los usuarios ya no necesitan gestionar su propia infraestructura de proxies, lidiar con la rotación de direcciones IP o desarrollar soluciones para eludir sofisticadas medidas anti-bot. Esto se traduce en un ahorro significativo de tiempo, recursos de desarrollo y costos operativos. Su alta escalabilidad garantiza que pueda crecer con sus necesidades, desde unos pocos miles de solicitudes hasta miles de millones. El soporte experto 24/7 proporciona asistencia fiable, y su compromiso con el cumplimiento de GDPR y CCPA ofrece tranquilidad. El enfoque innovador de la plataforma y su fiabilidad probada la han convertido en un líder en el mercado de la extracción de datos.

Precios y planes

Crawlbase opera con un modelo freemium. Los nuevos usuarios pueden registrarse para una prueba gratuita que incluye 1,000 solicitudes exitosas sin necesidad de una tarjeta de crédito. Esto permite realizar pruebas exhaustivas de las capacidades de la API. Después de la prueba, Crawlbase ofrece una variedad de planes de pago que se basan en el número de solicitudes y las características específicas requeridas. Los planes están diseñados para ser flexibles y atender a una amplia gama de usuarios, desde desarrolladores individuales hasta grandes empresas. Para obtener información detallada y actualizada sobre los precios, se recomienda visitar el sitio web oficial de Crawlbase.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de DatosWeb Scraping
Solo Apify
Recopilación de DatosAutomatización
Solo Crawlbase
Recopilación de DatosSEO

Etiquetas

Compartido
APIExtracción de datosminería de datosHerramientas para desarrolladoresWeb scraping
Solo Apify
Datos de IAautomatizaciónJavaScriptGeneración de leadsPythonGeneración Aumentada por Recuperaciónrastreador web
Solo Crawlbase
IARastreoRecopilación de datosinvestigación de mercadoProxySEO

Audiencia y roles

Compartido
No hay datos verificados
Solo Apify
No hay datos verificados
Solo Crawlbase
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Apify monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
4.4M
Duración media
4:48
Páginas por visita
7.65
Tasa de rebote
36.29%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 1.9M
  • 2026-01: 2.5M
  • 2026-02: 2.5M
  • 2026-03: 3.8M
  • 2026-04: 4.1M
  • 2026-05: 4.4M

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States40.31%1.8M
🇮🇳India31.99%1.4M
🇧🇷Brazil10.35%457.4K
🇬🇧United Kingdom8.77%387.5K
🇩🇪Germany8.58%379.1K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo84.73%3.7M
Referido11.9%525.9K
Correo electrónico3.37%148.9K

Palabras clave

apifyepornerfacebookthisvidxvideos

Crawlbase monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
131
Duración media
1:47
Páginas por visita
3
Tasa de rebote
2.77%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.8K
  • 2026-01: 707
  • 2026-02: 551
  • 2026-03: 236
  • 2026-04: 532
  • 2026-05: 131

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇹🇼Taiwan100%131

Palabras clave

agoda 酒店搜索数据爬取crawlbasecrawlbase apiscrapingbotscrapireddit

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Apify

Valoración
Sin verificar
Comentarios
0
Favoritos
156
Me gusta
173

Crawlbase

Valoración
Sin verificar
Comentarios
0
Favoritos
161
Me gusta
166

Apify vs Crawlbase · Preguntas frecuentes

What do Apify and Crawlbase have in common?
Both tools are listed under Extracción de Datos、Web Scraping. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Apify and Crawlbase free?
Listed pricing models: Apify — Freemium; Crawlbase — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Apify and Crawlbase?
The primary listed category is Recopilación de Datos for Apify, and Recopilación de Datos for Crawlbase. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas