ToolMage
Iniciar sesión

AI TOOL COMPARISON

Bright Data vs Crawly

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

Bright Data Resumen del producto

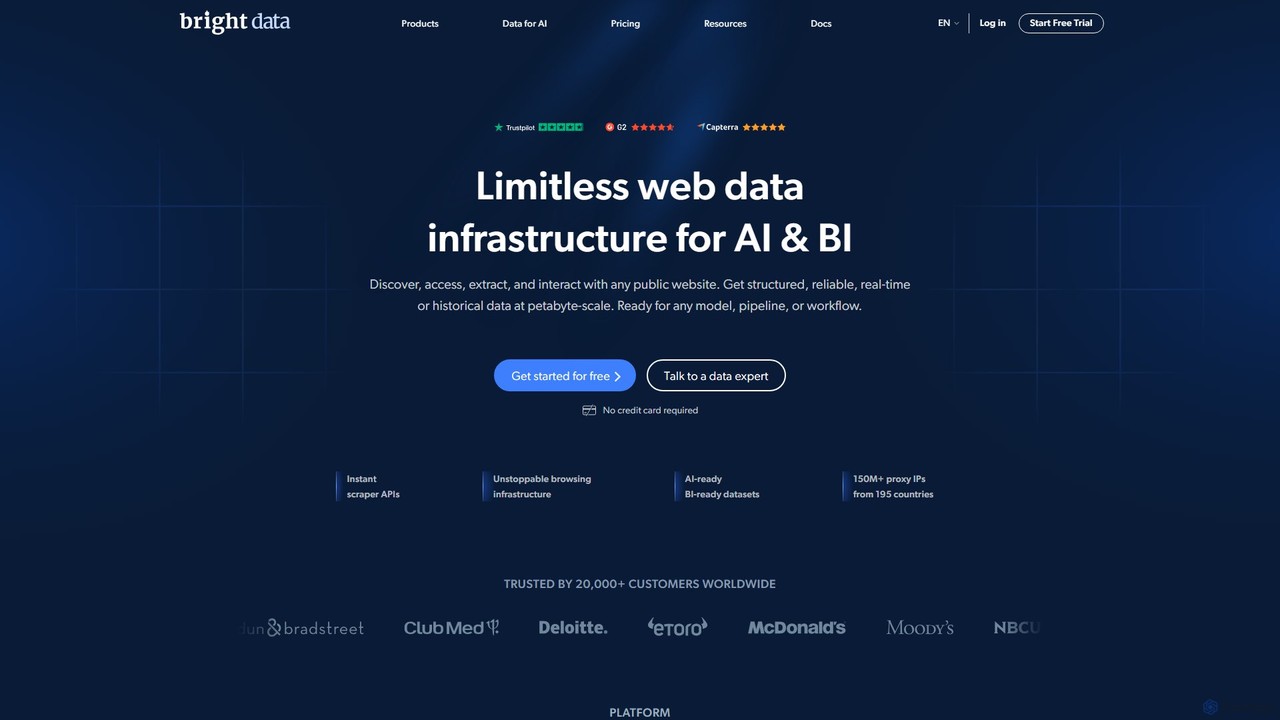
Bright Data es la plataforma de datos web líder en el mundo, que ofrece un conjunto completo de herramientas que incluyen redes de proxy, raspadores web impulsados por IA y conjuntos de datos listos para usar. Permite a las empresas recopilar grandes cantidades de datos web públicos para el entrenamiento de IA, la investigación de mercado y la inteligencia competitiva.

Preview

Crawly Resumen del producto

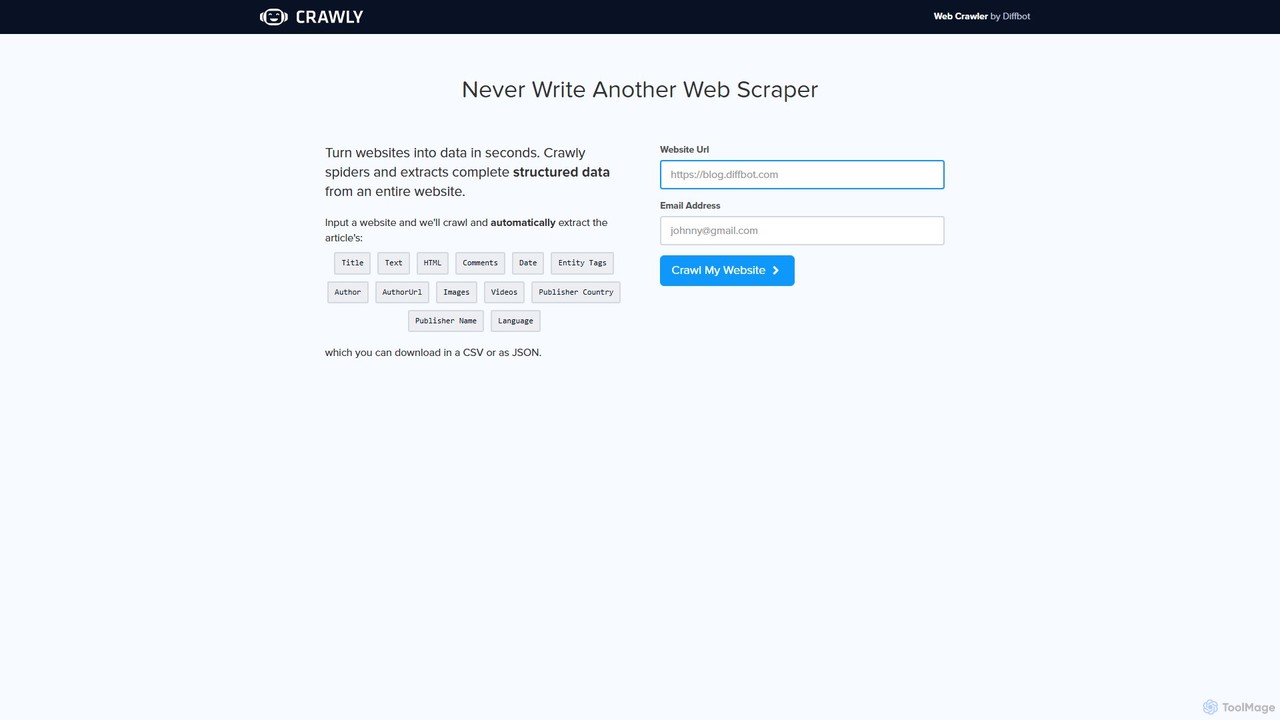
Crawly es un rastreador web impulsado por IA de Diffbot que extrae automáticamente datos estructurados de sitios web completos. Simplemente introduce una URL y Crawly rastrea el sitio para obtener información clave como artículos, productos y discusiones, convirtiéndola en datos limpios en JSON o CSV sin necesidad de codificar.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

Bright Data VS Crawly — Datos clave
Datos claveBright DataCrawly
Pricing modelPaidFreemium
Product typeWebWeb
Primary focusInteligencia de NegocioExtracción de Datos Web
Audiencia y rolesSin verificarSin verificar
CategoríasInteligencia de Negocio · Extracción de Datos Web · API · Investigación de MercadoExtracción de Datos Web · API · Investigación de Mercado · Automatización
Added12 ago 202510 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

Bright Data

Bright Data se erige como la plataforma de datos web número 1 del mundo, con la confianza de más de 20,000 organizaciones en casi todas las industrias. Proporciona una solución robusta y todo en uno para descubrir, acceder y extraer datos web públicos a cualquier escala. Ya sea que necesite datos en tiempo real o históricos, la infraestructura de Bright Data está diseñada para ofrecer información estructurada y confiable, lista para cualquier modelo, canalización o flujo de trabajo. La plataforma está diseñada para impulsar el desarrollo de la IA, potenciar la investigación de mercado, monitorear activos en línea y permitir la toma de decisiones basada en datos.

Cómo usar Bright Data

Bright Data ofrece una plataforma flexible que se puede utilizar de varias maneras según sus necesidades:

  1. Redes de Proxy: Integre las galardonadas redes de proxy de Bright Data (Residencial, ISP, Centro de Datos y Móvil) en sus scripts o aplicaciones de recopilación de datos existentes. Esto le permite enrutar sus solicitudes a través de millones de IP de usuarios reales, eludiendo las restricciones geográficas y evitando bloqueos para acceder a cualquier sitio web público de forma anónima y exitosa.
  2. Web Scraper IDE: Para aquellos que desean construir raspadores personalizados, el Web Scraper IDE proporciona un entorno potente con funciones y plantillas preconstruidas. Puede desarrollar, ejecutar y gestionar sus raspadores web sin tener que lidiar con la infraestructura de proxy subyacente, el escalado o los bloqueos.
  3. Mercado de Conjuntos de Datos: La forma más fácil de comenzar es accediendo al Mercado de Conjuntos de Datos. Puede comprar conjuntos de datos estructurados y listos para usar de cientos de sitios web populares como Amazon, LinkedIn, Zillow e Instagram. Los datos se pueden descargar como una compra única o a través de una suscripción para actualizaciones periódicas.
  4. API de Conjuntos de Datos: Para el acceso programático, la API de Conjuntos de Datos le permite definir, solicitar y recuperar colecciones de datos personalizadas. El flujo de trabajo generalmente implica: 1) Solicitar una colección definiendo sus sitios y puntos de datos de destino. 2) Comprobar el estado del trabajo de recopilación. 3) Iniciar la recopilación para recibir los datos en su formato preferido (JSON, CSV, Parquet).

Características principales de Bright Data

  • Redes de Proxy Completas: Acceso a más de 72 millones de IP en redes Residenciales, de Centros de Datos, ISP y Móviles en 195 países.
  • Raspado Web con IA: Raspadores web avanzados y un Scraper IDE que pueden manejar sitios web complejos y con mucho JavaScript, resolver CAPTCHAs y gestionar las huellas dactilares del navegador automáticamente.
  • Vasto Mercado de Conjuntos de Datos: Un catálogo masivo de conjuntos de datos pre-recopilados y validados de los principales sitios web de comercio electrónico, redes sociales, bienes raíces e inteligencia empresarial.
  • Escalabilidad y Rendimiento: Infraestructura construida para manejar petabytes de datos, asegurando altas tasas de éxito y tiempo de actividad para proyectos de recopilación de datos a gran escala.
  • Cumplimiento y Ética de Datos: Cumplimiento líder en la industria con leyes de protección de datos como GDPR y CCPA, garantizando una recopilación de datos ética y responsable.
  • Entrega Flexible de Datos: Entrega datos limpios y estructurados en varios formatos, incluyendo JSON, CSV y Parquet, listos para un análisis inmediato o entrenamiento de modelos.
  • Servicios Gestionados: Para las empresas que prefieren un enfoque sin intervención, Bright Data ofrece servicios de datos totalmente gestionados donde sus expertos se encargan de todo el proceso de recopilación de datos por usted.

Casos de uso para Bright Data

Las soluciones de Bright Data son versátiles y se adaptan a una amplia gama de aplicaciones:

  • IA y Aprendizaje Automático: Recopile conjuntos de datos de alta calidad y a gran escala de toda la web para entrenar y validar modelos de aprendizaje automático.
  • Inteligencia de Comercio Electrónico y Minorista: Monitoree los precios de la competencia, rastree la disponibilidad de productos, agregue datos de productos y analice las reseñas de los clientes para optimizar la estrategia.
  • Investigación de Mercado: Analice las tendencias del mercado, rastree el sentimiento de la marca y realice un análisis exhaustivo de la competencia recopilando datos de sitios de noticias, foros y redes sociales.
  • Servicios Financieros: Recopile datos alternativos de fuentes públicas para el análisis de inversiones, la evaluación de riesgos y el modelado financiero.
  • Protección de Marca: Escanee la web en busca de infracciones de propiedad intelectual, productos falsificados y uso no autorizado de los activos de la marca.

Ventajas de Bright Data

Elegir Bright Data proporciona una ventaja competitiva significativa. Su plataforma todo en uno consolida la necesidad de múltiples proveedores al ofrecer proxies, raspadores y conjuntos de datos bajo un mismo techo. La calidad y fiabilidad de los datos son inigualables, gracias a los robustos procesos de validación. La inmensa escala y el alcance global de la plataforma significan que ningún objetivo está fuera de su alcance. De manera crucial, el fuerte compromiso de Bright Data con la recopilación de datos ética y conforme a la ley proporciona tranquilidad a las empresas que operan en un panorama regulatorio complejo. Sus herramientas amigables para los desarrolladores y su soporte dedicado aseguran una experiencia fluida desde la incorporación hasta la producción.

Precios y planes

Bright Data ofrece un modelo de precios flexible de pago por uso, así como planes de suscripción mensuales y anuales adaptados a diferentes necesidades y escalas.

  • Redes de Proxy: El precio se basa típicamente en el tráfico (por GB) o por IP, con diferentes tarifas para proxies de Centro de Datos, Residenciales, ISP y Móviles. Los planes van desde paquetes de inicio hasta grandes compromisos empresariales.
  • Web Scraper IDE: El precio se basa en el uso, a menudo calculado por el número de solicitudes exitosas (CPM).
  • Mercado de Conjuntos de Datos: Los conjuntos de datos se pueden adquirir a través de una compra única o un modelo de suscripción (mensual, trimestral, semestral) que ofrece descuentos significativos. El precio se calcula por registro (por ejemplo, a partir de $2.5 por 1,000 registros), con costos que varían según la complejidad y la frecuencia de actualización de los datos.
  • Planes de Soporte: Se incluye un plan de soporte Estándar para todos los clientes. Para un servicio mejorado, están disponibles los planes Premium y Enterprise, que ofrecen soporte 24/7, gerentes de cuenta dedicados y respuestas priorizadas. El plan Premium cuesta el 8% de la factura mensual (mín. $500/mes), mientras que el plan Enterprise cuesta $10,000/mes.

Para obtener precios detallados y personalizados, se recomienda contactar al equipo de ventas de Bright Data o visitar su página oficial de precios.

Crawly

Crawly es un potente e inteligente rastreador web desarrollado por Diffbot, líder en la extracción de datos impulsada por IA. Está diseñado para eliminar por completo los desafíos manuales y técnicos del web scraping. En lugar de escribir código complejo o usar selectores frágiles que se rompen con las actualizaciones del sitio web, Crawly aprovecha la inteligencia artificial avanzada, incluyendo la visión por computadora y el procesamiento del lenguaje natural, para entender e interpretar las páginas web como lo haría un humano. Esto le permite identificar y extraer automáticamente datos completos y estructurados de un sitio web entero con solo una URL como entrada.

La promesa central de Crawly es 'convertir sitios web en datos en segundos'. Navega a través de un sitio web, siguiendo enlaces y analizando la estructura de cada página para diferenciar entre varios tipos de contenido como artículos, productos, discusiones y galerías de imágenes. Los datos extraídos se organizan luego en un formato limpio y estructurado, listo para su uso inmediato en aplicaciones, análisis de datos o modelos de aprendizaje automático.

Cómo usar Crawly

Usar Crawly está diseñado para ser increíblemente simple y accesible para todos, independientemente de su habilidad técnica. El proceso implica solo unos pocos pasos:

  1. Introducir URL: Navega al sitio web de Crawly. En el campo de entrada proporcionado, introduce la URL completa del sitio web que deseas rastrear.
  2. Proporcionar correo electrónico: Introduce tu dirección de correo electrónico. Se utiliza para notificarte y entregarte los resultados una vez que el rastreo esté completo.
  3. Iniciar rastreo: Haz clic en el botón 'Crawl My Website'. El motor de IA de Crawly comenzará a rastrear todo el sitio, analizando páginas y extrayendo información.
  4. Descargar datos: Una vez que el proceso haya finalizado, recibirás los datos extraídos. Puedes descargarlos en formatos convenientes y estructurados como JSON o CSV, lo que facilita su importación a bases de datos, hojas de cálculo u otro software.

Características principales de Crawly

  • Extracción automática impulsada por IA: Utiliza la IA avanzada de Diffbot para reconocer y extraer automáticamente datos de artículos, productos, discusiones y más, sin ninguna configuración manual.
  • Campos de datos completos: Extrae un rico conjunto de puntos de datos, incluyendo Título, Texto, HTML, Comentarios, Fecha, Autor, URL del Autor, Imágenes, Videos, Información del Editor (País, Nombre) e Idioma.
  • Reconocimiento de entidades: Identifica y etiqueta automáticamente entidades dentro del texto, como personas, organizaciones y lugares, añadiendo otra capa de metadatos valiosos.
  • Rastreo de sitio completo: A diferencia de los raspadores de una sola página, Crawly navega por un sitio web completo para recopilar datos de manera exhaustiva.
  • Salida de datos estructurados: Entrega datos limpios y bien estructurados en formatos JSON o CSV, eliminando la necesidad de post-procesamiento y limpieza de datos.
  • Solución sin código: No requiere habilidades de programación ni conocimientos de tecnologías de web scraping, lo que lo hace accesible para especialistas en marketing, investigadores y analistas de negocios.
  • Robusto y resiliente: Debido a que entiende la estructura semántica del contenido, no se rompe fácilmente con los cambios de diseño del sitio web, un problema común con los raspadores tradicionales.

Casos de uso para Crawly

Crawly es una herramienta versátil adecuada para una amplia gama de aplicaciones:

  • Investigación de mercado: Recopila automáticamente información de productos de la competencia, precios, reseñas de clientes y menciones en noticias para obtener una ventaja competitiva.
  • Generación de leads: Extrae detalles de contacto, información de la empresa y personal clave de sitios web corporativos y directorios en línea.
  • Agregación de contenido: Construye un feed de noticias personalizado o una plataforma de contenido agregando artículos, publicaciones de blog y videos de múltiples fuentes.
  • Datos para aprendizaje automático: Crea grandes conjuntos de datos de alta calidad para entrenar modelos de aprendizaje automático, como el análisis de sentimientos en reseñas de productos o el análisis de tendencias a partir de artículos de noticias.
  • Monitoreo de marca: Realiza un seguimiento de cómo se menciona tu marca, productos o ejecutivos en la web en tiempo real.

Ventajas de Crawly

La principal ventaja de Crawly es su simplicidad y potencia. Democratiza la extracción de datos web, permitiendo a los no desarrolladores realizar tareas que normalmente requerirían un equipo de ingenieros. Ahorra inmensas cantidades de tiempo y recursos al automatizar todo el proceso de scraping. Además, su enfoque impulsado por la IA garantiza una mayor precisión y una mayor resiliencia que los métodos tradicionales, proporcionando un flujo confiable de datos de alta calidad. Al ser un producto de Diffbot, está respaldado por tecnología de nivel empresarial en la que confían las principales corporaciones de todo el mundo.

Precios y planes

Crawly ofrece un rastreo de prueba gratuito directamente desde su página de inicio, permitiendo a los usuarios probar sus capacidades introduciendo una URL y una dirección de correo electrónico. Esto está diseñado para proporcionar una muestra de los datos estructurados que la herramienta puede producir. Para necesidades más extensas, como el rastreo a gran escala, la extracción frecuente de datos o el acceso a la API para uso programático, los usuarios normalmente se suscribirían al conjunto completo de herramientas ofrecido por su empresa matriz, Diffbot. Los precios de Diffbot son escalonados, con planes disponibles para startups, empresas y grandes corporaciones, que ofrecen diferentes niveles de llamadas a la API y características.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de Datos WebAPIInvestigación de Mercado
Solo Bright Data
Inteligencia de Negocio
Solo Crawly
Automatización

Etiquetas

Compartido
APIExtracción de datosinvestigación de mercadodatos estructuradosWeb scraping
Solo Bright Data
Datos de entrenamiento de IAdatos alternativosRecopilación de datosDatos de e-commerceProxy
Solo Crawly
automatizaciónDiffbotJSONGeneración de leadsNo-coderastreador web

Audiencia y roles

Compartido
No hay datos verificados
Solo Bright Data
No hay datos verificados
Solo Crawly
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

Bright Data monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
810.9K
Duración media
3:21
Páginas por visita
4.77
Tasa de rebote
42.51%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 771K
  • 2026-01: 735.5K
  • 2026-02: 714.5K
  • 2026-03: 830.2K
  • 2026-04: 833K
  • 2026-05: 810.9K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States46.92%380.5K
🇨🇳China21.71%176.1K
🇮🇳India13.14%106.6K
🇬🇧United Kingdom10.78%87.4K
🇻🇳Vietnam7.45%60.4K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo86.27%699.6K
Referido10.39%84.3K
Correo electrónico3.34%27.1K

Palabras clave

apifybright databrightdatasnapchatwayback machine

Crawly monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
1.8K
Duración media
0:31
Páginas por visita
1.15
Tasa de rebote
93.85%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 2.6K
  • 2026-01: 784
  • 2026-02: 640
  • 2026-03: 1K
  • 2026-04: 475
  • 2026-05: 1.8K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇳🇬Nigeria82.43%1.5K
🇩🇪Germany9.9%177
🇨🇦Canada7.67%137

Palabras clave

crawl urlcrawlyonline web crawlerwebsite crawlerwebsite crawler online

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

Bright Data

Valoración
Sin verificar
Comentarios
0
Favoritos
140
Me gusta
156

Crawly

Valoración
Sin verificar
Comentarios
0
Favoritos
162
Me gusta
160

Bright Data vs Crawly · Preguntas frecuentes

What do Bright Data and Crawly have in common?
Both tools are listed under Extracción de Datos Web、API、Investigación de Mercado. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are Bright Data and Crawly free?
Listed pricing models: Bright Data — Paid; Crawly — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between Bright Data and Crawly?
The primary listed category is Inteligencia de Negocio for Bright Data, and Extracción de Datos Web for Crawly. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.

  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas