ToolMage
Iniciar sesión

AI TOOL COMPARISON

dstack vs Hopsworks

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

dstack Resumen del producto

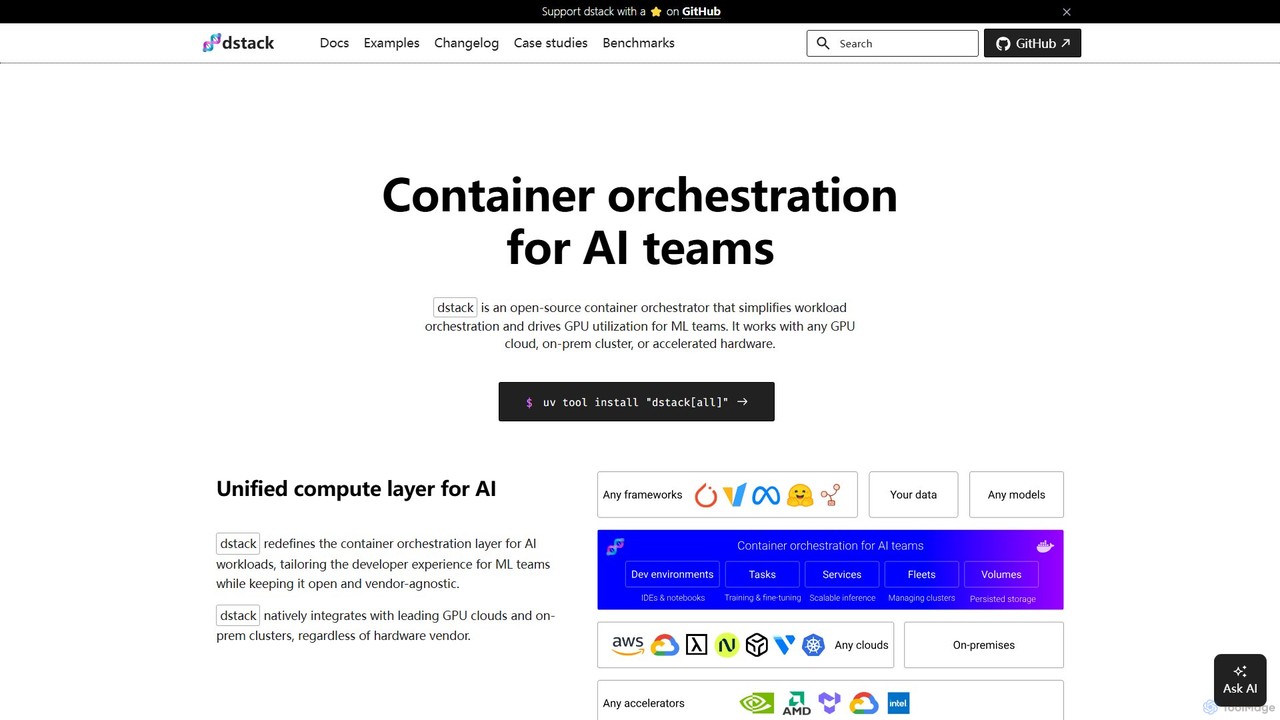
dstack es un orquestador de contenedores de código abierto diseñado para equipos de IA y ML. Simplifica la orquestación de cargas de trabajo y maximiza la utilización de GPU en cualquier proveedor de nube, clúster local o hardware acelerado. Proporciona una capa de cómputo unificada, agilizando el desarrollo, entrenamiento y despliegue de modelos.

Preview

Hopsworks Resumen del producto

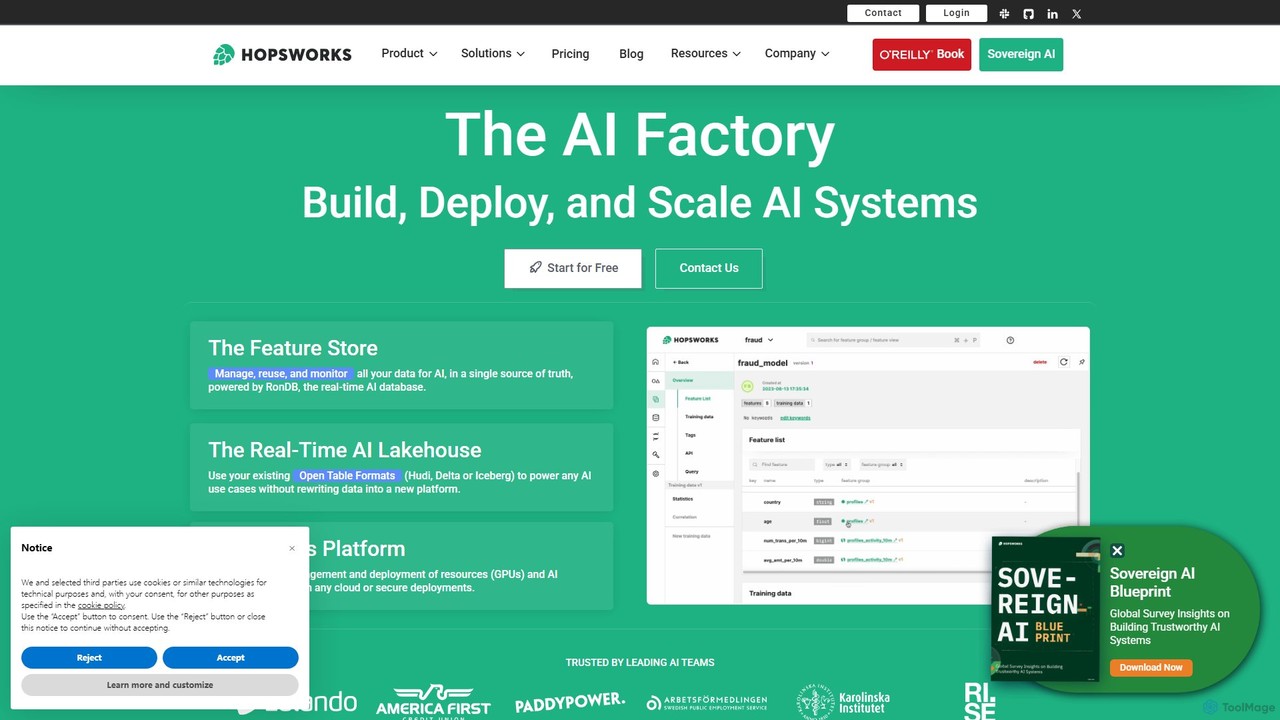
Hopsworks es un AI Lakehouse en tiempo real y el Feature Store más avanzado de la industria. Está diseñado para MLOps, unificando datos y computación para construir y operar sistemas de IA fiables y en tiempo real. Soporta cualquier framework, nube o entorno on-premise, permitiendo un desarrollo de modelos más rápido y una reducción de costes significativa.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

dstack VS Hopsworks — Datos clave
Datos clavedstackHopsworks
Pricing modelFreemiumFreemium
Product typeWebWeb
Primary focusOrquestaciónBase de datos
Audiencia y rolesSin verificarSin verificar
CategoríasOrquestación · MLOps · Gestión de InfraestructuraBase de datos · MLOps · Computación en la Nube
Added8 ago 202510 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

dstack

dstack es un potente orquestador de contenedores de código abierto diseñado específicamente para abordar los desafíos que enfrentan los equipos de Inteligencia Artificial y Machine Learning. Su objetivo principal es simplificar el complejo proceso de orquestación de cargas de trabajo y mejorar significativamente la utilización de los costosos recursos de GPU. Como plataforma agnóstica de proveedores, dstack ofrece una capa de cómputo unificada que se integra sin problemas con cualquier nube de GPU (como AWS, GCP, Azure, OCI), clústeres locales y una amplia gama de hardware acelerado, incluyendo NVIDIA, AMD, TPU y más. Esta flexibilidad garantiza que los equipos no estén atados a un solo proveedor y puedan aprovechar el mejor hardware para sus necesidades, dondequiera que se encuentre.

La plataforma está diseñada con la experiencia del desarrollador en su núcleo, abstrayendo las complejidades de la infraestructura subyacente. Esto permite a los ingenieros de ML y a los investigadores centrarse en construir, entrenar y desplegar modelos en lugar de gestionar servidores, dependencias y escalado. dstack cuenta con la confianza de equipos de ML de clase mundial en empresas como Electronic Arts y Mobius Labs por su capacidad para escalar desde la creación rápida de prototipos hasta grandes trabajos de entrenamiento distribuido de múltiples nodos.

Cómo usar dstack

Empezar con dstack es un proceso sencillo diseñado para una adopción rápida:

  1. Configurar el Servidor: Puedes empezar instalando el servidor dstack en tu máquina local con un simple comando como uv tool install "dstack[all]" y ejecutarlo con dstack server. Alternativamente, puedes desplegarlo en cualquier lugar usando la imagen oficial de Docker o registrarte en dstack Sky, la versión gestionada en la nube, para evitar alojarlo tú mismo.
  2. Definir Configuraciones: Los flujos de trabajo en dstack se definen mediante sencillos archivos YAML dentro de tu repositorio de proyecto. Estas configuraciones describen el entorno, los recursos y los comandos para tus tareas. Los tipos de configuración clave incluyen:
    • Entornos de Desarrollo (Dev Environments): Para el desarrollo interactivo, permitiéndote conectar tu IDE local (como VS Code) a una potente máquina GPU remota.
    • Tareas (Tasks): Para programar trabajos por lotes, como el pre-entrenamiento o el ajuste fino de modelos. Es ideal para cargas de trabajo que se ejecutan hasta su finalización.
    • Servicios (Services): Para desplegar modelos como puntos finales seguros, con autoescalado y compatibles con OpenAI.
    • Flotas (Fleets): Para gestionar grupos de instancias en la nube o locales como un único pool de recursos.
  3. Aplicar Configuraciones: Una vez que tu archivo YAML está listo, lo aplicas usando la interfaz de línea de comandos: dstack apply. dstack se encarga del resto: aprovisionamiento de la infraestructura necesaria, programación del trabajo, gestión del autoescalado, manejo del reenvío de puertos y transmisión de los registros a tu terminal. Para una ejecución desacoplada, puedes usar la bandera -d.

Características principales de dstack

  • Capa de Cómputo Unificada: Proporciona un único plano de control agnóstico de proveedores para todos tus recursos de cómputo de IA, ya sea en la nube o en las instalaciones.
  • Amplio Soporte de Aceleradores: Soporta de forma nativa una amplia gama de hardware, incluyendo GPUs de NVIDIA, GPUs de AMD, TPUs de Google Cloud, Intel Gaudi y aceleradores Tenstorrent.
  • Flujos de Trabajo Centrados en el Desarrollador: Ofrece configuraciones especializadas como Entornos de Desarrollo para codificación interactiva, Tareas para procesamiento por lotes y Servicios para un fácil despliegue de modelos.
  • Gestión Eficiente de Recursos: Cuenta con un planificador integrado para maximizar la utilización de la GPU. Incluye políticas para terminar automáticamente las instancias subutilizadas, ahorrando costos.
  • Integración Perfecta: Funciona sin problemas con las principales nubes de GPU (AWS, GCP, Azure, OCI) y puede ejecutarse sobre clústeres de Kubernetes existentes. Las flotas SSH permiten conectar servidores bare-metal.
  • Servicios de Autoescalado: Despliega fácilmente modelos como servicios listos para producción con características como autoescalado, HTTPS y puntos finales de API compatibles con OpenAI.
  • Persistencia de Datos: Soporta volúmenes de red y de instancia para persistir datos, modelos y cachés a través de las ejecuciones, asegurando que el estado no se pierda.
  • Configuración Avanzada: Permite un control detallado con características como políticas de reintento para problemas de capacidad, gestión de variables de entorno y soporte para imágenes de Docker personalizadas.

Casos de uso para dstack

dstack es versátil y soporta una amplia gama de flujos de trabajo de ML:

  • Entrenamiento y Ajuste Fino de Modelos: Ejecuta trabajos de entrenamiento de un solo nodo o distribuidos para grandes modelos de lenguaje (LLM) utilizando frameworks populares como TRL, Axolotl y DeepSpeed.
  • Inferencia y Servicio de Modelos: Despliega modelos optimizados para la inferencia utilizando frameworks de servicio de alto rendimiento como vLLM, SGLang, TGI y NVIDIA NIM.
  • Desarrollo Interactivo de IA: Los ingenieros de ML pueden levantar potentes entornos de desarrollo respaldados por GPU en segundos, conectando su IDE local para experimentar y depurar código de forma interactiva.
  • Gestión de Clústeres de Alto Rendimiento: Configura y ejecuta pruebas (p. ej., pruebas NCCL) en clústeres especializados de múltiples nodos como GCP A3 Mega o instancias habilitadas para AWS EFA.
  • Optimización de Costos entre Nubes: Compara y utiliza sin esfuerzo las instancias de GPU más rentables entre diferentes proveedores de nube para cualquier tarea.

Ventajas de dstack

La principal ventaja de dstack es su capacidad para simplificar drásticamente la infraestructura de IA. Empodera a los equipos de ML permitiéndoles centrarse en su investigación y modelos en lugar de en la infraestructura. Los beneficios clave incluyen un aumento de la productividad, un ahorro significativo de costos a través de una mejor utilización de la GPU y el acceso a instancias spot, y la prevención del bloqueo de proveedores (vendor lock-in). Su naturaleza de código abierto fomenta la transparencia y el desarrollo impulsado por la comunidad, mientras que el diseño centrado en el desarrollador hace que sea increíblemente fácil definir una configuración y ejecutarla sin preocuparse por la disponibilidad de la GPU o configuraciones complejas.

Precios y planes

dstack ofrece una estructura de precios flexible para adaptarse a diferentes necesidades:

  • dstack (Código Abierto): La plataforma principal es de código abierto y de uso gratuito. Puedes auto-alojarla en tu propia infraestructura sin ninguna tarifa de licencia.
  • dstack Sky: Un servicio en la nube gestionado que se encarga del alojamiento del servidor dstack por ti. También proporciona acceso a un mercado de las GPUs más baratas. Ofrece un nivel gratuito para empezar.
  • dstack Enterprise: Una versión auto-alojada diseñada para organizaciones más grandes, que incluye características de nivel empresarial como Inicio de Sesión Único (SSO), controles de gobernanza avanzados y soporte empresarial dedicado. Se puede solicitar una prueba para esta versión.

Este modelo hace que dstack sea accesible para investigadores individuales, startups y grandes empresas por igual.

Hopsworks

Hopsworks es una plataforma integral de AI Lakehouse en tiempo real diseñada para agilizar todo el ciclo de vida del aprendizaje automático, desde la preparación de datos hasta la implementación y monitorización de modelos. Sirve como un centro neurálgico para científicos de datos, ingenieros de datos e ingenieros de ML, proporcionando un entorno unificado para gestionar datos, características, modelos y recursos de computación. En su núcleo, Hopsworks integra un potente Feature Store con una infraestructura de datos escalable, permitiendo a las organizaciones construir y operar aplicaciones de IA de alto rendimiento y en tiempo real con una eficiencia y gobernanza sin precedentes.

La plataforma está construida sobre una arquitectura modular y abierta, lo que permite una integración perfecta con los ecosistemas de datos existentes. Unifica su lago de datos, almacén de datos y bases de datos en un AI Lakehouse cohesivo, soportando formatos de datos populares como Delta Lake, Apache Hudi y Apache Iceberg. Esta unificación elimina los silos de datos y simplifica el acceso a los datos para las cargas de trabajo de ML. Impulsado por RonDB, un almacén de clave-valor de código abierto de alto rendimiento, Hopsworks ofrece una latencia inferior al milisegundo para el servicio de características en tiempo real, un requisito crítico para casos de uso como la detección de fraudes, los sistemas de recomendación y las experiencias de usuario personalizadas.

Cómo usar Hopsworks

Usar Hopsworks implica un flujo de trabajo optimizado que acelera el camino desde los datos hasta los modelos listos para producción. El proceso está diseñado para ser Python-first y amigable para los desarrolladores:

  1. Conectar e Ingerir Datos: Comience conectándose a su proyecto de Hopsworks usando el cliente de Python. Puede ingerir datos de cualquier fuente, incluyendo lagos de datos, bases de datos o plataformas de streaming, usando frameworks como Spark, Flink o Pandas.
  2. Ingeniería de Características: Transforme sus datos brutos en características listas para ML. Hopsworks soporta la ingeniería de características en varios frameworks, permitiéndole construir pipelines de características tanto por lotes como en tiempo real.
  3. Crear Grupos de Características: Organice sus características en 'Grupos de Características' dentro del Hopsworks Feature Store. Defina el esquema, las claves primarias y si las características deben estar disponibles para acceso en línea (tiempo real) o fuera de línea (lotes).
  4. Generar Datos de Entrenamiento: Use el Feature Store para crear conjuntos de datos de entrenamiento correctos en un punto en el tiempo. Esta característica crucial previene la fuga de datos al asegurar que solo se utilicen los valores de las características que estaban disponibles en el momento del evento que se intenta predecir.
  5. Entrenar y Versionar Modelos: Entrene sus modelos usando cualquier framework de ML (por ejemplo, TensorFlow, PyTorch, Scikit-learn). Hopsworks proporciona gestión de GPU integrada para escalar el entrenamiento de modelos grandes como los LLMs. Todos los modelos y sus características asociadas pueden ser versionados y rastreados en el Registro de Modelos.
  6. Desplegar y Servir: Despliegue sus modelos entrenados como servicios de inferencia. Para aplicaciones en tiempo real, el modelo puede obtener características con latencia de milisegundos desde el Feature Store en línea, asegurando datos frescos y relevantes para cada predicción.

Características principales de Hopsworks

  • AI Lakehouse: Unifica lagos de datos, almacenes de datos y bases de datos, proporcionando una única fuente de verdad para todos los datos de IA.
  • Feature Store Avanzado: El feature store unificado más avanzado para gestionar, almacenar, descubrir y servir características para casos de uso tanto en tiempo real como por lotes. Incluye versionado de características, validación de datos y seguimiento de linaje.
  • Servicio de Características en Tiempo Real: Entrega características con latencia inferior al milisegundo y frescura de milisegundos, impulsado por RonDB, lo que lo hace ideal para sistemas de IA en tiempo real exigentes.
  • Índice Vectorial Integrado: Un índice vectorial incorporado en el feature store en línea para soportar aplicaciones de LLM e IA generativa, como RAG (Generación Aumentada por Recuperación).
  • IA Soberana y Multi-Nube: Desplegable en cualquier nube (AWS, Azure, GCP), on-premise o en una configuración híbrida usando Kubernetes, dándole control total sobre sus datos e infraestructura.
  • Gestión de GPU Integrada: Orquesta eficientemente los recursos de GPU para el entrenamiento e inferencia de modelos a gran escala, incluyendo LLMs.
  • MLOps de Extremo a Extremo: Una única plataforma para gestionar todo el ciclo de vida de ML, incluyendo la ingeniería de características, el entrenamiento de modelos, el despliegue y la monitorización, con una fuerte gobernanza y características de colaboración.
  • Corrección en el Punto en el Tiempo: Genera automáticamente consultas de viaje en el tiempo para crear datos de entrenamiento históricamente precisos, previniendo errores comunes en el desarrollo de modelos.

Casos de uso para Hopsworks

Hopsworks es versátil y puede aplicarse a una amplia gama de aplicaciones de IA y ML en diversas industrias:

  • LLMs y Agentes: Construcción y despliegue de pipelines de Generación Aumentada por Recuperación (RAG) и otros agentes basados en LLM que requieren acceso de baja latencia a datos contextuales desde la base de datos vectorial integrada.
  • Análisis Predictivo: Desarrollo de modelos para la previsión de la demanda, la predicción de la pérdida de clientes y el mantenimiento predictivo, donde los datos oportunos son cruciales.
  • Sistemas de Recomendación en Tiempo Real: Potenciando recomendaciones de contenido y productos personalizadas al servir características del usuario en tiempo real basadas en sus interacciones más recientes.
  • Cliente 360: Creando una vista unificada y en tiempo real de los clientes combinando datos por lotes y en streaming para impulsar la personalización y el marketing dirigido.
  • Detección de Fraude y Anomalías: Identificando transacciones fraudulentas o amenazas de seguridad en tiempo real mediante el análisis de datos en streaming frente a patrones históricos.

Ventajas de Hopsworks

Hopsworks ofrece ventajas competitivas significativas para las organizaciones que buscan escalar sus iniciativas de IA:

  • Tiempo de Comercialización Acelerado: Al agilizar el flujo de trabajo de MLOps y permitir la reutilización de características, Hopsworks puede llevar los modelos a producción hasta 5 veces más rápido.
  • Reducción Significativa de Costes: La centralización de características previene el procesamiento y almacenamiento de datos redundantes, lo que conduce a ahorros de costes de hasta el 80%.
  • Rendimiento Inigualable: Logra pipelines de ML hasta 10 veces más rápidos y una latencia inferior al milisegundo para el servicio de características, permitiendo una nueva clase de aplicaciones de IA en tiempo real.
  • Gobernanza y Cumplimiento Mejorados: Proporciona una cobertura de auditoría del 100%, linaje de datos y control de acceso basado en roles, asegurando que los sistemas de IA sean fiables, transparentes y conformes.
  • Flexibilidad y Sin Ataduras: Su arquitectura abierta y modular soporta cualquier framework de ML, fuente de datos y entorno de despliegue, evitando la dependencia de un proveedor.

Precios y planes

Hopsworks ofrece un modelo de precios flexible para adaptarse a diferentes necesidades. Hay un Feature Store sin servidor disponible de forma gratuita, que permite a individuos y equipos pequeños comenzar sin ningún requisito de infraestructura en la nube. Para organizaciones más grandes y casos de uso empresariales, Hopsworks ofrece servicios gestionados en las principales plataformas en la nube (AWS, Azure, GCP) y opciones de despliegue on-premise. Estos planes empresariales vienen con soporte dedicado, características de seguridad avanzadas y escalabilidad personalizada. Para obtener precios detallados sobre los planes empresariales y gestionados, se recomienda contactar directamente con el equipo de ventas de Hopsworks para obtener un presupuesto personalizado.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
MLOps
Solo dstack
OrquestaciónGestión de Infraestructura
Solo Hopsworks
Base de datosComputación en la Nube

Etiquetas

Compartido
Kubernetesaprendizaje automáticoMLOps
Solo dstack
Desarrollo de IAcomputación en la nubeOrquestación de contenedoresGestión de GPUInfraestructura como códigoDespliegue de modeloCódigo Abierto
Solo Hopsworks
AI LakehouseIngeniería de DatosGobernanza de datosFeature StoreModelo de Lenguaje de Gran EscalaPythonIA en tiempo realSpark

Audiencia y roles

Compartido
No hay datos verificados
Solo dstack
No hay datos verificados
Solo Hopsworks
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

dstack monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
13.1K
Duración media
0:02
Páginas por visita
1.21
Tasa de rebote
53.77%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 4.8K
  • 2026-01: 16.2K
  • 2026-02: 19.7K
  • 2026-03: 11.8K
  • 2026-04: 9.4K
  • 2026-05: 13.1K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇫🇷France64.99%8.5K
🇺🇸United States15.02%2K
🇷🇺Russia7.76%1K
🇮🇳India7.35%962
🇩🇪Germany4.88%639

Fuentes de tráfico

Source typePercentageEstimated visits
Directo61.06%8K
Correo electrónico20.74%2.7K
Referido18.2%2.4K

Palabras clave

dstackdstack serverdstack sky free creditssglang routertrl sft コマンドで複数ノードで実行する方法

Hopsworks monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
36.8K
Duración media
0:30
Páginas por visita
1.94
Tasa de rebote
37.79%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 63.2K
  • 2026-01: 67.6K
  • 2026-02: 45.7K
  • 2026-03: 40.6K
  • 2026-04: 37K
  • 2026-05: 36.8K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States34.98%12.9K
🇮🇳India24.91%9.2K
🇻🇳Vietnam16.1%5.9K
🇩🇪Germany12.6%4.6K
🇸🇪Sweden11.41%4.2K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo56.15%20.7K
Referido39.92%14.7K
Correo electrónico3.93%1.4K

Palabras clave

flash attentionhopsworkhopsworkstwo tower modelwhat is a lakehouse in ai

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

dstack

Valoración
Sin verificar
Comentarios
0
Favoritos
215
Me gusta
208

Hopsworks

Valoración
Sin verificar
Comentarios
0
Favoritos
200
Me gusta
206

dstack vs Hopsworks · Preguntas frecuentes

What do dstack and Hopsworks have in common?
Both tools are listed under MLOps. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are dstack and Hopsworks free?
Listed pricing models: dstack — Freemium; Hopsworks — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between dstack and Hopsworks?
The primary listed category is Orquestación for dstack, and Base de datos for Hopsworks. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas