hystruct
Raspado
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Raspado
Raspado
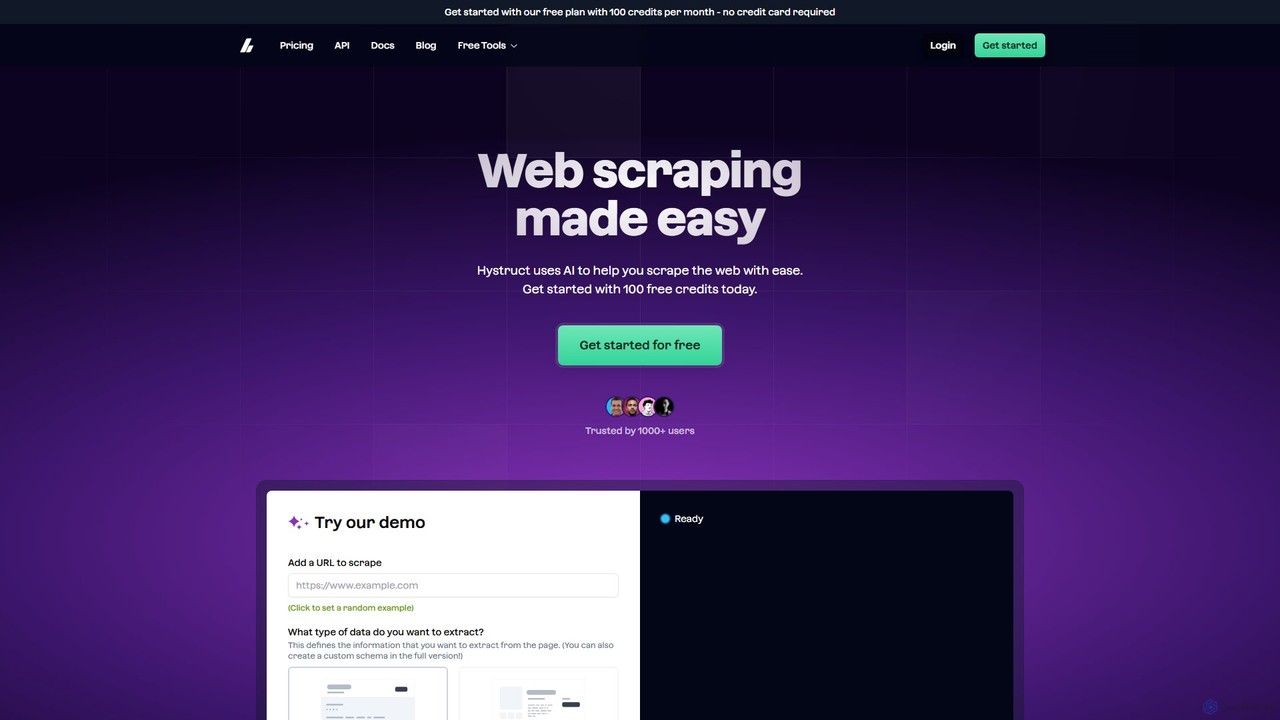
hystruct es una herramienta de web scraping impulsada por IA que simplifica la extracción de datos. Permite a los usuarios convertir fácilmente contenido web no estructurado en datos estructurados utilizando esquemas predefinidos o personalizados, sin necesidad de programar. Con integraciones como Zapier, automatiza flujos de trabajo para investigación de mercado, generación de leads y más. Está diseñado para todos, desde principiantes hasta equipos empresariales.
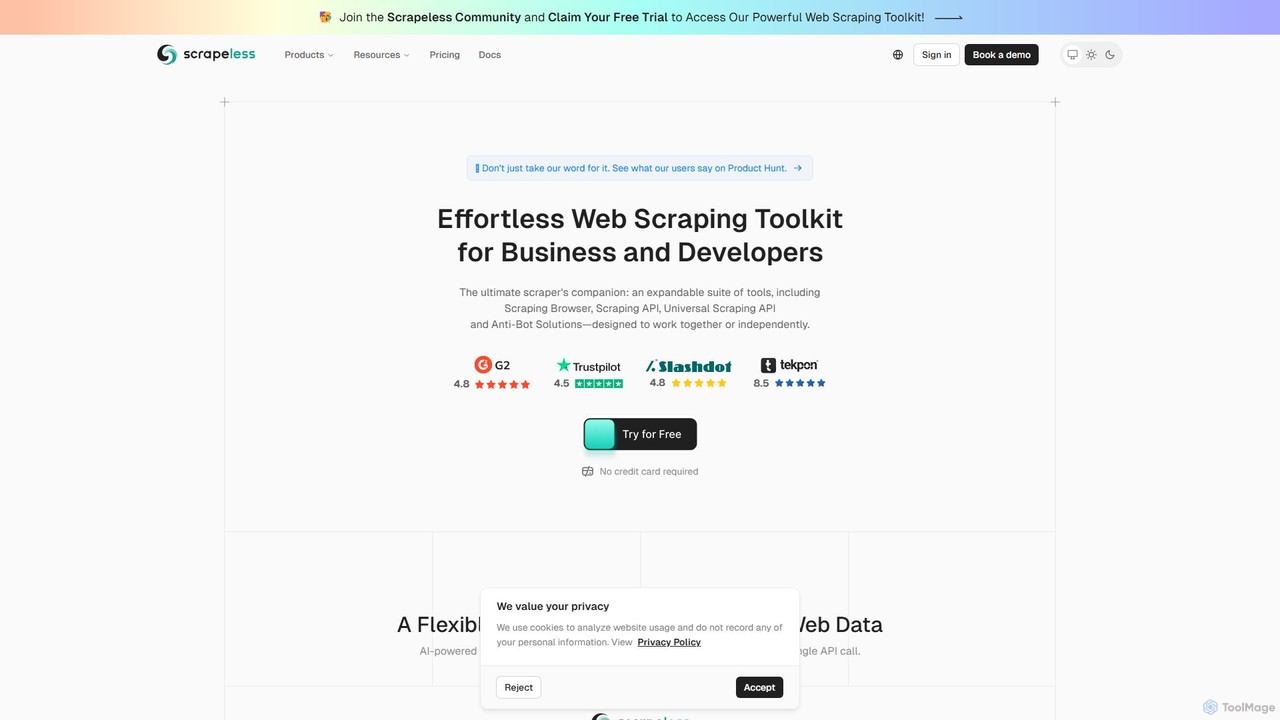
Un kit de herramientas de web scraping impulsado por IA para desarrolladores y empresas. Ofrece un conjunto de herramientas que incluye un Navegador de Scraping, API de Scraping Universal y API Deep SERP para extraer datos web públicos a escala sin esfuerzo. Se especializa en eludir medidas anti-bot, proporcionando datos estructurados para comercio electrónico, investigación de mercado y entrenamiento de modelos de IA, con un enfoque en la fiabilidad y la facilidad de uso.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Datos clave | hystruct | Scrapeless |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Raspado | Raspado |
| Audiencia y roles | Sin verificar | Sin verificar |
| Categorías | Raspado · API · Generación de Leads · Automatización | Raspado · API · SEO · Automatización |
| Added | 4 ago 2025 | 4 ago 2025 |
| Actualizado | 19 nov 2026 | 19 nov 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
hystruct es una plataforma avanzada de web scraping impulsada por IA, diseñada para hacer que la extracción de datos de cualquier sitio web sea sencilla y eficiente. Permite a los usuarios, independientemente de su experiencia técnica, convertir páginas web no estructuradas en datos limpios y estructurados. Al aprovechar la inteligencia artificial, hystruct elimina la necesidad de la entrada manual de datos o la codificación compleja, automatizando todo el proceso desde la entrada de la URL hasta la salida de los datos. La plataforma está construida para una amplia gama de usuarios, desde individuos y equipos pequeños hasta grandes empresas, proporcionando una solución escalable para diversas necesidades de datos.
Usar hystruct es un proceso simple de tres pasos diseñado para la máxima eficiencia:
hystruct es versátil y se puede aplicar a numerosos escenarios:
hystruct ofrece una ventaja competitiva significativa al simplificar una tarea tradicionalmente compleja. Sus principales ventajas incluyen la velocidad, al automatizar lo que llevaría horas de trabajo manual o codificación; la accesibilidad, al proporcionar una solución sin código para todos los niveles de habilidad; y la flexibilidad, a través de su soporte para necesidades de extracción de datos tanto simples como complejas con esquemas personalizados y acceso a la API. Las capacidades de integración mejoran aún más la productividad al encajar directamente en los flujos de trabajo empresariales existentes.
hystruct ofrece un modelo de precios escalonado para adaptarse a diferentes necesidades:
Scrapeless es una plataforma avanzada de web scraping impulsada por IA, diseñada para simplificar y escalar la extracción de datos para empresas y desarrolladores. No es solo una herramienta única, sino un conjunto de herramientas flexible que comprende un Navegador de Scraping, una API de Scraping Universal y una API Deep SERP especializada. Este conjunto está diseñado para manejar todo, desde la simple recopilación de datos hasta complejos desafíos anti-bot, asegurando un acceso sin problemas a los datos web públicos. Al aprovechar la IA, Scrapeless automatiza el proceso de eludir bloqueos, analizar contenido y entregar datos estructurados y procesables, convirtiéndolo en un compañero esencial para cualquiera que necesite información web fiable.
Usar Scrapeless está diseñado para ser un proceso sencillo, integrando potentes capacidades de scraping a través de una simple interfaz de API. Aquí hay un flujo de trabajo típico:
1. Regístrese y Obtenga la Clave de API: Regístrese para obtener una cuenta gratuita en el sitio web de Scrapeless. No se requiere tarjeta de crédito para la prueba, que le da acceso inmediato a su clave de API personal desde el panel de control.
2. Elija la Herramienta Correcta: Según sus necesidades, seleccione el servicio apropiado. Use la API de Scraping Universal para el scraping de propósito general de cualquier sitio web público. Opte por la API Deep SERP para la extracción dirigida y en tiempo real de resultados de motores de búsqueda estructurados. Para sitios web con mucho JavaScript y complejas medidas anti-bot, el Navegador de Scraping es la opción ideal.
3. Intégrelo en su Código: Use los ejemplos de código proporcionados en el panel de control para integrar Scrapeless en su aplicación. Es totalmente compatible con todos los principales lenguajes de programación como Python, Node.js, Java, Go y más.
4. Realice una Llamada a la API: Construya su solicitud de API con su URL de destino y cualquier parámetro específico que necesite, como la geolocalización para consultas SERP o la configuración de gestión de sesiones.
5. Deje que Scrapeless Haga el Trabajo: Una vez que se envía la solicitud, Scrapeless se encarga de todas las complejidades en segundo plano. Esto incluye la gestión de una vasta red de proxies, la rotación de direcciones IP, la resolución de CAPTCHAs y el uso de huellas dactilares de navegadores reales para imitar el comportamiento humano y evitar ser bloqueado.
6. Reciba Datos Estructurados: Recibe datos limpios y estructurados en formato JSON, listos para su uso inmediato en sus aplicaciones, bases de datos o modelos de IA. Solo paga por las solicitudes exitosas, lo que garantiza la rentabilidad.
Scrapeless es una herramienta versátil aplicable en diversas industrias y funciones:
• Comercio Electrónico e Inteligencia de Mercado: Rastree los precios de los productos de la competencia, supervise los niveles de stock, analice las estrategias de precios y agregue reseñas de clientes de cualquier plataforma de comercio electrónico o mercado.
• SEO y Estrategia de Contenido: Utilice la API Deep SERP para monitorear las clasificaciones de palabras clave en tiempo real, analizar las características de la SERP, rastrear las menciones de la marca y descubrir oportunidades de contenido.
• IA y Aprendizaje Automático: Alimente Modelos de Lenguaje Grandes (LLM) y sistemas de Generación Aumentada por Recuperación (RAG) con datos frescos, estructurados y relevantes de toda la web, mejorando la precisión y la actualidad de los conocimientos impulsados por IA.
• Generación de Leads: Extraiga sistemáticamente información de contacto, detalles de empresas y otros datos relevantes de directorios de negocios, redes profesionales y sitios web corporativos para construir listas de leads específicas.
• Análisis de Datos Financieros: Recopile datos del mercado de valores en tiempo real, noticias financieras e indicadores económicos de diversas fuentes en línea para realizar análisis de tendencias de mercado e informar estrategias de inversión.
La plataforma proporciona una clara ventaja competitiva a través de varias ventajas clave:
• Simplicidad y Velocidad: Una única API unificada reemplaza la necesidad de construir y mantener una infraestructura compleja de proxies, navegadores sin cabeza y analizadores, ahorrando un tiempo de desarrollo significativo y gastos operativos.
• Alta Tasa de Éxito: La tecnología anti-bot inteligente e impulsada por IA garantiza una tasa consistentemente alta de solicitudes exitosas, minimizando fallos, reintentos y lagunas de datos.
• Rentabilidad: Con un modelo de 'pago por éxito', a los usuarios solo se les cobra por los datos recuperados con éxito, lo que maximiza el retorno de la inversión y elimina el desperdicio de presupuesto en intentos fallidos.
• Escalabilidad Inigualable: La robusta infraestructura está diseñada para manejar millones de solicitudes, permitiendo que sus operaciones de datos escalen sin esfuerzo desde pequeños proyectos hasta cargas de trabajo de nivel empresarial.
• Calidad de Datos Garantizada: Los servicios opcionales de limpieza y transformación de datos aseguran que los datos que recibe sean precisos, estructurados y listos para su análisis e integración inmediatos.
• Ético y Seguro: Scrapeless demuestra un fuerte compromiso con la privacidad de los datos, el cumplimiento del GDPR y el uso ético de la tecnología de web scraping, proporcionando un servicio fiable y de confianza.
Scrapeless opera con un modelo de precios freemium y basado en el uso, diseñado para acomodar a una amplia gama de usuarios, desde desarrolladores individuales hasta grandes empresas.
• Prueba Gratuita: Los nuevos usuarios pueden registrarse sin tarjeta de crédito para recibir una prueba gratuita. Esta prueba proporciona un número generoso de créditos para probar completamente todo el conjunto de herramientas, incluida la API Universal y la API SERP.
• Pago por Uso: Este plan es ideal para proyectos más pequeños o usuarios con necesidades de scraping intermitentes. Puede comprar créditos según sea necesario y pagar solo por las llamadas a la API exitosas. Diferentes API pueden tener costos de crédito variables según su complejidad.
• Planes de Suscripción (por ejemplo, Starter, Pro, Business): Para usuarios con necesidades consistentes y de alto volumen, Scrapeless ofrece planes de suscripción mensuales. Estos planes proporcionan un gran volumen de créditos a una tarifa con descuento en comparación con el Pago por Uso, junto con beneficios adicionales como límites de concurrencia más altos, soporte más rápido y funciones avanzadas.
• Plan Empresarial: Para empresas con requisitos de datos a gran escala o únicos, el Plan Empresarial ofrece una solución totalmente personalizada. Esto incluye infraestructura dedicada, scrapers personalizados, procesamiento y limpieza de datos, canales de entrega de datos en tiempo real y un Acuerdo de Nivel de Servicio (SLA) completo para garantizar el rendimiento y el tiempo de actividad.
Los precios son transparentes, con costos a menudo calculados por cada 1,000 solicitudes exitosas (por ejemplo, la API Deep Serp se anuncia a $0.1/1k consultas), asegurando que pueda predecir y gestionar fácilmente sus gastos.
La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.
El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 100% | 1.4K |
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇻🇳Vietnam | 33.19% | 25.6K |
| 🇮🇳India | 20.82% | 16K |
| 🇺🇸United States | 18.39% | 14.2K |
| 🇳🇬Nigeria | 14.7% | 11.3K |
| 🇧🇷Brazil | 12.9% | 9.9K |
| Source type | Percentage | Estimated visits |
|---|---|---|
| Directo | 60.21% | 46.4K |
| Referido | 39.79% | 30.6K |
Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.