ToolMage
Iniciar sesión

AI TOOL COMPARISON

No-Code Scraper vs ParseHub

What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.

Jump to key differences

Resumen del producto

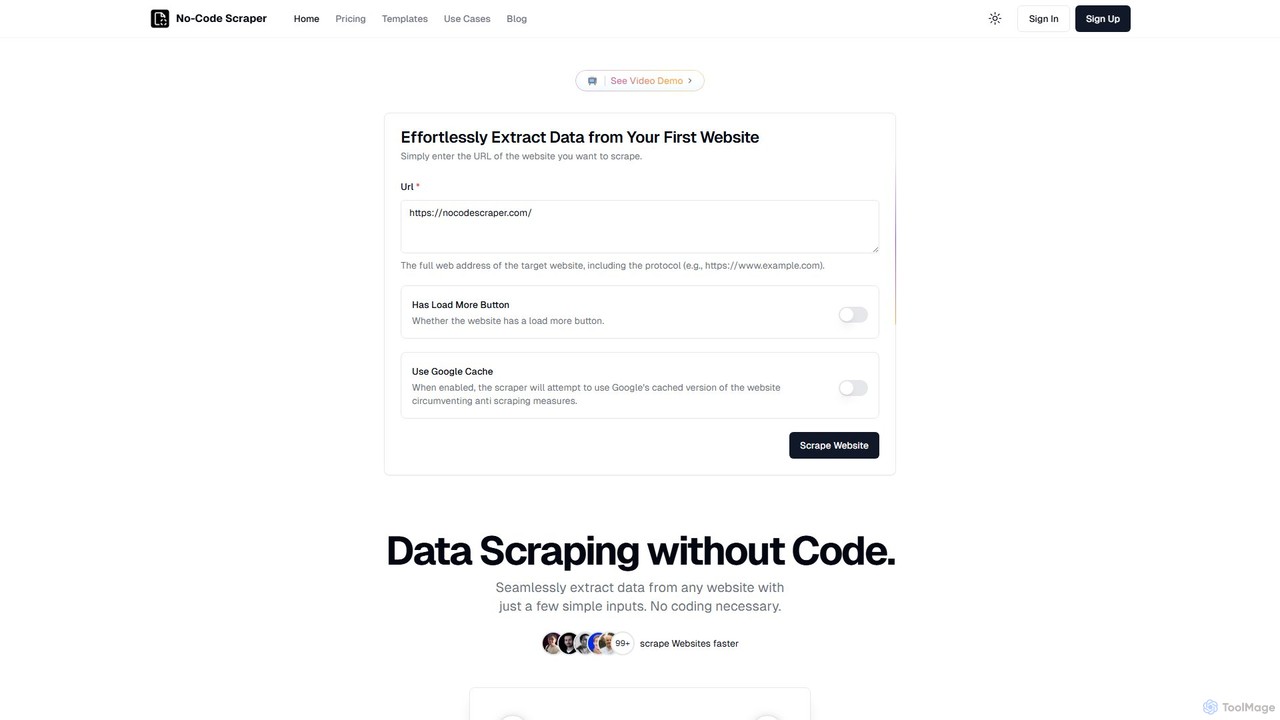
No-Code Scraper Resumen del producto

No-Code Scraper es una plataforma impulsada por IA que permite a los usuarios extraer datos de cualquier sitio web sin escribir una sola línea de código. Utiliza grandes modelos de lenguaje para automatizar la extracción, limpieza y estructuración de datos, haciendo que el web scraping sea accesible, fiable y eficiente para todos.

Preview

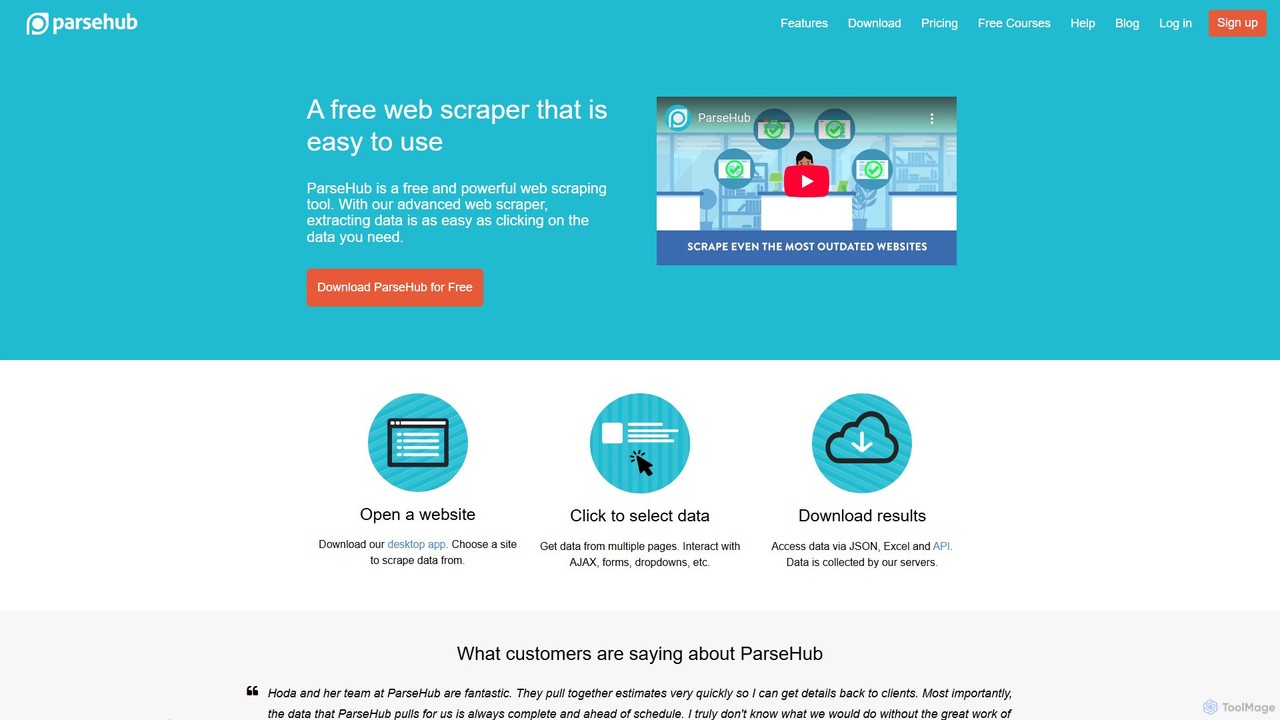
ParseHub Resumen del producto

ParseHub es una potente herramienta de web scraping sin código que permite a los usuarios extraer datos de cualquier sitio web con una sencilla interfaz de apuntar y hacer clic. Está diseñada para manejar sitios complejos y dinámicos con JavaScript, AJAX, formularios y scroll infinito. Los datos se pueden recopilar de forma programada, exportar como JSON/Excel o acceder a ellos a través de una API, lo que la hace ideal para la generación de leads, investigación de mercado y agregación de datos.

Preview

Datos clave

Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.

No-Code Scraper VS ParseHub — Datos clave
Datos claveNo-Code ScraperParseHub
Pricing modelFreemiumFreemium
Product typeWebApp
Primary focusExtracción de Datos WebExtracción de Datos Web
Audiencia y rolesSin verificarSin verificar
CategoríasExtracción de Datos Web · Generación de Leads · Desarrollo · AutomatizaciónExtracción de Datos Web · Extracción de Datos · Generación de Leads · Automatización
Added10 ago 20256 ago 2025
Actualizado19 nov 202619 nov 2026

Features, usage and use cases

Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.

No-Code Scraper

No-Code Scraper es una herramienta revolucionaria diseñada para democratizar la extracción de datos web. Permite a los usuarios, independientemente de su formación técnica, obtener información valiosa de cualquier sitio web sin problemas. Al aprovechar el poder de la IA avanzada y los grandes modelos de lenguaje (LLM), la plataforma automatiza el proceso tradicionalmente complejo y frágil del web scraping. Aborda problemas comunes como la necesidad de desarrolladores, las roturas frecuentes de los scrapers debido a las actualizaciones de los sitios web y la tarea de limpiar datos brutos que consume mucho tiempo.

La plataforma se basa en el principio de simplicidad y resiliencia. Los usuarios pueden empezar a hacer scraping con solo unos pocos clics, y la IA subyacente está diseñada para adaptarse a los cambios en la estructura del sitio web, garantizando una recopilación de datos consistente y fiable. Esta cualidad 'inquebrantable' significa que puedes crear una única plantilla y usarla en miles de sitios similares sin un mantenimiento constante.

Cómo usar No-Code Scraper

Empezar con No-Code Scraper es un proceso sencillo de tres pasos:

  1. Importar Sitios Web: Comienza introduciendo la URL del sitio web objetivo. También puedes importar una lista de sitios web desde un archivo CSV para operaciones de scraping masivo.
  2. Definir Puntos de Datos a Extraer: Utiliza la intuitiva interfaz sin código para crear una plantilla de scraping. Simplemente describe los datos que quieres extraer (p. ej., 'nombre del producto', 'precio', 'opinión del cliente'). La IA entenderá tus requisitos y se encargará de la extracción, limpieza y validación por ti. También puedes elegir entre una amplia variedad de plantillas preconstruidas para sitios populares como Yelp, Google Maps, Product Hunt y más.
  3. Lanzar Tarea de Scraping: Con tu plantilla configurada, lanza la tarea con un solo clic. La IA se pondrá a trabajar, extrayendo los datos según tus especificaciones. Una vez completado, puedes descargar los resultados perfectamente estructurados como un archivo CSV, Excel o JSON, o exportarlos directamente a herramientas como Google Sheets, Notion y Airtable con los planes de nivel superior.

Características principales de No-Code Scraper

  • Interfaz Sin Código Impulsada por IA: Configura fácilmente scrapers describiendo los datos que necesitas en lenguaje sencillo, sin necesidad de conocimientos de HTML o CSS.
  • Resiliencia Inquebrantable: La IA se adapta automáticamente a los cambios de diseño del sitio web, evitando que los scrapers se rompan y eliminando la necesidad de un mantenimiento constante.
  • Limpieza de Datos Automatizada: Obtén datos perfectamente estructurados, limpios y formateados al instante, ahorrando horas de preparación manual de datos.
  • Amplias Plantillas Preconstruidas: Una gran biblioteca de plantillas para casos de uso comunes y sitios web populares como Crunchbase, Glassdoor, Yelp y Kickstarter para empezar a hacer scraping de inmediato.
  • Capacidades de Scraping Avanzadas: Maneja escenarios complejos que incluyen paginación, botones de 'cargar más' y contenido dinámico renderizado con JavaScript.
  • Integración con la Caché de Google: Una opción para usar la versión en caché de un sitio web de Google para eludir algunas medidas anti-scraping.
  • Exportación de Datos Flexible: Descarga datos en formatos CSV, Excel o JSON.
  • Integraciones y Acceso a la API: Conéctate con Google Sheets, Notion y Airtable (plan Pro) u obtén un control programático completo con acceso a la API (plan Expert).
  • Scraping Programado: Automatiza tu recopilación de datos programando tareas de scraping para que se ejecuten a intervalos regulares (plan Pro y superior).

Casos de uso para No-Code Scraper

No-Code Scraper es versátil y puede ser utilizado por especialistas en marketing, fundadores, investigadores y equipos de ventas para diversos fines:

  • Generación de Leads: Extrae detalles de empresas de directorios como BBB o Yelp, o perfiles profesionales de Medium.
  • Investigación de Mercado: Extrae datos de productos de Product Hunt, información de aplicaciones de tiendas de apps, o tendencias de mercado de Crunchbase e Indie Hackers.
  • Análisis Competitivo: Monitoriza los precios de la competencia, las características de los productos y las opiniones de los clientes de sitios de comercio electrónico o plataformas de reseñas.
  • Reclutamiento: Recopila ofertas de empleo de plataformas como Glassdoor, Upwork y Y Combinator para analizar las tendencias de contratación y encontrar oportunidades.
  • Análisis Inmobiliario: Extrae listados y detalles de propiedades de sitios como Redfin para seguir las tendencias del mercado y encontrar oportunidades de inversión.
  • Agregación de Contenido: Construye directorios o compila diarios extrayendo datos de diversas fuentes en la web.

Ventajas de No-Code Scraper

La principal ventaja es su accesibilidad. Abre el mundo de los datos web a los usuarios no técnicos. Su resiliencia impulsada por la IA reduce significativamente la sobrecarga de mantenimiento típica de los scrapers tradicionales. La limpieza automática de datos es un gran impulsor de la productividad, entregando datos listos para usar. La plataforma todo en uno se encarga de todo, desde simples extracciones de datos hasta complejos escenarios de scraping de varias páginas, lo que la convierte en una solución completa y rentable.

Precios y planes

No-Code Scraper ofrece una prueba gratuita de 5 días y varios planes de suscripción basados en un sistema de créditos. Los créditos se utilizan para acciones como extraer una página o datos.

  • Plan Starter: $16.99/mes por 400 créditos. Incluye renderizado de Javascript y exportación básica de datos (JSON, CSV, Excel).
  • Plan Pro: $19.99/mes por 400 créditos. Incluye todas las características de Starter más exportación a Google Sheets, Notion y Airtable, y tareas de scraping programadas.
  • Plan Expert: $25.99/mes por 400 créditos. Incluye todas las características de Pro más acceso completo a la API y soporte de proxy premium para tareas más exigentes.

El número de créditos necesarios varía según la tarea. Por ejemplo, un scrape de página simple cuesta 1 crédito, mientras que extraer y raspar datos de una página usando un proxy cuesta 6 créditos.

ParseHub

ParseHub es una herramienta de web scraping gratuita y potente, diseñada para que la extracción de datos de la web sea accesible para todos, independientemente de sus habilidades de programación. Con su avanzada interfaz visual, extraer datos es tan simple como hacer clic en la información que necesitas. Es una solución robusta para cualquier persona, desde científicos de datos y especialistas en marketing hasta desarrolladores y especialistas en comercio electrónico que necesitan recopilar datos de la web de manera eficiente.

La herramienta es particularmente experta en manejar sitios web modernos y complejos. Puede navegar a través de elementos interactivos como formularios, menús desplegables, inicios de sesión y mapas. También gestiona sin problemas sitios con scroll infinito, pestañas y ventanas emergentes, que a menudo son un desafío para otros scrapers. El motor de relaciones de aprendizaje automático de ParseHub analiza inteligentemente la estructura de la página, comprende la jerarquía de los elementos y extrae los datos deseados en segundos, eliminando la necesidad de introducir datos manualmente o escribir scripts complejos.

Cómo usar ParseHub

Empezar a usar ParseHub es un proceso sencillo de tres pasos:

  1. Descargar e Instalar: Primero, descarga la aplicación de escritorio gratuita de ParseHub para tu sistema operativo e instálala.
  2. Seleccionar Datos: Abre la aplicación, introduce la URL del sitio web del que quieres extraer datos. Una vez que el sitio se cargue, simplemente haz clic en los campos de datos que deseas extraer. La herramienta de selección de ParseHub identificará inteligentemente elementos similares para capturar datos de múltiples ítems en una página. Puedes entrenarlo para manejar la paginación para extraer de múltiples páginas, interactuar con formularios para enviar consultas de búsqueda y mucho más.
  3. Ejecutar y Descargar: Una vez que tu proyecto esté configurado, puedes ejecutar el scraping. Los datos se recopilan en los servidores en la nube de ParseHub, lo que significa que puedes cerrar la aplicación mientras trabaja. Una vez finalizada la ejecución, puedes acceder a los datos extraídos a través de la API o descargarlos en varios formatos, incluyendo Excel y JSON, listos para su análisis o integración en otros sistemas.

Características principales de ParseHub

  • Interfaz sin código: Una interfaz gráfica fácil de usar que te permite construir scrapers simplemente haciendo clic en los elementos.
  • Manejo de sitios web dinámicos: Capaz de extraer datos de sitios que usan JavaScript, AJAX, cookies y redirecciones. Puede manejar inicios de sesión, ventanas emergentes, menús desplegables y más.
  • Scraping basado en la nube: Toda la extracción de datos se realiza en los servidores de ParseHub, liberando los recursos de tu ordenador local.
  • Recopilación programada: Configura tus proyectos para que se ejecuten automáticamente de forma diaria, semanal o en un horario personalizado para obtener los datos más recientes.
  • Rotación de IP: Rota automáticamente a través de un gran grupo de direcciones IP para evitar ser bloqueado durante el scraping.
  • Potente limpieza de datos: Usa Expresiones Regulares (RegEx) para limpiar y formatear texto y HTML directamente en la aplicación antes de la descarga.
  • API e Integraciones: Accede a tus datos programáticamente con una API REST y usa webhooks para notificaciones en tiempo real. También se integra con Google Sheets, Tableau y Dropbox.
  • Exportación de datos flexible: Descarga tus datos extraídos en formatos JSON, CSV y Excel para un fácil análisis y uso en otras aplicaciones.

Casos de uso para ParseHub

ParseHub es una herramienta versátil utilizada en diversas industrias:

  • Comercio electrónico: Extrae detalles de productos, precios, valoraciones y reseñas de sitios web de la competencia para el seguimiento de precios y el análisis de mercado.
  • Generación de leads: Extrae información de contacto de directorios en línea, redes profesionales y comunidades para construir embudos de ventas.
  • Investigación de mercado: Agrega datos para el análisis de la industria, el seguimiento de la competencia y la identificación de tendencias del mercado.
  • Periodismo de datos y Academia: Recopila grandes conjuntos de datos de fuentes públicas para proyectos de investigación, informes e historias basadas en datos.
  • Agregación de contenido: Reúne artículos, noticias y publicaciones de múltiples sitios web para alimentar un agregador de noticias o una plataforma de contenido.
  • Bienes raíces: Extrae listados de propiedades, precios y detalles de agentes de sitios web inmobiliarios.

Ventajas de ParseHub

ParseHub se destaca por varias razones clave. Su principal ventaja es su facilidad de uso, que democratiza el web scraping al eliminar la barrera de la programación. El poder y la flexibilidad para manejar cualquier sitio web interactivo la convierten en una herramienta fiable para tareas complejas. Al ser basada en la nube y escalable, puede manejar proyectos de cualquier tamaño, desde unas pocas páginas hasta millones, sin requerir que los usuarios gestionen ninguna infraestructura. Esto ahorra un tiempo y unos recursos significativos, permitiendo a los usuarios centrarse en el análisis de los datos en lugar de en su recopilación.

Precios y planes

ParseHub ofrece una gama de planes para adaptarse a diferentes necesidades:

  • Plan Gratuito: Ideal para pequeños proyectos y para aprender. Incluye 200 páginas por ejecución, 5 proyectos públicos y retención de datos durante 14 días.
  • Plan Standard ($189/mes): Diseñado para profesionales. Ofrece 10,000 páginas por ejecución, 20 proyectos privados, rotación de IP y scraping programado.
  • Plan Professional ($599/mes): Para scraping intensivo. Incluye páginas ilimitadas por ejecución, 120 proyectos privados, soporte prioritario y retención de datos durante 30 días.
  • ParseHub Plus (Enterprise): Un plan personalizado para empresas con necesidades de datos a gran escala, que ofrece soporte dedicado, características personalizadas y asistencia experta en la configuración de proyectos de scraping.

Hay descuentos disponibles para organizaciones sin ánimo de lucro, estudiantes e instituciones académicas. Todos los precios están en dólares estadounidenses.

Posicionamiento

La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.

Categorías

Compartido
Extracción de Datos WebGeneración de LeadsAutomatización
Solo No-Code Scraper
Desarrollo
Solo ParseHub
Extracción de Datos

Etiquetas

Compartido
automatizaciónExtracción de datosminería de datosGeneración de leadsinvestigación de mercadoNo-codeWeb scraping
Solo No-Code Scraper
IALimpieza de datos
Solo ParseHub
Recopilación de datosSeguimiento de precios

Audiencia y roles

Compartido
No hay datos verificados
Solo No-Code Scraper
No hay datos verificados
Solo ParseHub
No hay datos verificados

Comparación de tráfico

El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.

How to interpret the traffic data

Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.

No-Code Scraper monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
3.3K
Duración media
0:47
Páginas por visita
2.03
Tasa de rebote
45.35%
Data updated 2026-06-15

Monthly traffic trend

  • 2025-09: 5K
  • 2026-01: 2.6K
  • 2026-02: 2.2K
  • 2026-03: 5.1K
  • 2026-04: 3.9K
  • 2026-05: 3.3K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.52%1.3K
🇭🇰Hong Kong33.21%1.1K
🇮🇩Indonesia18.52%617
🇮🇳India8.75%292

Fuentes de tráfico

Source typePercentageEstimated visits
Referido94.54%3.2K
Directo5.46%182

Palabras clave

instant data scraperinstant data scraper extensionno code scrapernocodescraperno code web scraper

ParseHub monthly traffic:

Latest traffic · 2026-05

Visitas mensuales
68.7K
Duración media
0:19
Páginas por visita
1.89
Tasa de rebote
39.47%
Data updated 2026-06-11

Monthly traffic trend

  • 2025-09: 136.2K
  • 2026-01: 120.4K
  • 2026-02: 102.7K
  • 2026-03: 82.7K
  • 2026-04: 74K
  • 2026-05: 68.7K

Regiones principales

Top 5 countries/regions
Country/regionPercentageEstimated visits
🇺🇸United States39.93%27.4K
🇮🇳India23.24%16K
🇳🇬Nigeria14.19%9.7K
🇬🇧United Kingdom13.27%9.1K
🇧🇷Brazil9.37%6.4K

Fuentes de tráfico

Source typePercentageEstimated visits
Directo91.62%62.9K
Referido6.21%4.3K
Correo electrónico2.17%1.5K

Palabras clave

free webscraping coursehow to get an html sentence for a specific value on a websitepareshubparsehubparse hub how to click on gdpr agreement first

Señales de comunidad

Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.

No-Code Scraper

Valoración
Sin verificar
Comentarios
0
Favoritos
184
Me gusta
181

ParseHub

Valoración
Sin verificar
Comentarios
0
Favoritos
166
Me gusta
165

No-Code Scraper vs ParseHub · Preguntas frecuentes

What do No-Code Scraper and ParseHub have in common?
Both tools are listed under Extracción de Datos Web、Generación de Leads、Automatización. These categories indicate overlapping use cases; compare their detailed descriptions for workflows, capabilities and limitations.
Are No-Code Scraper and ParseHub free?
Listed pricing models: No-Code Scraper — Freemium; ParseHub — Freemium. Missing pricing is not proof of a free plan, and freemium does not mean every feature is free. Check official sites for current plans, limits and trials.
How should I choose between No-Code Scraper and ParseHub?
The primary listed category is Extracción de Datos Web for No-Code Scraper, and Extracción de Datos Web for ParseHub. Compare features, steps and use cases, then verify pricing, data permissions and deployment needs. This page does not include hands-on testing and does not declare a winner from traffic or tags.

Sources and comparison methodology

This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.
  • Feature and plan descriptions reflect information in the listings, not real-time guarantees. Verify pricing, quotas, availability and privacy terms on the official sites.
  • Traffic uses the reporting months shown. Missing statistics do not mean zero visits, and different periods do not establish growth or superiority. Regional and source visit counts are estimates based on shares.
  • Different tags indicate differences in the listings, not proof that the other product lacks a capability. Ratings, favorites and visits are not used to declare a winner.

Comparativas relacionadas