UseScraper
Extracción de Datos
AI TOOL COMPARISON
What is the difference, and which fits your workflow? Compare features, usage, pricing models and traffic side by side.
Extracción de Datos
Extracción de Datos
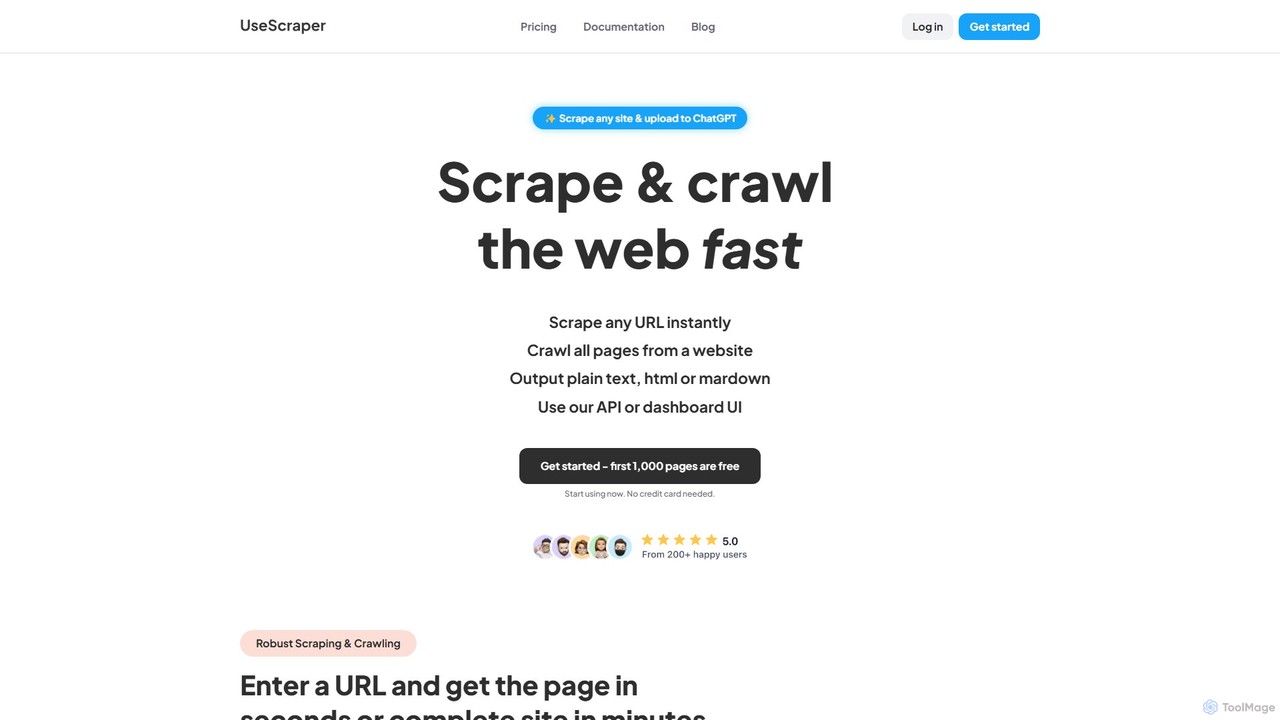
UseScraper es una potente API de crawler y scraper web diseñada para desarrolladores y aplicaciones de IA. Extrae datos de cualquier sitio web de manera eficiente, con renderización completa de JavaScript, infraestructura de autoescalado y formatos de salida limpios como Markdown, ideal para alimentar datos a LLMs como ChatGPT.
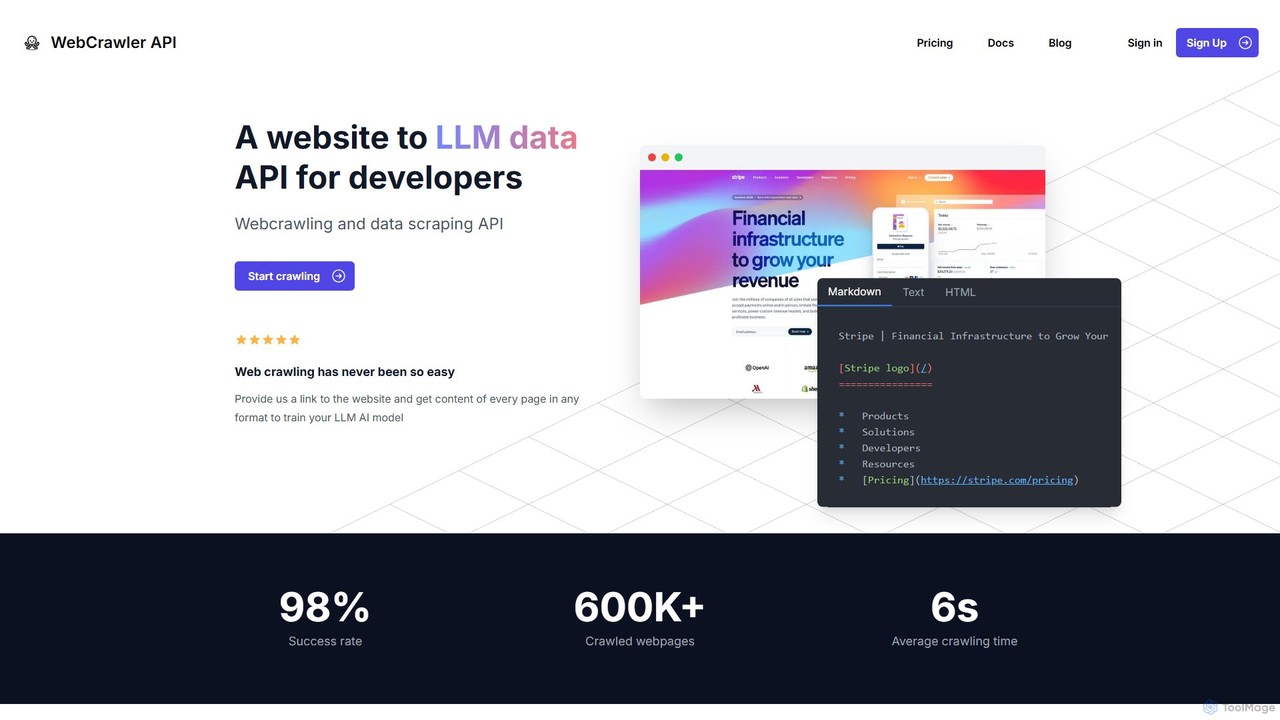
Webcrawlerapi es una potente API para que los desarrolladores rastreen sitios web y extraigan datos limpios sin esfuerzo. Simplifica el web scraping al gestionar el renderizado de JavaScript, las medidas anti-bot y el análisis de datos. Ideal para recopilar contenido estructurado como Markdown o texto para entrenar modelos de IA LLM o para sistemas de Generación Aumentada por Recuperación (RAG), ofrece una alta tasa de éxito y un modelo de precios simple de pago por uso.
Compare product focus, pricing models and audiences. Highlighted rows indicate different listed information; unknown pricing does not mean free.
| Datos clave | UseScraper | Webcrawlerapi |
|---|---|---|
| Pricing model | Freemium | Freemium |
| Product type | Web | Web |
| Primary focus | Extracción de Datos | Extracción de Datos |
| Audiencia y roles | Sin verificar | Sin verificar |
| Categorías | Extracción de Datos · API · Automatización | Extracción de Datos · API · Automatización |
| Added | 5 ago 2025 | 2 ago 2025 |
| Actualizado | 19 nov 2026 | 19 nov 2026 |
Explore the listed product descriptions, features and workflows. Taxonomy labels alone are not feature evaluations.
UseScraper es un servicio de web scraping y crawling robusto y escalable que se proporciona a través de una API simple pero potente. Está diseñado desde cero para la velocidad y la fiabilidad, permitiendo a los usuarios extraer datos de cualquier página web en segundos o rastrear sitios web completos en minutos. Esta herramienta es particularmente valiosa para desarrolladores, científicos de datos y empresas que necesitan recopilar datos web para investigación de mercado, generación de leads, monitoreo de precios o para entrenar modelos de IA.
La plataforma está diseñada para manejar las complejidades de la web moderna. Utiliza un navegador Chrome real para una renderización completa de JavaScript, asegurando que el contenido en aplicaciones dinámicas de una sola página (SPAs) se capture con precisión. Esta capacidad lo hace superior a muchos scrapers tradicionales que solo obtienen HTML estático. La salida se puede entregar en varios formatos, incluyendo HTML crudo, texto plano y, notablemente, Markdown limpio y bien estructurado, que es el formato ideal para el procesamiento por sistemas de IA y Modelos de Lenguaje Grandes (LLMs).
Usar UseScraper es sencillo para desarrolladores de todos los niveles. El proceso implica unos pocos pasos simples:
UseScraper es versátil y se puede aplicar a una amplia gama de tareas de extracción de datos:
UseScraper se destaca por su enfoque en el rendimiento, la compatibilidad con la web moderna y la experiencia del desarrollador. Sus ventajas clave incluyen su capacidad para manejar sitios con mucho JavaScript sin esfuerzo, la provisión de una salida de Markdown limpia y adaptada para la IA, y su arquitectura escalable y de alta velocidad. El modelo de precios flexible, que incluye un generoso nivel gratuito, lo hace accesible para proyectos de todos los tamaños, desde pequeños scripts hasta operaciones de datos empresariales a gran escala.
UseScraper ofrece una estructura de precios transparente y escalable:
Los nuevos usuarios reciben $25 en créditos gratuitos al registrarse, lo que proporciona un punto de partida sustancial para pruebas y desarrollo.
Webcrawlerapi es una API especializada diseñada para agilizar el proceso de rastreo web y extracción de datos para desarrolladores. En una era en la que los datos son cruciales para entrenar grandes modelos de lenguaje (LLM) y potenciar aplicaciones de IA, el web scraping tradicional presenta desafíos significativos. Estos incluyen manejar contenido dinámico renderizado por JavaScript, eludir sofisticados sistemas anti-bot, gestionar proxies y limpiar HTML desordenado para convertirlo en formatos utilizables. Webcrawlerapi abstrae todas estas complejidades, proporcionando una interfaz simple pero potente para convertir cualquier sitio web en una fuente de datos estructurada.
Con una tasa de éxito reportada del 98% y un tiempo de rastreo promedio de solo 6 segundos, el servicio está diseñado para la eficiencia y la fiabilidad. Permite a los desarrolladores centrarse en la lógica principal de su aplicación en lugar de empantanarse en las complejidades de construir y mantener una infraestructura de rastreo escalable. Al proporcionar un enlace, los desarrolladores pueden recibir contenido limpio y listo para usar en formatos como Markdown, texto o HTML sin procesar, lo que lo hace perfecto para alimentar pipelines de entrenamiento de modelos de IA o bases de conocimiento para sistemas RAG.
Integrar Webcrawlerapi en tu proyecto está diseñado para ser sencillo. El proceso generalmente implica solo unas pocas líneas de código. Primero, necesitas registrarte en el sitio web de Webcrawlerapi para obtener tu clave de acceso única a la API. Luego, puedes usar una de sus bibliotecas de cliente proporcionadas para lenguajes de programación populares.
Por ejemplo, en un entorno de NodeJS, comenzarías instalando la biblioteca del cliente a través de npm: npm i webcrawlerapi-js. Luego, en tu código, importas la biblioteca, creas una nueva instancia del cliente con tu clave de API y llamas al método `crawl`. Este método toma parámetros como la `url` de destino, el `scrape_type` deseado (por ejemplo, 'markdown') y límites opcionales como `items_limit`. La API luego se encarga de todo el proceso de rastreo en segundo plano y devuelve una respuesta JSON estructurada con los datos extraídos. Patrones de integración simples similares están disponibles para Python, PHP y .NET, lo que lo hace accesible para una amplia gama de desarrolladores.
Webcrawlerapi es versátil y se puede aplicar a una variedad de tareas intensivas en datos. Sus principales casos de uso giran en torno a la IA y el análisis de datos.
La principal ventaja de Webcrawlerapi es su simplicidad y eficiencia. Permite a los equipos de desarrollo externalizar toda la infraestructura de rastreo web y la carga de mantenimiento. Esto significa un tiempo de comercialización más rápido para los productos basados en datos. La alta tasa de éxito (98%) y las robustas características anti-bot aseguran que los pipelines de datos sean fiables. Además, su modelo de precios transparente y de pago por uso es altamente rentable, ya que solo pagas por las solicitudes exitosas, eliminando el riesgo y los gastos generales asociados con las suscripciones o la construcción de una solución interna.
Webcrawlerapi emplea un modelo de precios de 'pago por uso' directo y transparente, evitando por completo las suscripciones y las tarifas ocultas. Los costos se calculan en función del número de páginas que rastreas con éxito cada mes. El servicio incluye trabajos de rastreo ilimitados, una red de proxy ilimitada y gestionada automáticamente, y soporte por correo electrónico en su precio. Para una estimación de costos clara, el sitio web proporciona una calculadora. Como ejemplo, rastrear 10,000 páginas en un mes costaría aproximadamente $20. Este modelo es ideal para proyectos de todos los tamaños, desde experimentos a pequeña escala hasta operaciones de datos a gran escala, ya que los costos escalan directamente con el uso. La plataforma también permite a los usuarios probar el servicio antes de realizar una compra, probablemente a través de una asignación de crédito gratuito para nuevas cuentas.
La taxonomía muestra dónde coinciden los productos y dónde destaca cada uno. Los campos desconocidos se muestran claramente y no se completan con suposiciones.
El tráfico usa la misma escala para reflejar de forma fiel la visibilidad de mercado.
Both charts share the same months and vertical scale. Each tool identifies its latest reporting month; missing months are left blank, not counted as zero. Regional and source visit counts are estimates calculated from the reported shares.
Sin verificar
| Country/region | Percentage | Estimated visits |
|---|---|---|
| 🇺🇸United States | 49.13% | 2.7K |
| 🇩🇪Germany | 20.9% | 1.1K |
| 🇮🇳India | 14.85% | 809 |
| 🇻🇳Vietnam | 12.23% | 666 |
| 🇦🇺Australia | 2.89% | 157 |
Las valoraciones y reacciones son señales de comunidad, no sustituyen el ajuste del producto.
This page is assembled from ToolMage product listings, taxonomy, traffic statistics and on-site user feedback. It is not a hands-on test or an independent review.