ToolMage
Connexion

Best 2 Systèmes RAG AI tools for Développement de l'IA

Popular Systèmes RAG AI tools in Développement de l'IA include DeConsole et PloyD, helping you work more efficiently.

DeConsole
Freemium

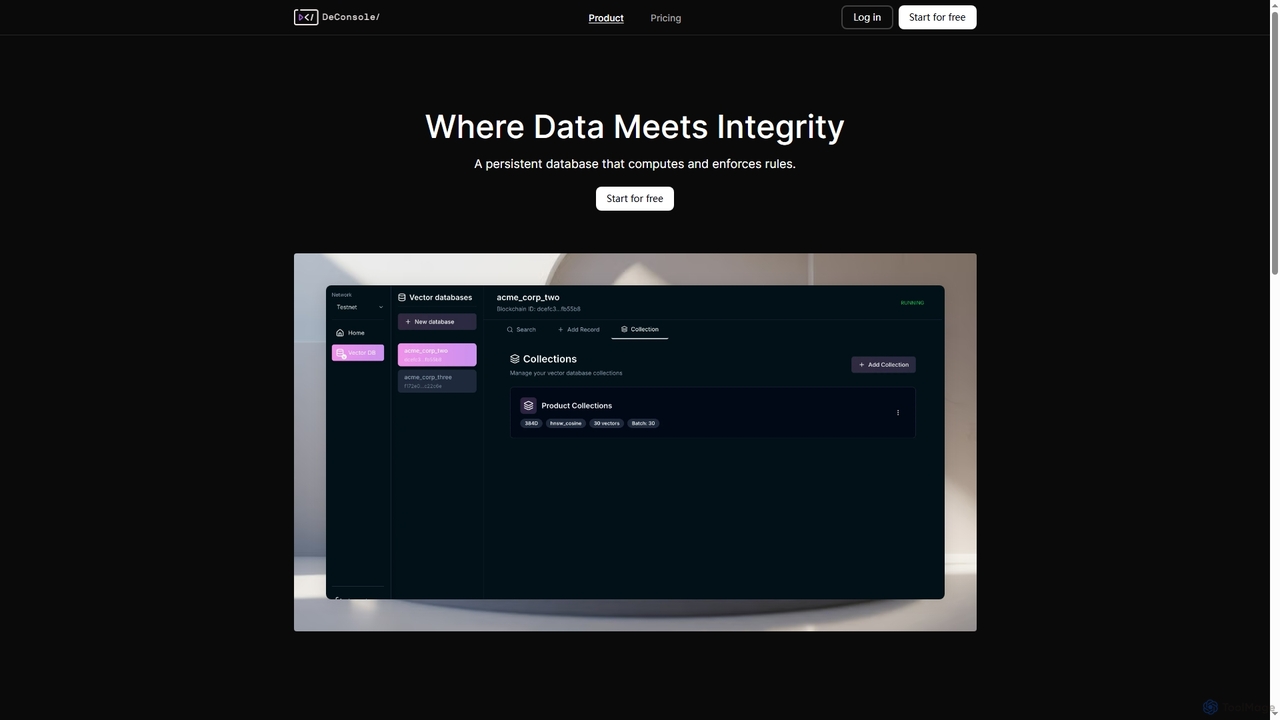
DeConsole

DeConsole est un service de base de données distribué, persistant et résistant aux manipulations, conçu pour les données critiques. Il offre la simplicité d'un DBaaS cloud sans point de contrôle unique. Il calcule et applique des règles, garantissant l'intégrité des données et fournissant un historique infalsifiable pour diverses applications, notamment l'IA.

Systèmes RAG
Visits 7.2KFavorites 119Likes 124
PloyD

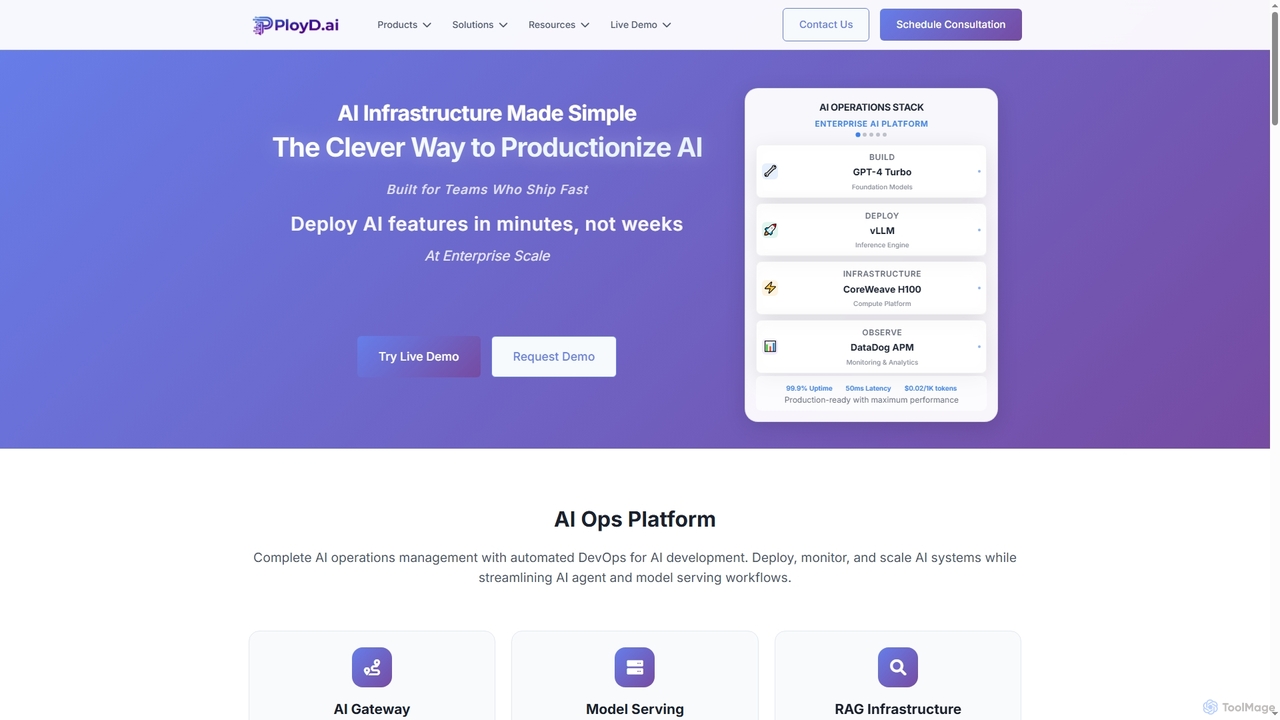
PloyD

PloyD est une plateforme d'opérations d'IA d'entreprise conçue pour rationaliser la mise en production des modèles et applications d'IA. Elle s'attaque aux défis courants tels que les goulots d'étranglement de la vitesse des développeurs, la complexité de l'infrastructure, l'efficacité de l'équipe et la conformité en matière de sécurité, permettant aux organisations de déployer, gérer et faire évoluer les solutions d'IA avec confiance et rapidité.

Systèmes RAG
Visits 7.2KFavorites 146Likes 165

About Systèmes RAG

Les Systèmes RAG sont des outils basés sur l'IA qui améliorent les grands modèles de langage (LLM) en intégrant des informations externes et à jour. Ils fonctionnent en récupérant des données pertinentes à partir d'une base de connaissances avant que le LLM ne génère une réponse, améliorant considérablement la précision et réduisant les hallucinations. Cette approche permet aux LLM de tirer parti d'informations propriétaires ou spécifiques à un domaine, les rendant plus fiables et contextuellement conscients pour des applications spécialisées.

Fonctionnalités Clés

  • Récupération d'informations : Recherche et extrait efficacement des documents ou des extraits de données pertinents à partir de vastes bases de connaissances externes.
  • Augmentation contextuelle : Intègre les informations récupérées directement dans l'invite du LLM, fournissant un contexte riche pour la génération.
  • Réduction des hallucinations : Fonde les réponses du LLM sur des données factuelles et vérifiables, minimisant la génération d'informations incorrectes ou fabriquées.
  • Accès aux données propriétaires : Permet aux LLM d'utiliser des sources de données privées, spécifiques à un domaine ou en temps réel non incluses dans leur formation originale.
  • Citation des sources : Fournit souvent des références aux documents sources originaux, améliorant la transparence et la fiabilité.

Cas d'Utilisation

Les systèmes RAG sont cruciaux pour les applications nécessitant une précision factuelle et un accès à des connaissances spécifiques. Ils sont largement adoptés dans la recherche d'entreprise, les chatbots de support client, la recherche juridique et les systèmes d'information médicale, où des réponses précises et vérifiables sont primordiales.

Comment Choisir

Lors de la sélection d'un système RAG, tenez compte de la taille et de la complexité de votre base de connaissances, de la vitesse et de la précision de récupération requises, des capacités d'intégration avec les LLM et les sources de données existants, et de la facilité de gestion et de mise à jour des données récupérées. Évaluez également la capacité du système à gérer divers formats de données et son évolutivité.

Systèmes RAG use cases

1

Création de Chatbots de Connaissances d'Entreprise

Les grandes organisations peuvent déployer des systèmes RAG pour alimenter des chatbots internes qui fournissent aux employés des réponses précises à partir des documents, politiques et bases de données internes de l'entreprise. Cela réduit la charge de travail du personnel de support et assure une diffusion cohérente de l'information, améliorant l'efficacité opérationnelle et le libre-service des employés.

2

Amélioration du Support Client avec des Informations à Jour

Les départements de service client utilisent les systèmes RAG pour équiper les chatbots IA d'informations produit en temps réel, de guides de dépannage et d'historiques clients. Cela permet aux chatbots d'offrir un support précis et personnalisé, résolvant rapidement les requêtes complexes et améliorant la satisfaction client sans nécessiter de réentraînement constant du LLM.

3

Automatisation de l'Analyse et de la Requête de Documents Juridiques

Les professionnels du droit peuvent tirer parti des systèmes RAG pour interroger de vastes bibliothèques de précédents juridiques, de jurisprudence et de contrats. Le système récupère les clauses ou les cas pertinents, permettant aux LLM de résumer les conclusions ou de répondre à des questions juridiques spécifiques avec une grande précision et une citation appropriée, accélérant considérablement la recherche.

4

Développement de Contenus Éducatifs Personnalisés

Les éducateurs et les plateformes d'e-learning peuvent utiliser les systèmes RAG pour générer des explications ou des supports d'étude adaptés en fonction de programmes spécifiques et des requêtes des étudiants. En récupérant des sections de manuels scolaires ou des articles académiques pertinents, le système garantit que le contenu généré est précis, complet et aligné sur les objectifs d'apprentissage.

5

Alimentation de la Récupération d'Informations en Recherche et Développement

Les équipes de R&D dans des domaines comme la pharmacie ou l'ingénierie utilisent les systèmes RAG para rechercher et synthétiser des informations provenant d'articles scientifiques, de brevets et de rapports de recherche internes. Cela aide les chercheurs à accéder rapidement aux découvertes de pointe et à éviter les efforts redondants, accélérant les cycles d'innovation.

6

Création de Contenu Dynamique pour le Marketing

Les équipes marketing peuvent utiliser les systèmes RAG pour générer du contenu très spécifique et factuel, tel que des descriptions de produits, des articles de blog ou des textes publicitaires, en récupérant des détails à partir des spécifications de produits, des études de marché et des directives de marque. Cela garantit l'exactitude et la cohérence de tous les supports marketing.

Systèmes RAG FAQ

Que sont les Systèmes RAG ?

Les systèmes RAG (Retrieval-Augmented Generation) sont des architectures d'IA qui combinent la puissance des grands modèles de langage (LLM) avec la récupération de connaissances externes. Ils recherchent d'abord des informations dans une base de connaissances pertinente, puis utilisent ce contexte récupéré pour éclairer la réponse du LLM, ce qui conduit à des réponses plus précises, factuelles et à jour.

En quoi les Systèmes RAG diffèrent-ils du réglage fin d'un LLM ?

Le réglage fin d'un LLM implique la mise à jour des poids du modèle avec de nouvelles données, ce qui peut être coûteux et prendre du temps, surtout pour des informations qui changent fréquemment. Les systèmes RAG, en revanche, maintiennent le LLM statique et récupèrent dynamiquement des informations externes, ce qui les rend plus adaptables aux nouvelles données sans réentraînement et meilleurs pour accéder à des connaissances propriétaires ou en temps réel.

Quels sont les principaux avantages de l'utilisation des Systèmes RAG ?

Les principaux avantages incluent une réduction significative des hallucinations des LLM, une précision factuelle améliorée, l'accès à des données propriétaires ou en temps réel, une transparence accrue grâce aux citations de sources, et une meilleure rentabilité par rapport au réglage fin constant des LLM. Ils rendent les LLM plus fiables pour les applications d'entreprise et spécifiques à un domaine.

Quels types de sources de données les Systèmes RAG peuvent-ils utiliser ?

Les systèmes RAG sont très polyvalents et peuvent s'intégrer à diverses sources de données, y compris les bases de données structurées, les documents non structurés (fichiers PDF, Word), les pages web, les wikis internes, les bases de connaissances et les API. La clé est de convertir ces sources dans un format intégrable pour une récupération efficace.

Quels sont les composants clés d'un Système RAG ?

Un système RAG typique se compose de trois éléments principaux : un Récupérateur qui recherche et extrait des documents ou des extraits de données pertinents d'une base de connaissances, un Générateur (généralement un LLM) qui synthétise les informations récupérées en une réponse cohérente, et une Base de Données Vectorielle ou un index qui stocke la base de connaissances dans un format facilement consultable.