ToolMage
Connexion

Best 1 Science des données AI tools for Ingénierie des données

Popular Science des données AI tools in Ingénierie des données include DevBlogs, helping you work more efficiently.

DevBlogs

DevBlogs

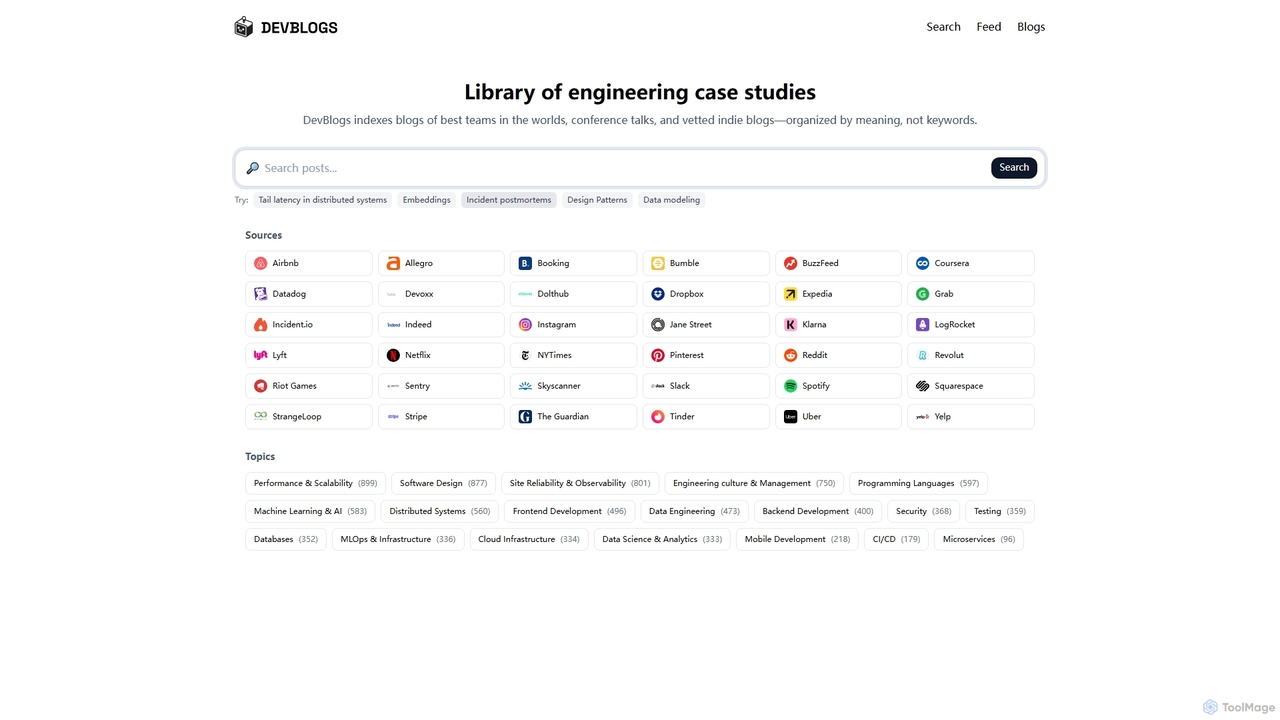
DevBlogs est une bibliothèque organisée qui indexe des études de cas d'ingénierie, des blogs techniques et des conférences de grandes équipes mondiales. Il organise le contenu par signification et par sujets techniques spécifiques, offrant une ressource précieuse aux développeurs et ingénieurs pour découvrir des informations et des meilleures pratiques.

Infrastructure
Visits 6.4KFavorites 132Likes 145

About Science des données

Les outils de Science des Données sont une catégorie spécialisée de logiciels conçus pour analyser des données complexes, construire des modèles prédictifs et extraire des informations exploitables. Ces outils intègrent des algorithmes statistiques, des bibliothèques d'apprentissage automatique (ML) et des capacités de visualisation interactive pour découvrir des modèles et des tendances. Ils permettent aux scientifiques des données et aux analystes d'aller au-delà du simple reporting de données, leur permettant de prévoir les résultats futurs, de classifier les informations et de soutenir la prise de décision basée sur les données. En tant que composant clé du cycle de vie de l'Ingénierie des Données, ils opèrent sur des données nettoyées et préparées pour effectuer des analyses avancées.

Fonctionnalités Clés

  • Développement et Entraînement de Modèles : Construire, entraîner et valider des modèles d'apprentissage automatique comme la régression, la classification et le clustering.
  • Exploration Interactive des Données : Utiliser des notebooks (ex. Jupyter) et des bibliothèques de visualisation pour une analyse et une découverte approfondies des données.
  • Analyse Statistique : Effectuer des tests statistiques complexes, des tests d'hypothèses et de la modélisation de probabilités.
  • Ingénierie des Caractéristiques : Créer, sélectionner et transformer des variables pour améliorer la précision et les performances des modèles prédictifs.
  • Déploiement et Surveillance : Empaqueter et déployer des modèles dans des environnements de production et surveiller leurs performances dans le temps.

Cas d'Utilisation

Les outils de Science des Données sont cruciaux dans des secteurs comme la finance pour la détection de fraude, le commerce électronique pour la création de moteurs de recommandation, la santé pour la prédiction de maladies et le marketing pour l'analyse de l'attrition client. Ils sont principalement utilisés par les scientifiques des données, les ingénieurs en apprentissage automatique, les analystes quantitatifs et les chercheurs universitaires pour résoudre des problèmes complexes avec des données.

Comment Choisir

Lors de la sélection d'un outil de Science des Données, tenez compte de la gamme d'algorithmes et de bibliothèques pris en charge (ex. TensorFlow, PyTorch, scikit-learn), de l'intégration avec les sources de données et les plateformes MLOps, de l'évolutivité pour les grands ensembles de données, des fonctionnalités de collaboration et de l'adéquation de l'interface utilisateur pour les flux de travail de codage et à faible code.

Science des données use cases

1

Prédire le Taux d'Attrition des Clients pour les Services d'Abonnement

Un analyste marketing d'une entreprise SaaS utilise une plateforme de science des données pour analyser les données de comportement des utilisateurs, y compris la fréquence de connexion, l'utilisation des fonctionnalités et l'historique des tickets de support. Il construit un modèle de classification binaire (comme la Régression Logistique ou le Gradient Boosting) pour identifier les clients à haut risque d'attrition. Le résultat du modèle fournit un score de probabilité pour chaque utilisateur, permettant à l'équipe marketing de lancer de manière proactive des campagnes de rétention ciblées pour les segments à haut risque, réduisant ainsi le taux d'attrition mensuel d'un pourcentage mesurable.

2

Créer un Moteur de Recommandation de Produits pour le E-commerce

Un ingénieur en apprentissage automatique d'une entreprise de vente en ligne utilise une boîte à outils de science des données pour traiter les données historiques d'achat et de navigation. En utilisant des algorithmes comme le filtrage collaboratif, il construit un modèle qui prédit les produits susceptibles d'intéresser un utilisateur. Ce moteur de recommandation est ensuite intégré aux pages de produits et au processus de paiement du site web, personnalisant l'expérience d'achat et entraînant une augmentation significative de la valeur moyenne des commandes et de l'engagement des clients.

3

Analyser le Sentiment des Avis Clients

Un chef de produit souhaite comprendre l'opinion publique sur une nouvelle fonctionnalité. Il utilise un outil de science des données doté de capacités de Traitement du Langage Naturel (NLP) pour analyser des milliers d'avis en ligne et de commentaires sur les réseaux sociaux. L'outil classe automatiquement le sentiment de chaque texte comme positif, négatif ou neutre et utilise la modélisation de sujets pour identifier les thèmes clés et les points de douleur. Cela fournit des commentaires exploitables pour l'amélioration du produit sans nécessiter des semaines de lecture et de catégorisation manuelles.

4

Détection de la Fraude Financière en Temps Réel

Un scientifique des données dans une institution financière développe un modèle de détection d'anomalies en utilisant un flux de données de transactions. La plateforme de science des données lui permet d'entraîner le modèle sur des millions de transactions historiques pour apprendre les schémas de dépenses normaux. Une fois déployé, le modèle évalue les transactions entrantes en temps réel. Les transactions qui s'écartent de manière significative du comportement normal d'un utilisateur sont signalées comme suspectes, déclenchant automatiquement des alertes pour les analystes de fraude et bloquant les activités potentiellement frauduleuses, minimisant ainsi les pertes financières.

5

Optimiser les Campagnes Marketing avec la Segmentation Client

Une équipe marketing utilise une plateforme de science des données pour effectuer une segmentation de la clientèle. En appliquant des algorithmes de clustering (comme K-Means) aux données clients — y compris les données démographiques, l'historique des achats et les interactions sur le site web — ils identifient des groupes de clients distincts. Par exemple, ils pourraient trouver des segments comme les « fidèles à haute valeur », les « acheteurs soucieux de leur budget » et les « nouveaux prospects ». Ces informations leur permettent d'adapter les messages marketing, les promotions et les recommandations de produits pour chaque segment, améliorant ainsi considérablement le retour sur investissement des campagnes et l'engagement des clients.

6

Analyse d'Images Médicales pour le Diagnostic de Maladies

Un chercheur médical utilise un cadre de science des données doté de capacités d'apprentissage profond pour aider au diagnostic. Il entraîne un Réseau Neuronal Convolutif (CNN) sur un grand ensemble de données étiquetées d'images médicales, telles que des radiographies ou des IRM, pour détecter les signes d'une maladie spécifique. Le modèle résultant peut analyser de nouvelles images et mettre en évidence les zones de préoccupation potentielles à examiner par un radiologue. Cet outil agit comme un assistant puissant, aidant à améliorer la précision du diagnostic et à accélérer le processus d'examen pour de grands volumes de scanners.

Science des données FAQ

Que sont les outils de Science des Données ?

Les outils de Science des Données sont des applications logicielles qui fournissent un environnement intégré aux scientifiques des données pour analyser les données, construire des modèles d'apprentissage automatique et en tirer des informations. Ils combinent des fonctionnalités telles que la manipulation de données, l'analyse statistique, l'entraînement de modèles et la visualisation. Contrairement aux outils généraux de veille stratégique (BI) qui se concentrent sur le reporting historique, les outils de science des données sont axés sur l'analyse prédictive et prescriptive pour prévoir les événements futurs et recommander des actions.

Quelle est la différence entre les outils de Science des Données et d'Ingénierie des Données ?

Les outils d'Ingénierie des Données se concentrent sur l'infrastructure pour déplacer et préparer les données. Ils gèrent des tâches comme l'ETL (Extraire, Transformer, Charger), la construction de pipelines de données et la gestion d'entrepôts de données. Leur objectif est de fournir des données propres et fiables. En revanche, les outils de Science des Données consomment ces données préparées pour effectuer des analyses, construire des modèles prédictifs et mener des expériences. Dans un flux de travail typique, l'ingénierie des données précède la science des données, créant la base sur laquelle l'analyse et la modélisation peuvent être effectuées.

Comment choisir le bon outil de Science des Données ?

Le choix du bon outil dépend de vos besoins spécifiques. Considérez ces facteurs clés :

  • Support des Langages et Bibliothèques : Prend-il en charge vos langages préférés (par ex. Python, R) et les bibliothèques essentielles (par ex. TensorFlow, PyTorch, Scikit-learn) ?
  • Évolutivité : Peut-il gérer efficacement la taille de vos ensembles de données et les exigences de calcul de vos modèles ?
  • Fonctionnalités de Collaboration : Permet-il aux équipes de partager facilement des projets, du code et des résultats ?
  • Interface Utilisateur : Offre-t-il une interface adaptée à votre équipe, comme des notebooks interactifs, une interface graphique par glisser-déposer ou un IDE puissant ?
  • Intégration : Dans quelle mesure se connecte-t-il à vos sources de données existantes, à votre stockage cloud et à vos plateformes de déploiement (MLOps) ?
Quelles sont les bibliothèques couramment utilisées dans les outils de Science des Données ?

La plupart des plateformes de science des données s'intègrent avec ou sont construites sur des bibliothèques open-source populaires. Pour Python, les plus courantes sont :

  • Pandas : Pour la manipulation et l'analyse de données.
  • NumPy : Pour le calcul numérique avec des tableaux et des matrices.
  • Matplotlib & Seaborn : Pour la visualisation de données.
  • Scikit-learn : Pour une large gamme d'algorithmes d'apprentissage automatique.
  • TensorFlow & PyTorch : Pour l'apprentissage profond et la construction de réseaux de neurones.

Pour R, les bibliothèques populaires incluent dplyr, ggplot2 et caret.

Qui sont les principaux utilisateurs des outils de Science des Données ?

Ces outils sont principalement conçus pour les professionnels ayant des compétences en analyse et en programmation. Les utilisateurs clés incluent :

  • Scientifiques des Données : Pour le développement de modèles de bout en bout, de l'exploration des données à l'expérimentation et la validation.
  • Ingénieurs en Apprentissage Automatique : Pour la construction, le déploiement et la maintenance de modèles de niveau production.
  • Analystes de Données : Pour effectuer des analyses statistiques avancées et créer des visualisations complexes.
  • Analystes Quantitatifs (Quants) : Pour développer des modèles financiers dans des secteurs comme la banque et l'investissement.
  • Chercheurs Universitaires : Pour mener des recherches quantitatives et tester des hypothèses avec des données.