
ToolMage
Connexion

Best 1 Base de données vectorielle AI tools for Science des données

Popular Base de données vectorielle AI tools in Science des données include PostgresML, helping you work more efficiently.

PostgresML
Freemium

PostgresML

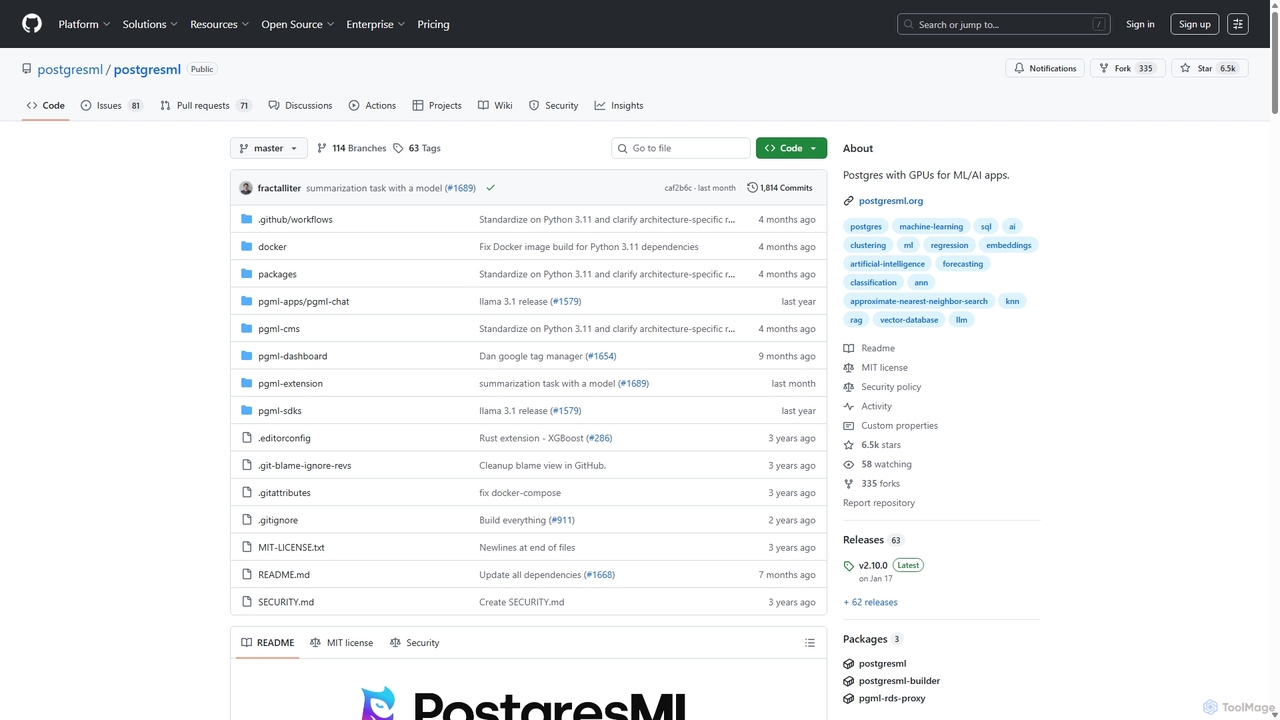
PostgresML est une puissante extension open-source qui intègre l'apprentissage automatique et l'IA directement dans votre base de données PostgreSQL. Elle permet l'inférence accélérée par GPU, la recherche vectorielle et des pipelines RAG complets à l'aide de simples commandes SQL, éliminant le mouvement des données et simplifiant la pile MLOps pour des applications IA performantes et évolutives.

MLOps
Visits 6.4KFavorites 137Likes 137

About Base de données vectorielle

Une base de données vectorielle est une base de données spécialisée conçue pour stocker, gérer et rechercher efficacement des plongements vectoriels de haute dimension. Contrairement aux bases de données traditionnelles qui effectuent des requêtes basées sur des correspondances exactes, les bases de données vectorielles utilisent des algorithmes de recherche des plus proches voisins approximatifs (ANN) pour trouver des éléments en fonction de leur similarité sémantique. Cela permet aux applications de comprendre le contexte et les relations dans des données complexes et non structurées comme le texte, les images et l'audio. En tant que composant clé de la pile technologique IA moderne, elles alimentent des fonctionnalités avancées telles que la recherche sémantique, les moteurs de recommandation et la mémoire à long terme pour les grands modèles de langage (LLM).

Fonctionnalités Clés

  • Stockage de Vecteurs de Haute Dimension : Gère et indexe nativement des vecteurs avec des centaines ou des milliers de dimensions, qui sont des sorties courantes des modèles d'IA.
  • Recherche des Plus Proches Voisins Approximatifs (ANN) : Fournit une recherche de similarité ultra-rapide en trouvant les vecteurs les plus « proches » dans la base de données, permettant des performances en temps réel sur des ensembles de données massifs.
  • Filtrage de Métadonnées : Combine la recherche de similarité vectorielle avec le filtrage traditionnel basé sur les attributs, permettant des requêtes complexes comme « trouver des images similaires à celle-ci, mais uniquement celles étiquetées 'extérieur' ».
  • Évolutivité et Performance : Conçue pour une mise à l'échelle horizontale afin de gérer des milliards de vecteurs tout en maintenant des réponses aux requêtes à faible latence.
  • Indexation en Temps Réel : Prend en charge l'ajout continu de nouveaux vecteurs de données sans dégradation significative des performances ni temps d'arrêt.

Cas d'Utilisation

Les bases de données vectorielles sont cruciales pour les développeurs et les data scientists qui créent des applications natives de l'IA. Elles sont largement utilisées dans le e-commerce pour créer des systèmes de recommandation de produits, dans les logiciels d'entreprise pour construire une recherche intelligente dans les bases de connaissances, et dans les applications d'IA générative pour fournir une mémoire à long terme aux chatbots via la Génération Augmentée par Récupération (RAG).

Comment Choisir

Lors de la sélection d'une base de données vectorielle, tenez compte de ses métriques de performance, telles que la latence des requêtes et la vitesse d'indexation. Évaluez le modèle de déploiement — que vous ayez besoin d'un service cloud entièrement géré, d'une solution auto-hébergée ou d'une option sans serveur. Évaluez également son écosystème, y compris les intégrations avec des frameworks d'IA populaires comme LangChain et LlamaIndex, ainsi que la flexibilité de ses algorithmes ANN et de ses capacités de filtrage pris en charge.

Base de données vectorielle use cases

1

Création d'une recherche sémantique pour les bases de connaissances

Une équipe de développement logiciel doit créer une fonction de recherche intelligente pour sa vaste documentation technique. Au lieu de s'appuyer sur la correspondance de mots-clés, qui ne parvient souvent pas à trouver les articles pertinents, elle utilise une base de données vectorielle. Chaque document est converti en un plongement vectoriel par un modèle d'IA. Lorsqu'un développeur recherche une requête comme « comment corriger les bogues d'authentification », le système convertit la requête en un vecteur et utilise la recherche ANN de la base de données pour trouver les vecteurs de documents sémantiquement les plus similaires. Cela fournit des résultats très pertinents, même si les mots-clés exacts ne sont pas présents, réduisant considérablement le temps de dépannage.

2

Alimenter les recommandations de produits en e-commerce

Un détaillant de mode en ligne souhaite améliorer sa fonctionnalité « Vous pourriez aussi aimer ». Il utilise un modèle d'IA multimodal pour générer des plongements vectoriels pour chaque image de produit et sa description. Ces vecteurs sont stockés dans une base de données vectorielle. Lorsqu'un client consulte un produit, le système interroge la base de données pour trouver les produits avec les vecteurs les plus similaires. Cela permet des recommandations basées sur le style visuel, les motifs de couleur et les descriptions textuelles (par exemple, « robe d'été »), créant une expérience d'achat plus engageante et personnalisée qui peut augmenter les taux de conversion.

3

Création d'une mémoire à long terme pour les chatbots IA

Une entreprise déploie un chatbot de support client IA. Pour garantir des conversations cohérentes et personnalisées, elle utilise une base de données vectorielle comme mémoire à long terme du chatbot. Les informations clés de chaque interaction utilisateur (par exemple, les préférences de l'utilisateur, les problèmes passés) sont résumées, converties en vecteur et stockées. Avant de répondre à une nouvelle requête, le chatbot recherche dans la base de données vectorielle les interactions passées pertinentes. Ce processus, connu sous le nom de Génération Augmentée par Récupération (RAG), permet au chatbot de se souvenir du contexte, d'éviter de poser des questions répétitives et de fournir un support plus utile et contextuel.

4

Mise en œuvre de la recherche visuelle pour les actifs multimédias

Une grande agence de marketing gère une bibliothèque d'actifs numériques contenant des millions d'images et de vidéos. L'étiquetage manuel de chaque actif est irréalisable. En utilisant une base de données vectorielle, ils peuvent mettre en œuvre une puissante fonction de recherche visuelle. Un modèle d'IA traite chaque image et génère un vecteur représentant son contenu visuel. Un designer peut alors télécharger une image (par exemple, une photo d'un coucher de soleil sur une ville) pour trouver tous les actifs visuellement similaires dans la bibliothèque. Ils peuvent affiner davantage la recherche avec des filtres de métadonnées, tels que « orientation horizontale » ou « contient des personnes », rationalisant ainsi le flux de travail créatif et le processus de découverte d'actifs.

5

Détection d'anomalies dans les transactions financières

Une entreprise de technologie financière vise à détecter les transactions frauduleuses en temps réel. Elle modélise chaque transaction comme un vecteur de haute dimension contenant des caractéristiques telles que le montant, l'heure, le lieu et le type de commerçant. Ces vecteurs sont diffusés en continu dans une base de données vectorielle. Le système identifie les anomalies en recherchant des vecteurs qui sont éloignés de tout groupe établi de modèles de transactions normales. Lorsqu'un nouveau vecteur de transaction est identifié comme une valeur aberrante, il est signalé pour un examen immédiat par un analyste de la fraude. Cette approche basée sur la similarité peut découvrir de nouveaux schémas de fraude que les systèmes basés sur des règles pourraient manquer.

6

Accélérer la découverte de médicaments avec la recherche moléculaire

Dans la recherche pharmaceutique, les scientifiques doivent identifier des molécules ayant des propriétés structurelles ou fonctionnelles similaires. Ils représentent de vastes bibliothèques de composés chimiques sous forme de plongements vectoriels (par exemple, des empreintes moléculaires). Un chercheur peut alors prendre une molécule cible, la convertir en sa représentation vectorielle et interroger une base de données vectorielle pour trouver les k composés les plus similaires parmi des millions de candidats. Cette recherche de similarité accélère considérablement le processus de criblage initial des nouveaux candidats-médicaments, aidant les chercheurs à concentrer leurs efforts sur les molécules les plus prometteuses et à réduire le temps de développement.

Base de données vectorielle FAQ

Qu'est-ce qu'une base de données vectorielle ?

Une base de données vectorielle est un type de base de données spécialement conçu pour stocker et interroger des vecteurs de haute dimension, également appelés plongements (embeddings). Au lieu de rechercher des correspondances exactes comme une base de données traditionnelle, elle excelle à trouver les éléments les plus similaires en se basant sur la distance mathématique entre leurs vecteurs. Cette capacité est fondamentale pour les applications d'IA telles que la recherche sémantique, les systèmes de recommandation et l'activation de la mémoire à long terme pour les grands modèles de langage (LLM) via la Génération Augmentée par Récupération (RAG).

En quoi une base de données vectorielle diffère-t-elle d'une base de données relationnelle traditionnelle (par exemple, SQL) ?

La principale différence réside dans le type de données et la méthode de requête. Une base de données relationnelle traditionnelle stocke des données structurées (comme du texte, des nombres, des dates) dans des tables et utilise SQL pour trouver des correspondances exactes basées sur des valeurs spécifiques. En revanche, une base de données vectorielle stocke des données non structurées représentées sous forme de vecteurs numériques et utilise des algorithmes de recherche des plus proches voisins approximatifs (ANN) pour trouver des données sémantiquement « similaires » ou « proches » d'un vecteur de requête. Les bases de données SQL sont destinées aux requêtes structurées et à l'intégrité des données, tandis que les bases de données vectorielles sont destinées à la recherche de similarité sur des données complexes.

Quelles sont les fonctionnalités clés à rechercher lors du choix d'une base de données vectorielle ?

Lors de la sélection d'une base de données vectorielle, tenez compte de ces facteurs critiques :

  • Performance : Évaluez la latence des requêtes (la vitesse à laquelle elle renvoie les résultats) et la vitesse d'indexation (la vitesse à laquelle elle peut ajouter de nouvelles données).
  • Évolutivité : Évaluez sa capacité à gérer le volume de données attendu (des milliards de vecteurs) et la charge de requêtes sans dégradation des performances.
  • Modèle de déploiement : Choisissez entre un service cloud entièrement géré pour la facilité d'utilisation, une option auto-hébergée pour un contrôle maximal, ou un modèle sans serveur pour une mise à l'échelle flexible.
  • Filtrage et recherche hybride : Vérifiez la présence de capacités de filtrage de métadonnées robustes pour combiner la recherche de similarité avec des requêtes structurées.
  • Écosystème et intégrations : Assurez-vous qu'elle s'intègre bien à votre pile technologique existante, y compris les frameworks d'IA comme LangChain ou LlamaIndex et les plateformes cloud.
Qui utilise les bases de données vectorielles ?

Les bases de données vectorielles sont principalement utilisées par les ingénieurs en IA/ML, les data scientists et les développeurs de logiciels qui créent des applications dotées de fonctionnalités alimentées par l'IA. Par exemple, une équipe développant un chatbot d'IA générative utiliserait une base de données vectorielle pour sa mémoire (RAG). L'équipe de science des données d'une entreprise de commerce électronique en utiliserait une pour construire un moteur de recommandation. Une entreprise de logiciels l'utiliserait pour alimenter une fonction de recherche sémantique dans la documentation d'aide de son produit. Essentiellement, toute personne travaillant avec des plongements de modèles d'IA pour activer des fonctionnalités basées sur la similarité est un utilisateur potentiel.

Qu'est-ce qu'un 'plongement' (embedding) dans le contexte d'une base de données vectorielle ?

Un 'plongement' (embedding) est une représentation numérique de données complexes, telles qu'un mot, une phrase, une image ou un clip audio, sous la forme d'un vecteur de haute dimension (une liste de nombres). Ces plongements sont générés par des modèles d'IA (comme les grands modèles de langage ou les modèles de vision par ordinateur) et sont conçus pour capturer la signification sémantique ou les caractéristiques des données originales. L'idée clé est que des éléments similaires auront des plongements proches les uns des autres dans l'espace vectoriel. Le travail principal d'une base de données vectorielle est de stocker ces plongements et de trouver les plus proches très rapidement.