ToolMage
Connexion

Best 2 Recherche vectorielle AI tools for Données

Popular Recherche vectorielle AI tools in Données include Milvus et Ducky, helping you work more efficiently.

Milvus
Freemium

Milvus

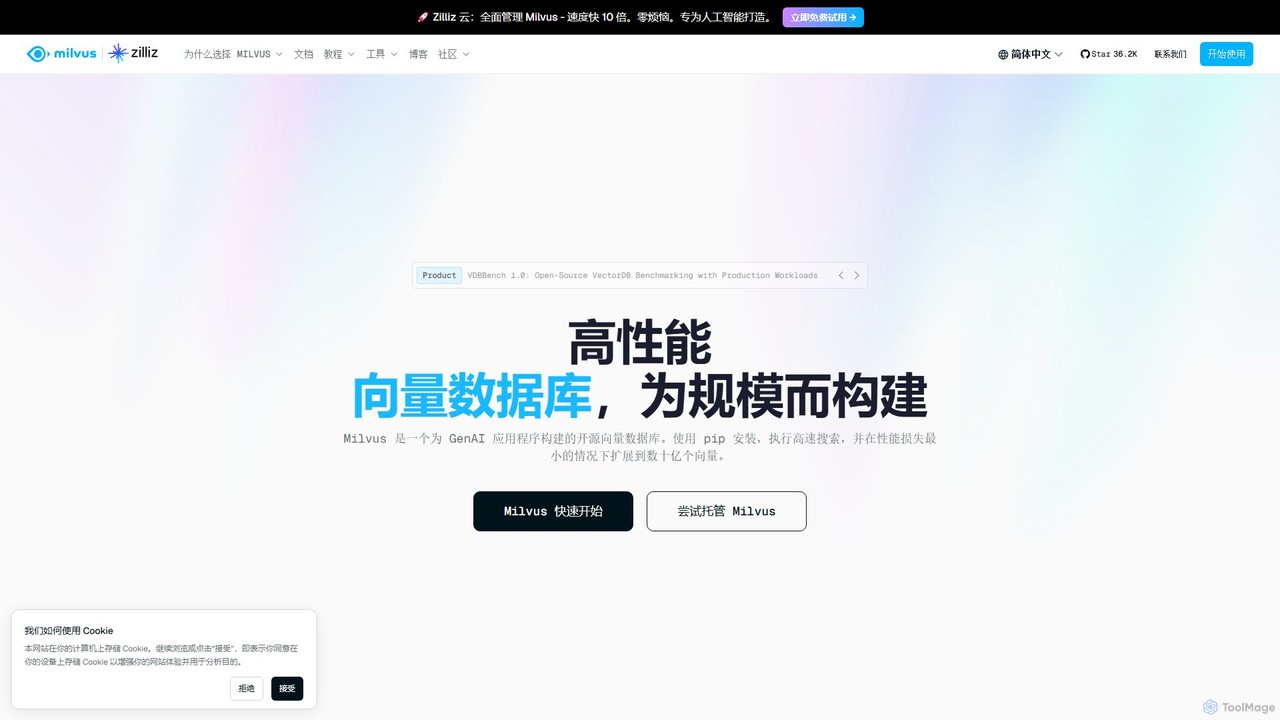
Milvus est une base de données vectorielle open-source haute performance conçue pour les applications d'IA. Elle permet aux développeurs de gérer et de rechercher des milliards de vecteurs de haute dimension avec une latence minimale. Idéale pour construire des systèmes évolutifs comme la génération augmentée par récupération (RAG), les moteurs de recommandation et la recherche sémantique, Milvus offre des options de déploiement flexibles, du prototypage local aux clusters distribués à grande échelle.

Apprentissage automatique
Visits 537KFavorites 123Likes 143
Ducky
Freemium

Ducky

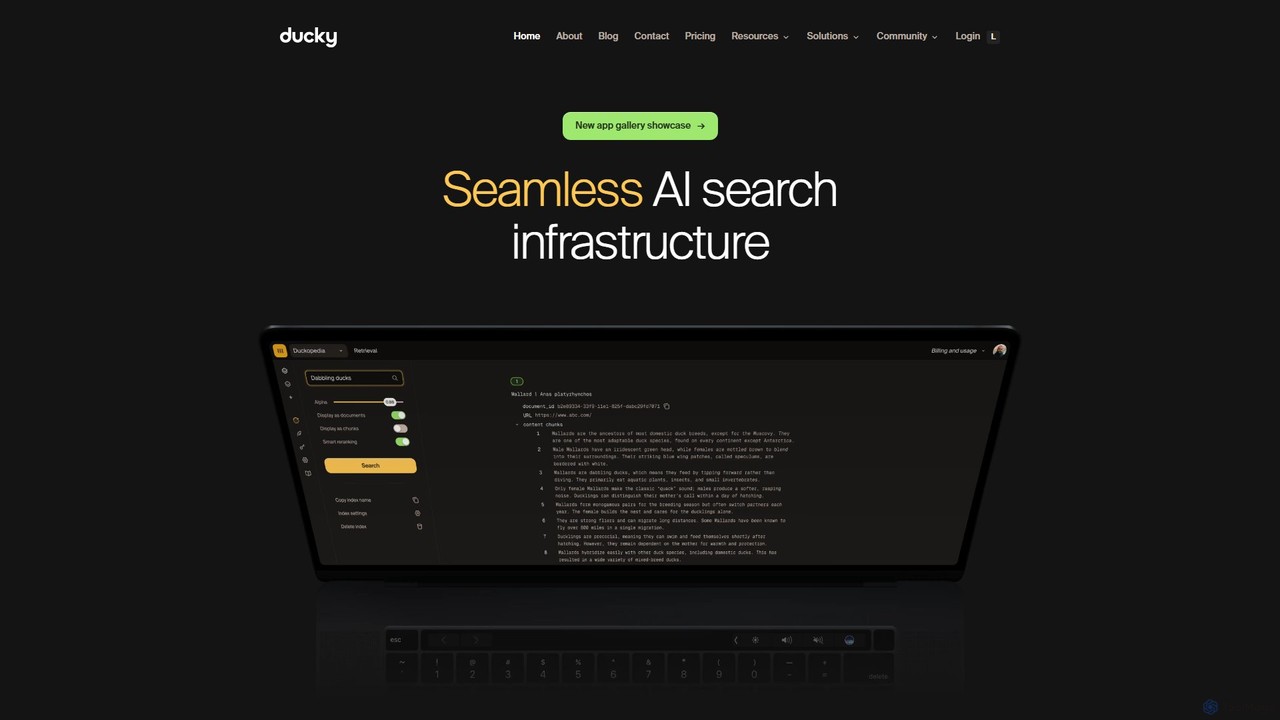
Ducky est une infrastructure de recherche IA entièrement gérée, conçue pour les développeurs. Elle simplifie la mise en œuvre de la Génération Augmentée par la Récupération (RAG) en gérant des tâches complexes comme le découpage des données, l'intégration (embedding) et le reclassement. Avec un SDK Python simple, Ducky permet aux développeurs de créer rapidement des capacités de recherche sémantique rapides, précises et évolutives dans leurs applications, fournissant des réponses contextuelles et sans hallucination des LLM.

Génération Augmentée par Récupération
Visits 8.9KFavorites 109Likes 115

About Recherche vectorielle

Les outils de Recherche Vectorielle sont une classe spécialisée de systèmes de récupération de données qui trouvent des informations basées sur la similarité sémantique, et non sur de simples correspondances de mots-clés. Ils fonctionnent en convertissant des données comme le texte, les images ou l'audio en représentations numériques appelées vecteurs, puis en recherchant les vecteurs les plus proches dans un espace de haute dimension. Cela permet aux applications de comprendre le contexte et la signification, alimentant des expériences de recherche plus intuitives, des moteurs de recommandation et des bases de connaissances basées sur l'IA. Contrairement à la recherche traditionnelle, la recherche vectorielle excelle dans le traitement des requêtes complexes et des données non structurées.

Fonctionnalités Clés

  • Recherche par Similarité Sémantique : Identifie les éléments conceptuellement liés même s'ils ne partagent pas de mots-clés.
  • Indexation de Haute Dimension : Utilise des algorithmes spécialisés (comme HNSW) pour une récupération rapide parmi des milliards de vecteurs.
  • Capacités Multimodales : Prend en charge la recherche sur différents types de données, comme l'utilisation d'une image pour trouver du texte pertinent.
  • Évolutivité en Temps Réel : Conçu pour gérer des ensembles de données massifs et des charges de requêtes élevées avec une faible latence.
  • Recherche Hybride : Combine la similarité vectorielle avec le filtrage traditionnel par métadonnées ou mots-clés pour des résultats plus précis.

Cas d'Usage

La Recherche Vectorielle est cruciale pour les développeurs et les data scientists qui créent des applications d'IA modernes. Elle constitue l'épine dorsale des systèmes de Génération Augmentée par Récupération (RAG) pour les chatbots IA, des moteurs de recommandation visuelle pour le e-commerce et des plateformes de détection de contenu dupliqué. Elle est également appliquée dans la sécurité pour la détection d'anomalies et dans la recherche scientifique pour la correspondance de motifs dans des ensembles de données complexes.

Comment Choisir

Lors de la sélection d'un outil de Recherche Vectorielle, tenez compte de son évolutivité et de ses performances sous la charge attendue. Évaluez les algorithmes d'indexation pris en charge et leurs compromis entre vitesse et précision. Analysez ses capacités d'intégration avec les modèles d'embedding et l'infrastructure de données existante. Comparez également les options de déploiement (géré dans le cloud, auto-hébergé) ainsi que les modèles de tarification et la charge technique associés.

Recherche vectorielle use cases

1

Alimenter les bases de connaissances des chatbots IA (RAG)

Un développeur IA est chargé de créer un chatbot de support client capable de répondre à des questions complexes basées sur une vaste bibliothèque de documents techniques. Au lieu d'affiner un grand modèle de langage, il utilise un système de recherche vectorielle. D'abord, tous les documents sont segmentés et convertis en embeddings vectoriels. Lorsqu'un utilisateur pose une question, celle-ci est également convertie en vecteur. Le système effectue alors une recherche vectorielle pour trouver les segments de document sémantiquement les plus similaires. Ces segments pertinents sont fournis comme contexte à un modèle de langage, qui génère ensuite une réponse précise et basée sur des sources. Cette approche, connue sous le nom de Génération Augmentée par Récupération (RAG), améliore considérablement la précision des réponses et réduit les hallucinations.

2

Recommandation Visuelle de Produits pour l'E-commerce

Une plateforme de commerce électronique souhaite améliorer sa fonctionnalité de « produits similaires ». Les méthodes traditionnelles basées sur les étiquettes et les catégories ne parviennent souvent pas à capturer les nuances visuelles. En mettant en œuvre un moteur de recherche vectorielle, ils convertissent chaque image de produit en un embedding vectoriel. Lorsqu'un client consulte un produit, le vecteur de son image est utilisé pour interroger la base de données à la recherche des voisins les plus proches. Le résultat est une liste de produits visuellement similaires en termes de style, de couleur et de motif, même si leurs descriptions de métadonnées sont complètement différentes. Cela conduit à une expérience utilisateur plus engageante, une découverte de produits accrue et des taux de conversion plus élevés, car les clients peuvent facilement trouver des alternatives qui correspondent à leurs préférences esthétiques.

3

Dédoublonnage et Découverte de Contenu

Une grande entreprise de médias gère des millions d'articles et d'images. Elle fait face à deux défis : empêcher le téléchargement de contenu en double et aider les utilisateurs à découvrir des articles connexes. Ils utilisent une base de données de recherche vectorielle pour stocker les embeddings de tout leur contenu. Lorsqu'un nouvel article est soumis, son contenu est converti en vecteur et comparé à la base de données. Si un vecteur très proche existe déjà, l'article est signalé comme un doublon potentiel, ce qui permet de gagner du temps de rédaction. Pour les lecteurs, lorsqu'ils terminent un article, son vecteur est utilisé pour trouver d'autres articles au contenu sémantique similaire, offrant des suggestions de « lecture suivante » plus pertinentes que de simples liens basés sur des catégories.

4

Détection d'Anomalies en Cybersécurité

Un analyste en cybersécurité doit surveiller le trafic réseau pour détecter des activités inhabituelles pouvant indiquer une menace. Il utilise un système de recherche vectorielle pour modéliser le comportement normal du réseau. Chaque événement réseau (comme une tentative de connexion ou un transfert de données) est converti en un vecteur basé sur ses attributs. Au fil du temps, ces vecteurs forment des clusters représentant les opérations normales. Le système convertit continuellement les nouveaux événements en vecteurs et recherche leurs plus proches voisins. Si le vecteur d'un nouvel événement est éloigné de tout cluster existant (c'est-à-dire qu'il n'a pas de voisins proches), il est signalé comme une anomalie pour une enquête immédiate. Cela permet de détecter des menaces nouvelles et de type zero-day que les systèmes basés sur les signatures manqueraient.

5

Moteurs de Recherche d'Images Inversée

Un journaliste doit vérifier l'authenticité d'une photo circulant sur les réseaux sociaux. Il utilise un outil de recherche d'images inversée alimenté par la recherche vectorielle. Le journaliste télécharge l'image, qui est instantanément convertie en un embedding vectoriel par l'outil. Ce vecteur est ensuite utilisé pour rechercher dans une base de données massive et pré-indexée d'images provenant de tout le web. La recherche renvoie des images visuellement similaires en quelques millisecondes, permettant au journaliste d'identifier la source originale, le contexte et la date de la photo. Ce processus aide à lutter contre la désinformation en démystifiant rapidement les images fausses ou hors contexte, une tâche qui serait impossible avec une recherche par mots-clés.

6

Accélérer la Découverte de Médicaments et la Génomique

Un bio-informaticien recherche des composés chimiques ayant des propriétés similaires à une molécule nouvellement découverte. Représenter les molécules sous forme d'embeddings vectoriels basés sur leurs propriétés structurelles et chimiques permet des recherches de similarité à très grande échelle. Le chercheur saisit le vecteur de la nouvelle molécule dans une base de données de recherche vectorielle contenant des millions de composés connus. Le système renvoie une liste classée des molécules les plus similaires, réduisant considérablement le nombre de candidats pour les tests en laboratoire. Ce même principe s'applique à la génomique, où la recherche vectorielle peut identifier des séquences de gènes avec des motifs fonctionnels similaires, accélérant ainsi la recherche sur les maladies et les traitements.

Recherche vectorielle FAQ

Qu'est-ce que la Recherche Vectorielle ?

La Recherche Vectorielle est une méthode de récupération d'informations basée sur la signification sémantique et le contexte, plutôt que sur des correspondances exactes de mots-clés. Elle fonctionne en convertissant des données non structurées — telles que du texte, des images ou de l'audio — en représentations numériques appelées 'embeddings vectoriels'. Ces vecteurs sont ensuite stockés dans une base de données spécialisée. Lorsqu'une requête est effectuée, elle est également convertie en vecteur, et le système trouve les vecteurs dans la base de données qui sont les plus proches du vecteur de la requête dans un espace de haute dimension. Cela permet de trouver des éléments conceptuellement similaires, même s'ils utilisent des mots ou des visuels différents.

En quoi la Recherche Vectorielle diffère-t-elle de la recherche par mots-clés traditionnelle ?

La principale différence réside dans la manière dont ils interprètent les requêtes et les données. La recherche par mots-clés traditionnelle repose sur des correspondances exactes ou partielles de chaînes de texte. Elle trouve des documents contenant les mots spécifiques que vous avez saisis. La Recherche Vectorielle, en revanche, comprend la signification sémantique ou le concept derrière la requête. Elle trouve des données qui sont contextuellement et conceptuellement similaires, même si elles ne contiennent pas les mots-clés exacts. Par exemple, une recherche par mot-clé pour 'voiture' ne trouvera pas un document sur une 'automobile', mais une recherche vectorielle le fera, car elle comprend qu'il s'agit de concepts sémantiquement liés.

Comment choisir un outil ou une base de données de Recherche Vectorielle ?

Le choix du bon outil de recherche vectorielle dépend de vos besoins spécifiques. Considérez les facteurs suivants :

  • Évolutivité : Combien de vecteurs devez-vous stocker et combien de requêtes par seconde attendez-vous ? Choisissez une solution qui peut évoluer avec votre croissance.
  • Performance : Évaluez la latence (vitesse de requête) et le rappel (précision) du système. Certains systèmes offrent des paramètres ajustables pour trouver un compromis entre vitesse et précision.
  • Modèle de déploiement : Préférez-vous un service cloud entièrement géré (plus facile à configurer) ou une solution auto-hébergée (plus de contrôle et potentiellement moins chère) ?
  • Intégrations : Vérifiez sa compatibilité avec vos pipelines de données existants, vos langages de programmation et les modèles d'embedding que vous prévoyez d'utiliser.
  • Fonctionnalités : Recherchez des fonctionnalités avancées comme le filtrage de métadonnées (recherche hybride), l'indexation en temps réel et les capacités de gestion des données.
Qu'est-ce qu'un 'embedding' dans le contexte de la Recherche Vectorielle ?

Un 'embedding' (ou plongement lexical) est le vecteur numérique qui représente une donnée dans la recherche vectorielle. C'est une liste de nombres (souvent des centaines ou des milliers) qui capture l'essence sémantique de la donnée originale (comme un mot, une phrase, une image ou un clip audio). Ces embeddings sont créés par des modèles d'apprentissage profond (comme BERT pour le texte ou CLIP pour les images) qui ont été entraînés sur de vastes quantités de données. La propriété clé des embeddings est que les éléments sémantiquement similaires auront des vecteurs proches les uns des autres dans l'espace vectoriel de haute dimension, ce qui rend la recherche vectorielle possible.

Qui devrait utiliser les outils de Recherche Vectorielle ?

Les outils de Recherche Vectorielle s'adressent principalement aux développeurs, aux data scientists et aux ingénieurs en apprentissage automatique qui créent des applications nécessitant la compréhension de données non structurées. Les principaux utilisateurs incluent :

  • Développeurs d'applications IA : Ceux qui créent des chatbots, des systèmes de questions-réponses ou d'autres applications utilisant la Génération Augmentée par Récupération (RAG).
  • Plateformes de commerce électronique : Les équipes cherchant à mettre en œuvre une recherche visuelle avancée ou des recommandations de produits sémantiques.
  • Plateformes de contenu : Les entreprises qui doivent gérer de grandes bibliothèques multimédias, recommander du contenu connexe ou détecter les doublons.
  • Entreprises de cybersécurité : Les analystes et ingénieurs développant des systèmes de détection d'anomalies ou de renseignement sur les menaces.
  • Institutions de recherche : Les scientifiques dans des domaines comme la bio-informatique ou la science des matériaux qui ont besoin de trouver des motifs dans des données complexes et de haute dimension.