
ToolMage
Connexion

Best 1 Frameworks d'apprentissage automatique AI tools for Outils pour développeurs

Popular Frameworks d'apprentissage automatique AI tools in Outils pour développeurs include Darknet, helping you work more efficiently.

Darknet
Free

Darknet

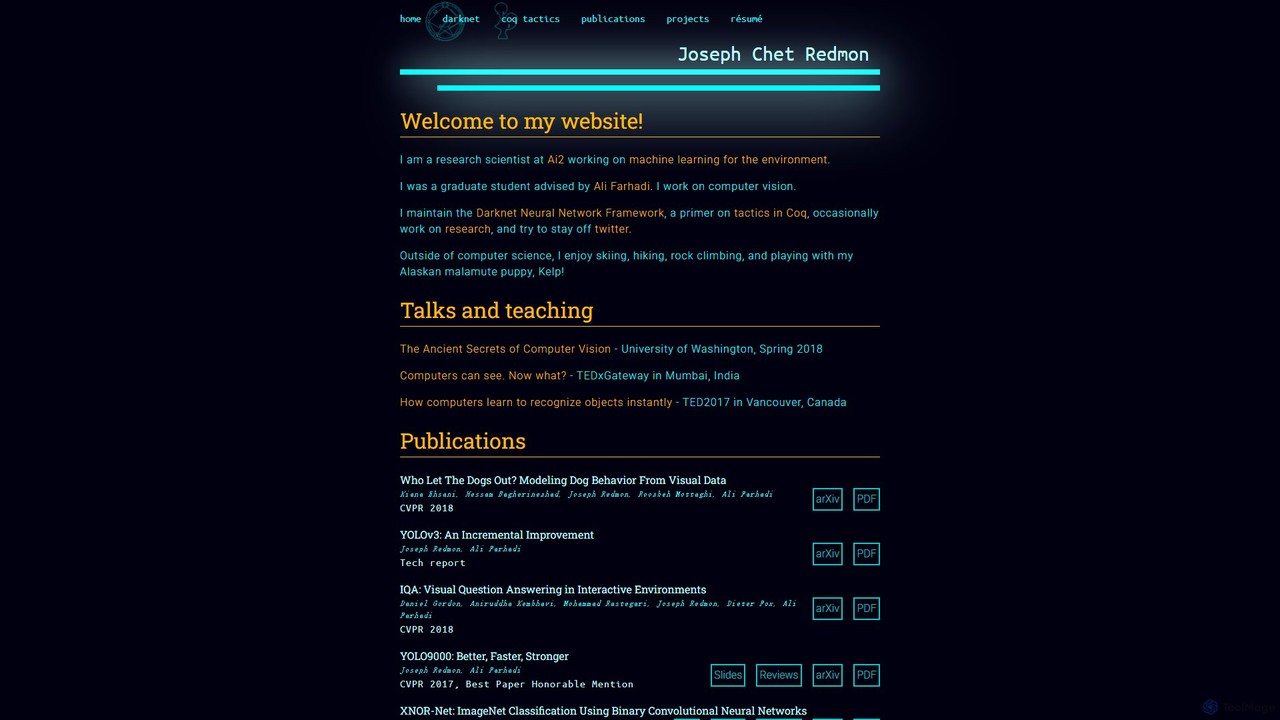
Darknet est un framework de réseau de neurones open-source et haute performance écrit en C et CUDA. Créé par Joseph Redmon, il est réputé pour sa vitesse et son efficacité, notamment pour avoir alimenté le système de détection d'objets en temps réel YOLO (You Only Look Once). Conçu pour être léger, facile à installer et prenant en charge les calculs sur CPU et GPU, il est un choix populaire pour les chercheurs et les développeurs en vision par ordinateur.

Détection d'objets
Visits 59.9KFavorites 128Likes 103

About Frameworks d'apprentissage automatique

Les frameworks d'apprentissage automatique sont des bibliothèques et des boîtes à outils complètes qui fournissent aux développeurs les éléments de base pour concevoir, entraîner et déployer des modèles d'apprentissage automatique. Ces frameworks abstraient les opérations mathématiques complexes et les interactions matérielles, offrant des composants pré-construits tels que des couches de réseaux de neurones, des optimiseurs et des fonctions d'activation. Ils accélèrent considérablement le cycle de vie du développement, permettant aux chercheurs et aux ingénieurs de passer d'un modèle conceptuel à une application prête pour la production avec une plus grande efficacité. Les fonctionnalités clés incluent souvent la différenciation automatique pour le calcul des gradients et une intégration transparente avec des accélérateurs matériels comme les GPU et les TPU.

Fonctionnalités Clés

  • Composants pré-construits : Offre une riche bibliothèque de couches, de fonctions de perte et d'optimiseurs testés et optimisés pour construire rapidement des modèles.
  • Différenciation automatique : Calcule automatiquement les gradients pour les paramètres du modèle, ce qui est essentiel pour entraîner les réseaux de neurones par rétropropagation.
  • Accélération matérielle : Fournit un support transparent pour les GPU et les TPU afin de réduire considérablement les temps d'entraînement des modèles sur de grands ensembles de données.
  • Outils de déploiement de modèles : Inclut des utilitaires pour sauvegarder, charger et servir des modèles entraînés dans des environnements de production, y compris sur site, dans le cloud et sur des appareils en périphérie.
  • Scalabilité et distribution : Prend en charge l'entraînement de modèles sur plusieurs machines ou GPU pour gérer des ensembles de données massifs et des architectures complexes.

Cas d'utilisation

Les frameworks d'apprentissage automatique sont fondamentaux pour les scientifiques des données, les ingénieurs ML et les chercheurs universitaires. Ils sont largement utilisés pour construire des systèmes de vision par ordinateur pour la reconnaissance d'images, des modèles de traitement du langage naturel (TLN) pour l'analyse de texte et la traduction, et des moteurs d'analyse prédictive pour les prévisions et les systèmes de recommandation dans des secteurs comme la technologie, la finance et la santé.

Comment choisir

Lors de la sélection d'un framework d'apprentissage automatique, tenez compte du langage de programmation principal de votre équipe, car la plupart des frameworks sont centrés sur Python. Évaluez le compromis entre la facilité d'utilisation (API de haut niveau comme Keras) et la flexibilité (API de bas niveau comme PyTorch ou le cœur de TensorFlow). Évaluez également la maturité de l'écosystème, y compris le soutien de la communauté, les modèles pré-entraînés disponibles et la facilité de déploiement sur vos plateformes cibles (par exemple, mobile, web ou cloud).

Frameworks d'apprentissage automatique use cases

1

Développement d'un modèle de reconnaissance d'images personnalisé

Une équipe de science des données dans une entreprise de commerce électronique doit catégoriser automatiquement des milliers de nouvelles images de produits chaque jour. En utilisant un framework d'apprentissage automatique comme TensorFlow ou PyTorch, ils peuvent exploiter des architectures de réseaux de neurones convolutifs (CNN) pré-entraînées. Le framework leur permet d'affiner le modèle sur leurs catégories de produits spécifiques, de gérer efficacement de grands ensembles de données d'images et d'utiliser des GPU pour entraîner le modèle en quelques heures au lieu de semaines. Le modèle final est ensuite déployé en tant que microservice à l'aide des outils de service du framework, s'intégrant directement dans leur flux de travail de téléchargement de produits.

2

Construction d'un pipeline de Traitement du Langage Naturel (TLN)

Un ingénieur logiciel est chargé de créer une fonctionnalité d'analyse des sentiments pour les avis clients. Il choisit un framework avec un support solide pour le TLN. Le framework fournit des outils pour le prétraitement du texte, la tokenisation et les couches d'intégration (embedding). Il peut facilement implémenter un réseau de neurones récurrent (RNN) ou un modèle basé sur Transformer pour classifier le sentiment. L'écosystème du framework offre des modèles de langage pré-entraînés comme BERT, qui peuvent être affinés pour atteindre rapidement une grande précision. Cette approche permet d'économiser un temps de développement considérable par rapport à la construction de l'ensemble du pipeline TLN à partir de zéro.

3

Création d'un modèle d'analyse prédictive pour la prévision des ventes

Un analyste commercial doit prévoir les ventes trimestrielles en se basant sur les données historiques, la saisonnalité et les dépenses marketing. Il utilise un framework d'apprentissage automatique pour construire un modèle de prévision de séries temporelles, tel qu'un réseau LSTM (Long Short-Term Memory). Le framework simplifie le chargement et le prétraitement des données. Il permet d'expérimenter facilement avec différentes architectures de modèles et hyperparamètres. L'analyste peut entraîner le modèle sur des années de données, puis l'utiliser pour générer des prédictions, fournissant des informations précieuses pour la gestion des stocks et la planification financière.

4

Mise en œuvre d'un moteur de recommandation

Un service de streaming multimédia souhaite améliorer l'engagement des utilisateurs en fournissant des recommandations de contenu personnalisées. Un ingénieur ML utilise un framework pour construire un modèle de filtrage collaboratif. Le framework offre des moyens efficaces de gérer les matrices d'interaction utilisateur-élément éparses et inclut des couches intégrées pour créer des plongements (embeddings) pour les utilisateurs et les éléments. Ils peuvent mettre à l'échelle le processus d'entraînement sur un cluster de machines pour gérer des millions d'utilisateurs. Le modèle résultant peut prédire quel contenu un utilisateur est susceptible d'apprécier, qui est ensuite intégré à la page d'accueil du service.

5

Accélération de la recherche académique en biologie computationnelle

Un groupe de recherche universitaire étudie le repliement des protéines à l'aide de l'apprentissage profond. Un framework d'apprentissage automatique est essentiel pour leur travail. Il leur permet d'implémenter des architectures de réseaux de neurones complexes et personnalisées décrites dans des articles scientifiques. Le support du framework pour l'entraînement distribué leur permet d'utiliser le cluster de calcul haute performance (HPC) de l'université pour entraîner leurs modèles sur des ensembles de données biologiques massifs. Cela accélère leur cycle de recherche, leur permettant de tester des hypothèses et de publier des résultats plus rapidement qu'il ne serait possible avec des outils de programmation de plus bas niveau.

6

Déploiement de modèles sur des appareils en périphérie (Edge)

Une entreprise développant des appareils domestiques intelligents doit exécuter un modèle de détection d'objets directement sur une caméra pour identifier des personnes ou des colis. Un ingénieur ML utilise un framework qui propose une version légère spécifiquement pour le déploiement mobile et en périphérie (par exemple, TensorFlow Lite). Le framework fournit des outils pour convertir et optimiser un modèle entraîné standard, réduisant sa taille et ses besoins en calcul. Cela permet au modèle de s'exécuter efficacement sur le matériel limité de l'appareil, autorisant un traitement en temps réel sans dépendre d'une connexion cloud constante, ce qui améliore la confidentialité et réduit la latence.

Frameworks d'apprentissage automatique FAQ

Qu'est-ce qu'un framework d'apprentissage automatique ?

Un framework d'apprentissage automatique est un outil logiciel ou une bibliothèque qui fournit un environnement structuré pour construire, entraîner et déployer des modèles d'apprentissage automatique. Il abstrait les complexités mathématiques de bas niveau et offre des composants pré-construits et optimisés comme des couches de réseaux de neurones et des algorithmes. Cela permet aux développeurs et aux scientifiques des données de se concentrer sur l'architecture du modèle et la logique de l'application plutôt que d'implémenter des algorithmes fondamentaux à partir de zéro, accélérant ainsi considérablement le processus de développement.

Comment choisir le bon framework d'apprentissage automatique ?

Le choix du bon framework dépend de plusieurs facteurs. Considérez les points suivants :

  • Langage de programmation : Assurez-vous que le framework prend en charge le langage principal de votre équipe (la plupart sont basés sur Python).
  • Facilité d'utilisation vs Contrôle : Les API de haut niveau (comme Keras) sont plus faciles pour les débutants, tandis que les API de bas niveau (comme PyTorch) offrent plus de flexibilité pour la recherche complexe.
  • Écosystème et communauté : Une grande communauté signifie plus de tutoriels, de modèles pré-entraînés et un support plus rapide.
  • Besoins de déploiement : Vérifiez si le framework prend en charge vos plateformes cibles, telles que les serveurs cloud, les appareils mobiles ou les navigateurs web.
  • Performance : Pour les applications à grande échelle, évaluez ses performances sur le matériel pertinent (GPU/TPU) et son support pour l'entraînement distribué.
Quelle est la différence entre un framework d'apprentissage automatique et une bibliothèque ?

Les termes sont souvent utilisés de manière interchangeable, mais il existe une distinction clé dans le flux de contrôle. Une bibliothèque (comme NumPy ou Pandas) est une collection de fonctions que votre code appelle pour effectuer des tâches spécifiques. Vous êtes en contrôle. Un framework (comme TensorFlow ou PyTorch) fournit une structure ou un squelette pour une application. Le framework appelle votre code à des points spécifiques. En apprentissage automatique, les frameworks fournissent l'ensemble du flux de travail pour la construction, l'entraînement et l'évaluation des modèles, dictant comment le processus doit être structuré, ce qui est plus complet qu'une bibliothèque typique.

Ai-je besoin d'un ordinateur puissant pour utiliser un framework d'apprentissage automatique ?

Pas nécessairement pour l'apprentissage et les petits projets. Vous pouvez commencer à apprendre et à construire des modèles simples sur un ordinateur portable standard. Cependant, pour entraîner des modèles volumineux et complexes (en particulier en apprentissage profond) sur de grands ensembles de données, un ordinateur puissant avec un GPU dédié est fortement recommandé. De nombreux frameworks s'intègrent également aux plateformes de cloud computing (comme Google Colab, AWS ou Azure), vous permettant de louer du matériel puissant à la demande, ce qui constitue une alternative rentable à l'achat d'équipements coûteux.

Qui sont les principaux utilisateurs des frameworks d'apprentissage automatique ?

Les frameworks d'apprentissage automatique sont utilisés par un large éventail de professionnels et de chercheurs. Les principaux utilisateurs comprennent :

  • Scientifiques des données : Pour prototyper, construire et valider des modèles prédictifs.
  • Ingénieurs en apprentissage automatique : Pour construire, entraîner et déployer des modèles évolutifs et prêts pour la production.
  • Développeurs de logiciels : Pour intégrer des capacités de ML dans des applications et services existants.
  • Chercheurs universitaires : Pour mener des expériences et développer de nouveaux algorithmes et architectures de modèles dans des domaines comme l'IA, la vision par ordinateur et le TLN.