ToolMage
Connexion

Best 1 Infrastructure de données AI tools for Il

Popular Infrastructure de données AI tools in Il include FactoryDB, helping you work more efficiently.

FactoryDB
Paid

FactoryDB

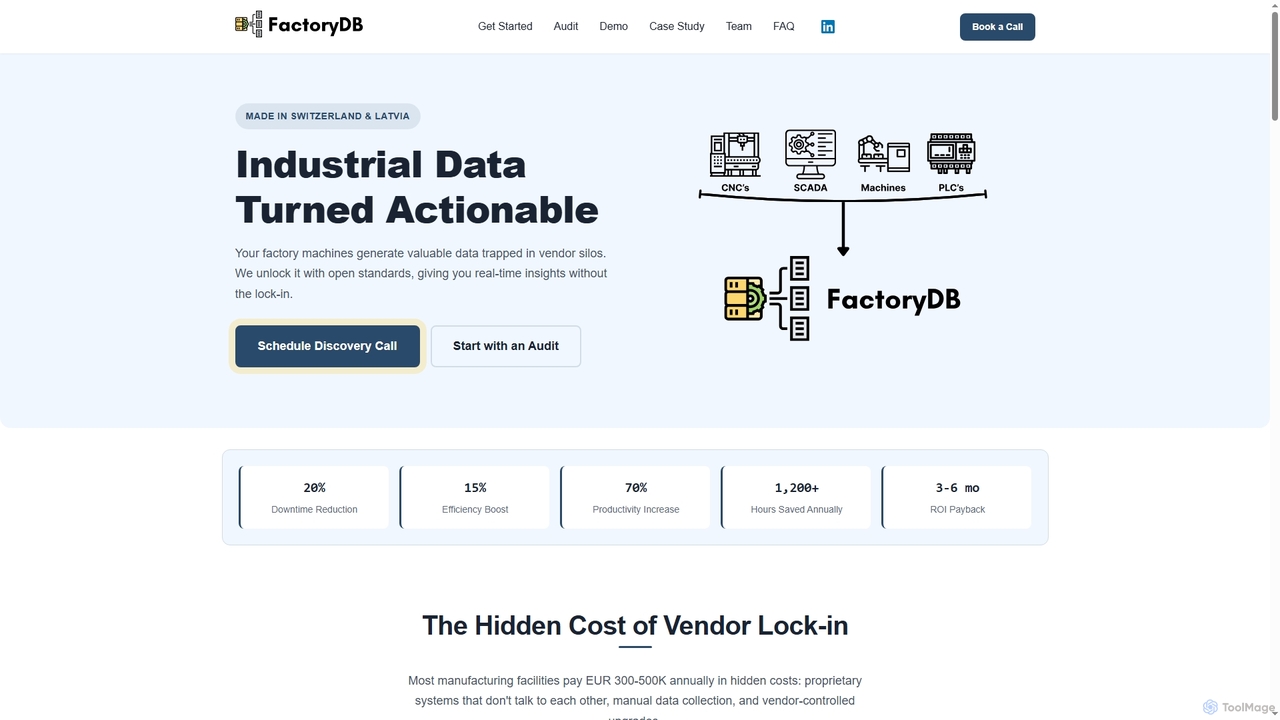
FactoryDB est une plateforme d'infrastructure de données industrielles conçue pour éliminer la dépendance vis-à-vis des fournisseurs (vendor lock-in) pour les fabricants. En utilisant des standards ouverts comme MQTT, elle unifie les données des systèmes PLC, SCADA et MES en une seule couche de données neutre. Cela permet des analyses en temps réel, une maintenance prédictive et des gains d'efficacité significatifs, en particulier pour les industries réglementées telles que la pharmacie, l'agroalimentaire et l'énergie.

3D
Visits 6.5KFavorites 135Likes 132

About Infrastructure de données

Les outils d'Infrastructure de Données sont des solutions spécialisées basées sur l'IA qui fournissent les systèmes fondamentaux pour la collecte, le stockage, le traitement et la gestion des vastes ensembles de données essentiels aux opérations d'intelligence artificielle et d'apprentissage automatique. Ces outils garantissent la disponibilité, l'intégrité et la performance des données, permettant une formation, un déploiement et une mise à l'échelle efficaces des modèles d'IA au sein du paysage informatique plus large. Ils sont essentiels pour gérer les exigences uniques des charges de travail d'IA, de l'ingestion de données en temps réel au traitement analytique complexe.

Fonctionnalités Clés

  • Stockage de Données Évolutif : Fournit des solutions de stockage distribué haute performance optimisées pour les ensembles de données d'IA à grande échelle, prenant en charge divers types de données et modèles d'accès.
  • Pipelines de Données Automatisés : Facilite la création et la gestion de pipelines automatisés d'ingestion, de transformation et de chargement (ETL) de données pour préparer les données à l'entraînement des modèles d'IA.
  • Traitement de Données en Temps Réel : Permet le traitement et l'analyse à faible latence des données en streaming, cruciaux pour les applications d'IA en temps réel comme la détection de fraude ou les systèmes de recommandation.
  • Gouvernance et Sécurité des Données : Met en œuvre des mesures de sécurité robustes, des contrôles d'accès et des cadres de conformité pour protéger les données sensibles d'entraînement d'IA et les sorties des modèles.
  • Orchestration des Ressources : Gère et optimise les ressources de calcul (GPU, CPU) et le stockage dans des environnements distribués pour une exécution efficace des charges de travail d'IA.

Scénarios d'Application

L'Infrastructure de Données est indispensable pour les organisations qui construisent et déploient l'IA. Par exemple, une grande entreprise technologique développant un nouveau modèle linguistique nécessite une infrastructure robuste pour stocker des pétaoctets de données textuelles et gérer des tâches d'entraînement distribuées sur des milliers de GPU. De même, les institutions financières l'utilisent pour le traitement en temps réel des données de transaction afin d'alimenter les systèmes de détection de fraude basés sur l'IA, garantissant une analyse et une réponse immédiates. Les plateformes de commerce électronique l'exploitent pour collecter et traiter les données d'interaction client, alimentant les moteurs de recommandation qui personnalisent les expériences utilisateur.

Comment Choisir

La sélection des bons outils d'Infrastructure de Données implique l'évaluation de plusieurs facteurs clés. Considérez l'évolutivité requise pour gérer la croissance future des données et la complexité croissante des modèles d'IA. Évaluez les besoins de performance, y compris les taux d'ingestion de données, la vitesse de traitement et la latence des requêtes, en particulier pour les applications en temps réel. Évaluez les capacités d'intégration avec les plateformes AI/ML existantes, les sources de données et les environnements cloud. Enfin, examinez attentivement les fonctionnalités de sécurité, les certifications de conformité et le coût total de possession, y compris les frais d'exploitation et la maintenance.

Infrastructure de données use cases

1

Construction de Lacs de Données Évolutifs pour l'Entraînement d'IA

Les scientifiques des données et les ingénieurs en apprentissage automatique ont besoin d'un lac de données robuste pour stocker des ensembles de données brutes et diverses (images, texte, audio, données de capteurs) à grande échelle pour l'entraînement de modèles d'IA complexes. Les outils d'infrastructure de données facilitent la création de tels lacs, offrant un stockage flexible, une gestion des métadonnées et des mécanismes de récupération de données efficaces. Cela permet un développement et une expérimentation itératifs des modèles sans goulots d'étranglement de données, garantissant une entrée de haute qualité pour les algorithmes d'apprentissage profond et réduisant les temps d'entraînement.

2

Construction de Pipelines Scalables pour l'Entraînement de Modèles d'IA

Les ingénieurs en apprentissage automatique et les scientifiques des données utilisent une infrastructure de données robuste pour construire des pipelines efficaces et évolutifs pour l'entraînement de modèles d'IA. Cela implique l'automatisation de l'ingestion de vastes ensembles de données provenant de diverses sources, la réalisation du nettoyage et de la transformation des données nécessaires, et la livraison des données préparées aux plateformes ML. Une infrastructure bien conçue garantit une qualité et une disponibilité des données constantes, réduisant considérablement le temps et les efforts requis pour le développement et le déploiement itératifs de modèles, conduisant à une innovation plus rapide et à une amélioration des performances des modèles.

3

Construction de Pipelines d'Entraînement AI/ML Évolutifs

Les scientifiques des données et les ingénieurs en apprentissage automatique exploitent l'infrastructure de données pour établir des pipelines robustes et évolutifs pour l'entraînement des modèles d'IA. Cela implique l'ingestion efficace de vastes ensembles de données provenant de diverses sources, la réalisation de transformations de données complexes (ETL) et le stockage des données préparées dans des lacs ou entrepôts de données optimisés. L'infrastructure garantit la qualité, le lignage et l'accessibilité des données, permettant une itération rapide de l'entraînement des modèles, le contrôle de version et une intégration transparente avec les plateformes d'IA, accélérant finalement le développement et le déploiement de solutions d'IA performantes.

4

Construction de Pipelines de Données Évolutifs pour l'Entraînement d'IA

Les scientifiques des données et les ingénieurs ML utilisent des outils d'infrastructure de données pour construire des pipelines automatisés qui ingèrent des données brutes de diverses sources, les nettoient, les transforment et les stockent dans des formats optimisés. Cela garantit un approvisionnement continu en données de haute qualité et prétraitées, essentielles pour l'entraînement et le réglage fin de modèles d'IA complexes, réduisant considérablement le temps de préparation manuelle des données et améliorant la précision du modèle.

5

Construire des Pipelines de Données Évolutifs pour l'Entraînement d'IA

Les scientifiques de données et les ingénieurs ML ont besoin de pipelines de données robustes pour alimenter les modèles d'IA avec des données propres et prétraitées. Les outils d'infrastructure de données permettent l'ingestion, la transformation et le chargement (ETL) automatisés de vastes ensembles de données provenant de diverses sources dans des lacs de données ou des entrepôts de données. Cela garantit un approvisionnement continu en données de haute qualité, réduisant considérablement le temps de préparation manuelle des données et accélérant le processus itératif d'entraînement et de raffinement des modèles, conduisant à des systèmes d'IA plus précis et efficaces.

6

Alimentation des Tableaux de Bord de Business Intelligence en Temps Réel

Les analystes commerciaux et les responsables des opérations s'appuient sur l'infrastructure de données pour alimenter les tableaux de bord de business intelligence (BI) en temps réel. L'infrastructure traite les données en streaming provenant des ventes, des interactions client et des systèmes opérationnels avec une faible latence, garantissant que les outils de BI affichent les métriques les plus récentes. Cela permet des informations immédiates sur les indicateurs clés de performance (KPI), permettant aux décideurs de réagir rapidement aux changements du marché, d'identifier les tendances émergentes et d'optimiser les stratégies opérationnelles sans délai, améliorant considérablement l'agilité et la réactivité de l'entreprise.

7

Analyse en Temps Réel et Intelligence Économique

Les analystes commerciaux et les décideurs ont besoin d'informations immédiates à partir des données opérationnelles pour réagir rapidement aux changements du marché. L'infrastructure de données fournit la dorsale pour le streaming et le traitement des données en temps réel, permettant l'agrégation et l'analyse instantanées des données entrantes provenant des ventes, des interactions client ou des capteurs IoT. Cette capacité prend en charge les tableaux de bord dynamiques, la détection de fraude et les expériences client personnalisées, permettant des stratégies commerciales proactives et des avantages concurrentiels.

8

Activation de l'Analyse en Temps Réel pour les Opérations Commerciales

Les analystes commerciaux et les gestionnaires d'opérations exploitent les solutions de streaming et d'entreposage de données au sein de l'infrastructure de données pour traiter et analyser instantanément les flux de données entrants. Cela permet une surveillance en temps réel des indicateurs clés de performance, une détection immédiate des fraudes et une gestion dynamique des stocks, fournissant des informations critiques pour une prise de décision agile et une réponse rapide aux changements du marché.

9

Ingestion de Données en Temps Réel pour l'Analyse Basée sur l'IA

Pour des applications telles que la détection de fraude, les recommandations personnalisées ou la surveillance IoT, les modèles d'IA ont besoin d'accéder à des flux de données frais et en temps réel. Les outils d'infrastructure de données fournissent des pipelines d'ingestion à haut débit qui capturent, traitent et livrent des données en streaming avec une latence minimale. Cela permet aux systèmes d'IA de prendre des décisions immédiates basées sur les données, en répondant aux événements au fur et à mesure qu'ils se produisent et en améliorant considérablement la réactivité et la précision des applications d'IA en temps réel.

10

Analyse en Temps Réel pour la Business Intelligence

Les analystes commerciaux et les ingénieurs de données exploitent l'infrastructure de données en temps réel pour obtenir des informations immédiates sur les performances opérationnelles et le comportement des clients. En traitant les données en streaming provenant d'applications, d'appareils IoT ou de systèmes transactionnels, les organisations peuvent surveiller les métriques clés au fur et à mesure qu'elles se produisent. Cette capacité permet une prise de décision proactive, telle que l'identification des tendances émergentes du marché, la détection d'anomalies dans les transactions financières ou la personnalisation instantanée des expériences client, offrant un avantage concurrentiel grâce à une intelligence opportune.

11

Assurer la Gouvernance et la Conformité des Données

Les responsables de la conformité et les gestionnaires de données mettent en œuvre des composants d'infrastructure de données tels que les catalogues de données, la gestion des métadonnées et les contrôles d'accès pour appliquer les politiques de gouvernance des données. Cela garantit la qualité des données, le suivi de la lignée et le respect des réglementations telles que le RGPD ou la HIPAA, atténuant les risques associés aux violations de données et à la non-conformité tout en maintenant l'intégrité des données à l'échelle de l'entreprise.

12

Stockage et Gouvernance Sécurisés des Données pour la Conformité

Les organisations qui traitent des données clients ou propriétaires sensibles, en particulier dans des secteurs réglementés comme la finance ou la santé, doivent garantir une sécurité et une conformité strictes des données. Les solutions d'infrastructure de données offrent un stockage chiffré, des contrôles d'accès granulaires, le masquage des données et des pistes d'audit pour se conformer aux réglementations telles que le RGPD ou la HIPAA. Cela protège contre les violations de données, maintient la confiance des clients et évite les amendes importantes, garantissant des pratiques de traitement des données légales et éthiques.

13

Assurer la Gouvernance et la Conformité des Données

Les responsables de la conformité et les intendants des données s'appuient sur l'infrastructure de données pour établir et faire respecter des politiques complètes de gouvernance des données, répondant aux exigences réglementaires telles que le RGPD ou la HIPAA. Ces outils fournissent des mécanismes de suivi du lignage des données, de contrôle d'accès, de masquage des données et d'audit, garantissant l'intégrité et la sécurité des données. En centralisant les efforts de gouvernance, les organisations peuvent minimiser les risques de conformité, maintenir la qualité des données et établir la confiance avec les clients et les parties prenantes, évitant ainsi des pénalités coûteuses et des atteintes à la réputation.

14

Obtenir une Vue Client à 360 Degrés pour la Personnalisation

Les équipes marketing et de service client utilisent l'infrastructure de données pour consolider les données clients disparates provenant des plateformes CRM, de vente, de médias sociaux et d'analyse web en un profil client unifié. Cette vue complète à 360 degrés permet aux entreprises de comprendre le comportement, les préférences et le parcours client sur tous les points de contact. En tirant parti de ces données intégrées, les entreprises peuvent proposer des campagnes marketing hautement personnalisées, des recommandations de produits sur mesure et un support client proactif, améliorant considérablement la satisfaction client et générant des taux de conversion et une fidélité plus élevés.

15

Orchestration des Charges de Travail d'Entraînement de Modèles d'IA Distribués

L'entraînement de modèles d'IA à grande échelle, en particulier les réseaux neuronaux profonds, nécessite souvent des ressources de calcul importantes distribuées sur plusieurs GPU ou clusters. Les solutions d'infrastructure de données incluent des capacités d'orchestration qui gèrent ces charges de travail distribuées, allouant les ressources efficacement, surveillant la progression des tâches et gérant les échecs. Cela garantit que les exécutions d'entraînement complexes sont terminées de manière fiable et optimale, maximisant l'utilisation des ressources et accélérant le cycle de développement pour l'IA avancée.

16

Migrer les Données Héritées vers des Plateformes Cloud-Natives

Les administrateurs informatiques et les architectes cloud sont souvent confrontés au défi de déplacer de grandes quantités de données historiques des systèmes sur site vers des environnements cloud modernes. Les outils d'infrastructure de données facilitent cette migration complexe en fournissant des connecteurs robustes, des mécanismes de validation des données et des capacités de transfert évolutives. Cette transition permet aux organisations de tirer parti de l'élasticité du cloud, de réduire les coûts opérationnels et de débloquer de nouvelles possibilités analytiques avec les services d'IA basés sur le cloud, modernisant ainsi leur paysage de données.

17

Assurer la Conformité Réglementaire et l'Audit des Données

Les responsables de la conformité et les équipes juridiques des secteurs réglementés, tels que la finance et la santé, s'appuient sur une infrastructure de données robuste pour répondre aux exigences réglementaires strictes comme le RGPD, HIPAA ou CCPA. L'infrastructure fournit un stockage de données sécurisé avec chiffrement, un suivi détaillé du lignage des données et des capacités d'audit complètes. Cela garantit que toutes les opérations de données sont transparentes, traçables et conformes, minimisant les risques juridiques et permettant des réponses rapides aux demandes d'audit en démontrant des politiques de traitement des données, de contrôle d'accès et de rétention appropriées.

18

Consolidation de Sources de Données Disparates dans un Lac Unifié

Les architectes d'entreprise et les ingénieurs de données utilisent des solutions de lac de données pour centraliser de vastes quantités de données structurées et non structurées provenant de divers systèmes départementaux, d'appareils IoT et de flux externes. Ce référentiel unifié facilite l'exploration complète des données et l'analyse avancée, brisant les silos de données et offrant une vue holistique pour la planification stratégique et l'innovation.

19

Consolidation des Données Provenant de Sources Disparates

Les architectes de données et les gestionnaires informatiques utilisent l'infrastructure de données pour intégrer et consolider les informations provenant de divers systèmes cloisonnés, tels que les plateformes CRM, ERP et marketing, dans un référentiel de données unifié. Ce processus implique la conception de workflows ETL/ELT efficaces pour extraire, transformer et charger les données, créant ainsi une source unique de vérité. Une vue consolidée des données facilite les rapports complets, l'analyse interfonctionnelle et soutient le développement d'applications d'IA holistiques qui exploitent toutes les données organisationnelles disponibles.

20

Assurer la Gouvernance et la Sécurité des Données pour les Ensembles de Données d'IA

Les modèles d'IA ne sont aussi bons que les données sur lesquelles ils sont entraînés, et ces données contiennent souvent des informations sensibles. Les outils d'infrastructure de données fournissent des fonctionnalités critiques pour la gouvernance des données, y compris le contrôle d'accès, le chiffrement, le masquage des données et les pistes d'audit. Cela aide les organisations à se conformer aux réglementations comme le RGPD ou la HIPAA, à protéger les données propriétaires et à maintenir l'intégrité et la confidentialité des ensembles de données utilisés pour le développement de l'IA, renforçant la confiance et atténuant les risques.

21

Optimisation du Stockage de Données pour le Coût et la Performance

Les administrateurs informatiques et les architectes cloud déploient des solutions de stockage hiérarchisé et d'archivage de données au sein de l'infrastructure de données pour gérer efficacement le cycle de vie des données. En catégorisant les données en fonction de la fréquence d'accès et des politiques de rétention, ils peuvent déplacer les données moins fréquemment consultées vers des niveaux de stockage plus rentables, équilibrant les exigences de performance avec les contraintes budgétaires et assurant la disponibilité des données à long terme.

22

Automatisation des Pipelines ETL pour l'Ingénierie des Caractéristiques en Apprentissage Automatique

Avant que les données ne puissent être utilisées pour l'apprentissage automatique, elles nécessitent souvent un nettoyage, une transformation et une ingénierie des caractéristiques approfondis. Les outils d'infrastructure de données automatisent ces processus d'extraction, de transformation et de chargement (ETL), permettant aux ingénieurs de données de construire des pipelines reproductibles qui préparent les données pour la consommation du modèle. Cela réduit l'effort manuel, assure la cohérence des données et accélère le temps d'obtention d'informations pour les projets d'apprentissage automatique, fournissant des caractéristiques bien structurées pour une performance optimale du modèle.

23

Optimisation du Stockage de Données pour le Coût et la Performance

Les architectes cloud et les équipes d'opérations de données utilisent des solutions d'infrastructure de données pour optimiser les stratégies de stockage, équilibrant l'efficacité des coûts avec les exigences de performance. Cela inclut la mise en œuvre de stockage hiérarchisé, de compression de données et de politiques intelligentes de gestion du cycle de vie des données pour déplacer les données moins fréquemment consultées vers des niveaux de stockage moins chers tout en maintenant les données critiques facilement disponibles. Une optimisation efficace du stockage réduit les dépenses cloud, améliore les vitesses de récupération des données et garantit que les ressources sont allouées efficacement en fonction de la valeur des données et des modèles d'accès.

24

Soutenir le Déploiement de Modèles d'Apprentissage Automatique à Grande Échelle

Après l'entraînement, le déploiement de modèles d'apprentissage automatique en production nécessite une couche de service de données stable et performante. L'infrastructure de données garantit que les modèles peuvent accéder aux fonctionnalités nécessaires et aux données d'inférence avec une faible latence et un débit élevé. Cela implique des magasins de données optimisés, des mécanismes de mise en cache et une intégration avec les plateformes de service de modèles. Une infrastructure bien conçue garantit que les applications d'IA déployées fournissent des prédictions et des recommandations cohérentes et en temps réel aux utilisateurs finaux.

25

Gestion des Données IoT à Grand Volume pour la Maintenance Prédictive

Les ingénieurs industriels et les responsables des opérations dans la fabrication ou la logistique exploitent l'infrastructure de données pour ingérer et traiter des volumes massifs de données générées par les capteurs IoT sur les machines, les véhicules ou les infrastructures. Ce flux de données en temps réel, incluant la température, les vibrations et les métriques de performance, est analysé pour identifier les anomalies et prédire les pannes potentielles d'équipement. En mettant en œuvre des stratégies de maintenance prédictive basées sur ces informations, les entreprises peuvent minimiser les temps d'arrêt, réduire les coûts de réparation et prolonger la durée de vie des actifs critiques, optimisant l'efficacité opérationnelle et prévenant les perturbations coûteuses.

26

Surveillance et Gestion des Performances des Applications d'IA

Une fois les modèles d'IA déployés, leurs performances et l'infrastructure de données sous-jacente nécessitent une surveillance continue. Les outils de cette catégorie offrent des capacités complètes de surveillance, de journalisation et d'alerte pour les pipelines de données, les systèmes de stockage et les ressources de calcul. Cela permet aux équipes d'exploitation d'identifier et de résoudre rapidement les goulots d'étranglement, d'assurer la santé du flux de données et de maintenir la fiabilité et l'efficacité des applications basées sur l'IA dans les environnements de production, prévenant ainsi les interruptions de service.

27

Soutien aux Projets de Migration de Données à Grande Échelle

Les chefs de projet informatique et les spécialistes de la migration utilisent une infrastructure de données robuste pour planifier et exécuter des projets de migration de données à grande échelle, tels que le déplacement de données de systèmes sur site vers le cloud ou la consolidation de plusieurs bases de données héritées. Ces outils offrent des capacités de profilage, de nettoyage, de mappage et de transfert sécurisé des données, minimisant les temps d'arrêt et garantissant l'intégrité des données tout au long du processus de migration. Une infrastructure de migration de données bien gérée atténue les risques, accélère l'achèvement du projet et assure une transition en douceur vers de nouveaux environnements de données.

28

Prise en Charge des Environnements de Données Hybrides et Multi-Cloud

Les architectes cloud et les équipes DevOps utilisent des outils d'infrastructure de données offrant une intégration et une gestion transparentes entre les plateformes sur site et multi-cloud. Cela permet aux organisations de tirer parti des meilleures fonctionnalités des différents environnements, d'assurer la portabilité des données et de maintenir la continuité des activités, offrant flexibilité et résilience pour les stratégies de données évolutives sans dépendance vis-à-vis d'un fournisseur.

29

Établissement d'un Lac de Données Évolutif pour l'Analyse Big Data

Les architectes d'entreprise et les ingénieurs de données conçoivent et mettent en œuvre une infrastructure de données pour créer des lacs de données évolutifs capables de stocker divers types de données, y compris des données brutes, semi-structurées et non structurées, à des échelles massives. Cela sert de référentiel central pour l'analyse de big data, permettant aux scientifiques des données d'effectuer des analyses exploratoires, de construire de nouveaux modèles de données et de préparer des ensembles de données pour de futurs projets d'IA sans les contraintes des entrepôts de données traditionnels. L'infrastructure du lac de données prend en charge des approches flexibles de schéma à la lecture, permettant l'agilité dans l'exploration des données et favorisant l'innovation au sein de l'organisation.

30

Gestion des Lacs de Données pour les Données Non Structurées

Les ingénieurs et chercheurs en données travaillent fréquemment avec divers types de données non structurées tels que des images, des vidéos, de l'audio et du texte, qui sont essentiels pour les applications d'IA avancées comme la vision par ordinateur et le traitement du langage naturel. L'infrastructure de données fournit des solutions de lac de données qui peuvent stocker des données brutes, avec un schéma à la lecture, à grande échelle. Cela permet une exploration et une expérimentation flexibles avec divers formats de données, permettant le développement de modèles d'IA innovants qui peuvent dériver des informations à partir d'informations auparavant inaccessibles.

Infrastructure de données FAQ

Qu'est-ce que l'Infrastructure de Données ?

L'Infrastructure de Données fait référence à l'ensemble complet de systèmes, d'outils et de processus qui permettent aux organisations de gérer, stocker, traiter et analyser de grands volumes de données de manière efficace et sécurisée. Elle constitue l'épine dorsale de toutes les initiatives basées sur les données, y compris l'analyse avancée, la business intelligence, ainsi que le développement et le déploiement de modèles d'IA et d'apprentissage automatique. Les composants clés incluent souvent des pipelines d'ingestion de données, diverses solutions de stockage (comme les lacs et entrepôts de données), des moteurs de traitement, et des outils de gouvernance et de sécurité des données.

Qu'est-ce que l'Infrastructure de Données ?

L'Infrastructure de Données fait référence à l'écosystème complet de matériel, de logiciels, de réseau et de processus qui gèrent les actifs de données d'une organisation. Elle englobe les systèmes de stockage, de traitement, d'intégration, de gouvernance et de sécurité des données, fournissant le cadre fondamental pour toutes les activités axées sur les données, y compris la business intelligence, l'analyse et les applications avancées d'IA/ML. Son objectif principal est de garantir que les données sont accessibles, fiables et évolutives pour les divers besoins organisationnels.

Qu'est-ce que l'Infrastructure de Données ?

L'Infrastructure de Données désigne l'ensemble intégré de composants matériels, logiciels et réseau conçus pour gérer, stocker, traiter et analyser les données d'une organisation. Elle comprend les bases de données, les entrepôts de données, les lacs de données, les outils ETL et les cadres de gouvernance des données, fournissant la base pour les applications axées sur les données, l'analyse et les initiatives d'IA/ML. Son objectif principal est de garantir que les données sont accessibles, fiables et sécurisées pour divers besoins commerciaux.

Qu'est-ce que l'Infrastructure de données dans le contexte de l'IA ?

L'Infrastructure de données dans le contexte de l'IA fait référence à l'ensemble complet des ressources matérielles, logicielles et réseau spécifiquement conçues pour prendre en charge les besoins exigeants en données des charges de travail d'intelligence artificielle et d'apprentissage automatique. Elle englobe les systèmes pour une collecte efficace des données, un stockage évolutif, un traitement haute performance et une gestion robuste de vastes et divers ensembles de données. Son objectif principal est de fournir une base fiable, sécurisée et performante qui garantit aux modèles d'IA un accès continu à des données de haute qualité pour l'entraînement, la validation et l'inférence, permettant le développement et le déploiement d'applications intelligentes.

Que sont les outils d'Infrastructure de Données dans le contexte de l'IA ?

Les outils d'Infrastructure de Données sont les systèmes et logiciels fondamentaux qui permettent la collecte, le stockage, le traitement et la gestion efficaces des données spécifiquement pour les charges de travail d'IA et d'apprentissage automatique. Ils fournissent l'épine dorsale nécessaire pour gérer de grands volumes de données diverses, garantissant leur qualité, leur accessibilité et leur sécurité tout au long du cycle de vie de l'IA, de l'entraînement du modèle au déploiement et à l'inférence.

Pourquoi une Infrastructure de Données robuste est-elle cruciale pour l'IA et le ML ?

Une Infrastructure de Données robuste est cruciale pour l'IA et le ML car ces technologies sont intrinsèquement gourmandes en données, nécessitant des volumes massifs de données de haute qualité et accessibles pour l'entraînement et l'inférence. Elle garantit que les modèles d'IA reçoivent des données propres, cohérentes et opportunes, évitant les scénarios de "garbage in, garbage out". De plus, elle fournit la puissance de traitement et le stockage évolutifs nécessaires pour gérer des algorithmes complexes et de grands ensembles de données, permettant un développement, un déploiement et une amélioration continue efficaces des modèles.

Comment l'IA améliore-t-elle l'Infrastructure de Données ?

L'IA améliore considérablement l'infrastructure de données en automatisant les tâches complexes, en optimisant l'utilisation des ressources et en extrayant des informations plus approfondies. Les outils basés sur l'IA peuvent automatiser les processus d'ingestion, de nettoyage et de transformation des données, réduisant ainsi les efforts manuels et les erreurs. Les algorithmes d'apprentissage automatique peuvent optimiser le stockage des données en identifiant les données chaudes et froides, en améliorant les performances des requêtes et en prédisant les besoins de stockage. De plus, l'IA peut renforcer la sécurité des données en détectant les anomalies et les menaces potentielles en temps réel, et elle permet des capacités d'analyse avancées qui transforment les données brutes en intelligence prédictive et prescriptive, rendant l'infrastructure plus intelligente et réactive.

En quoi les outils d'Infrastructure de Données diffèrent-ils de l'infrastructure informatique générale ?

Alors que l'infrastructure informatique générale offre de larges capacités de calcul et de stockage, les outils d'Infrastructure de Données sont spécifiquement optimisés pour les exigences uniques de l'IA. Ils comportent souvent des composants spécialisés pour le calcul haute performance (par exemple, des clusters GPU), des lacs de données évolutifs, des analyses de streaming en temps réel et une gouvernance des données robuste adaptée aux ensembles de données d'apprentissage automatique. Leur objectif est de gérer les charges de travail d'IA gourmandes en données, souvent distribuées et exigeantes en calcul, tandis que l'infrastructure informatique générale sert un éventail plus large d'applications d'entreprise.

Comment choisir les bons outils d'Infrastructure de données pour mon projet d'IA ?

Le choix de la bonne Infrastructure de données implique plusieurs considérations clés. Premièrement, évaluez votre volume, votre vélocité et votre variété de données pour vous assurer que l'infrastructure peut évoluer de manière adéquate. Deuxièmement, évaluez sa compatibilité et ses capacités d'intégration avec vos frameworks et outils IA/ML existants. Troisièmement, privilégiez une gouvernance des données robuste, la sécurité et les fonctionnalités de conformité, en particulier pour les données sensibles. Quatrièmement, considérez le coût total de possession, y compris la complexité opérationnelle et la maintenance. Enfin, recherchez des solutions offrant flexibilité et facilité d'utilisation, en adéquation avec l'expertise technique de votre équipe et vos plans de croissance futurs.

Comment choisir la bonne Infrastructure de Données pour mon organisation ?

Le choix de la bonne infrastructure de données implique d'évaluer plusieurs facteurs : le volume et la vélocité de vos données actuelles et futures, les besoins analytiques spécifiques (temps réel vs. batch), le budget, l'écosystème informatique existant pour l'intégration et les exigences de conformité. Considérez l'évolutivité, les performances, les fonctionnalités de sécurité, la facilité de gestion et le support du fournisseur. Une approche modulaire permettant la croissance et l'adaptation est souvent bénéfique.

En quoi l'Infrastructure de Données diffère-t-elle de l'Infrastructure Informatique traditionnelle ?

Bien que l'Infrastructure de Données soit un sous-ensemble de l'Infrastructure Informatique plus large, elle se concentre spécifiquement sur les composants et processus spécialisés pour la gestion des données, tandis que l'infrastructure informatique traditionnelle couvre toutes les ressources informatiques comme les serveurs, les réseaux et les systèmes d'exploitation. L'infrastructure de données met l'accent sur les pipelines de données, les bases de données, les lacs de données, les entrepôts de données et les outils de gouvernance adaptés à la gestion du cycle de vie des données, à l'analyse et aux charges de travail d'IA, allant au-delà de la connectivité informatique et réseau générale pour optimiser les opérations centrées sur les données.

Qu'els sont les composants clés d'une Infrastructure de données IA moderne ?

Une Infrastructure de données IA moderne comprend généralement plusieurs composants clés. Ceux-ci incluent des solutions de stockage de données évolutives comme les lacs de données et les entrepôts de données pour divers types de données. Les moteurs de traitement de données haute performance (par exemple, Spark, Flink) sont cruciaux pour la transformation et l'analyse. Les outils d'ingestion de données facilitent la collecte de données en temps réel et par lots à partir de diverses sources. Les cadres de gouvernance et de sécurité des données garantissent la conformité et la protection. De plus, la gestion des métadonnées, la catalogage des données et les outils de surveillance sont essentiels pour maintenir la qualité, la découvrabilité et l'efficacité opérationnelle des données tout au long du cycle de vie des données.

Quelle est la différence entre l'Infrastructure de Données et l'Infrastructure informatique générale ?

L'Infrastructure informatique générale englobe tous les matériels, logiciels, réseaux et installations qui soutiennent les opérations informatiques d'une organisation, y compris les serveurs, les systèmes d'exploitation et les équipements réseau. L'Infrastructure de Données est un sous-ensemble spécialisé de l'infrastructure informatique, spécifiquement axé sur les systèmes et outils de gestion des actifs de données. Alors que l'infrastructure informatique fournit l'environnement opérationnel global, l'infrastructure de données gère directement le cycle de vie des données, de l'ingestion à l'analyse, garantissant que les besoins spécifiques aux données sont satisfaits.

Quels sont les composants clés d'une Infrastructure de Données d'IA ?

Une Infrastructure de Données d'IA robuste comprend généralement plusieurs composants clés. Ceux-ci englobent des solutions de stockage de données évolutives (comme les lacs de données ou les entrepôts de données), des moteurs de traitement de données puissants (pour l'ETL, le streaming et le traitement par lots), des outils d'orchestration de flux de travail pour gérer les pipelines de données et les opérations ML (MLOps), des cadres robustes de gouvernance et de sécurité des données, ainsi que des plateformes de surveillance/observabilité pour garantir la santé et les performances du système. Le matériel spécialisé comme les GPU et les réseaux à haut débit est également crucial.

Quels sont les composants clés d'une Infrastructure de Données moderne ?

Une infrastructure de données moderne comprend généralement plusieurs composants clés fonctionnant de concert. Ceux-ci incluent des outils d'ingestion de données (pour collecter des données de diverses sources), des solutions de stockage de données (telles que des lacs de données pour les données brutes et des entrepôts de données pour les données structurées et raffinées), des moteurs de traitement de données (pour transformer et analyser les données, supportant souvent les flux en temps réel), des cadres de gouvernance des données (pour garantir la qualité, la conformité et la sécurité), et des couches d'intégration (pour se connecter aux plateformes d'analyse, aux outils AI/ML et aux applications métier). Les services natifs du cloud constituent souvent l'épine dorsale de ces composants pour la scalabilité et la flexibilité.

En quoi l'Infrastructure de Données diffère-t-elle de l'infrastructure informatique traditionnelle ?

Bien que l'infrastructure de données soit un sous-ensemble de l'infrastructure informatique plus large, sa distinction principale réside dans son orientation spécialisée sur les données. L'infrastructure informatique traditionnelle fournit les ressources générales de calcul, de réseau et de stockage pour toutes les applications d'entreprise. L'infrastructure de données, cependant, est spécifiquement optimisée pour les défis uniques de la gestion de grands ensembles de données diversifiés, prenant en charge l'ingestion de données à grand volume, les transformations complexes et les analyses avancées, souvent avec des exigences en temps réel. Elle intègre des outils spécialisés comme les lacs de données, les entrepôts de données et les moteurs de traitement de flux, qui ne sont généralement pas centraux pour l'infrastructure informatique générale, afin de permettre la prise de décision basée sur les données et les capacités d'IA.

Qui bénéficie le plus de l'utilisation des outils d'Infrastructure de Données ?

Les outils d'Infrastructure de Données bénéficient principalement aux scientifiques des données, aux ingénieurs en apprentissage automatique, aux ingénieurs de données et aux équipes d'opérations informatiques dans les organisations qui dépendent fortement de l'IA. Les scientifiques des données obtiennent un accès fiable à des données de haute qualité pour l'entraînement des modèles. Les ingénieurs ML peuvent déployer et mettre à l'échelle les modèles efficacement. Les ingénieurs de données construisent et gèrent des pipelines de données robustes. Les opérations informatiques garantissent que les systèmes sous-jacents sont performants, sécurisés et rentables, permettant finalement à l'ensemble de l'organisation d'exploiter l'IA efficacement.

Comment l'Infrastructure de données soutient-elle le développement et le déploiement de modèles d'IA ?

L'Infrastructure de données est fondamentale pour l'ensemble du cycle de vie du modèle d'IA. Pendant le développement, elle fournit l'environnement nécessaire aux scientifiques de données pour accéder, nettoyer et préparer de grands ensembles de données pour l'entraînement des modèles, impliquant souvent une ingénierie de caractéristiques complexe. Elle assure la qualité et la cohérence des données, qui sont essentielles pour la précision du modèle. Pour le déploiement, une infrastructure robuste garantit que les modèles entraînés peuvent accéder aux données d'inférence en temps réel avec une faible latence et une haute disponibilité, permettant aux applications d'IA de fournir des performances cohérentes en production. Elle prend également en charge la surveillance et le réentraînement des modèles en alimentant continuellement de nouvelles données dans le système.

Quels sont les composants clés d'une Infrastructure de Données robuste ?

Une infrastructure de données robuste comprend généralement plusieurs composants clés :

  • Stockage de Données : Bases de données (SQL/NoSQL), entrepôts de données, lacs de données.
  • Intégration de Données : Outils ETL/ELT, plateformes de streaming de données.
  • Traitement des Données : Traitement par lots (ex. Spark) et moteurs de traitement en temps réel.
  • Gouvernance des Données : Gestion des métadonnées, catalogage des données, contrôle d'accès, sécurité.
  • Surveillance et Gestion : Outils pour la gestion des performances, de la santé et des coûts.

Ces composants travaillent ensemble pour assurer un flux et une utilisation efficaces des données.

Quels sont les composants clés d'une Infrastructure de Données moderne ?

Une Infrastructure de Données moderne comprend généralement plusieurs composants clés : des solutions de stockage de données évolutives (comme les lacs de données et les entrepôts de données), des moteurs robustes d'ingestion et de traitement des données (pour ETL/ELT et les données en streaming), des outils d'intégration de données, des systèmes de gestion des métadonnées et des cadres complets de gouvernance des données. Elle intègre également souvent des ressources de cloud computing pour la flexibilité et l'évolutivité, ainsi que des mesures de sécurité pour protéger les informations sensibles tout au long de leur parcours.

Comment choisir la bonne Infrastructure de Données pour mon projet d'IA ?

Choisir la bonne Infrastructure de Données pour votre projet d'IA nécessite une considération attentive de plusieurs facteurs. Premièrement, évaluez le volume, la vélocité et la variété de vos données (3V) pour déterminer les besoins de stockage et de traitement. Deuxièmement, évaluez la compatibilité des frameworks et outils AI/ML spécifiques que vous prévoyez d'utiliser. Troisièmement, considérez les exigences d'évolutivité pour la croissance future et le besoin de traitement en temps réel. Enfin, prenez en compte le budget, la conformité en matière de sécurité, la facilité de gestion et si une solution basée sur le cloud, sur site ou hybride correspond le mieux à votre stratégie organisationnelle.

Comment l'Infrastructure de Données soutient-elle les initiatives d'IA et d'Apprentissage Automatique ?

L'Infrastructure de Données est fondamentale pour l'IA/ML en fournissant la base nécessaire à la collecte, la préparation et la livraison des données. Elle garantit que les modèles d'IA ont accès à de grands volumes de données de haute qualité, propres et bien structurées pour l'entraînement. Des fonctionnalités telles que le stockage évolutif, les pipelines de données efficaces et le streaming de données en temps réel permettent le réentraînement et le déploiement continus des modèles, impactant directement la précision et les performances des applications d'IA. Sans une infrastructure de données solide, les projets d'IA/ML sont confrontés à des problèmes de disponibilité et de qualité des données.

Quels sont les principaux défis dans la construction d'une Infrastructure de Données ?

La construction d'une infrastructure de données robuste présente plusieurs défis. Un obstacle majeur est la gestion du volume, de la vélocité et de la variété toujours croissants des données (défis du Big Data). Assurer la qualité, la cohérence et la gouvernance des données à travers des sources disparates est une autre tâche significative. La sécurité et la conformité aux réglementations évolutives en matière de confidentialité des données (ex. RGPD, CCPA) sont primordiales et complexes. De plus, l'intégration de nouveaux outils de données et de plateformes AI/ML avec les systèmes hérités existants peut être difficile, et trouver des professionnels qualifiés pour concevoir, implémenter et maintenir ces systèmes complexes reste un défi persistant pour de nombreuses organisations.

Quels défis l'Infrastructure de Données aide-t-elle à résoudre ?

L'Infrastructure de Données aide à résoudre des défis critiques tels que la gestion des volumes de données en constante augmentation, la garantie de la qualité et de la cohérence des données provenant de sources disparates, et la fourniture d'un accès rapide aux données pour l'analyse et l'IA. Elle aborde les problèmes de sécurité et de conformité des données, réduit les silos de données et permet aux organisations de faire évoluer leurs opérations de données efficacement. En fournissant une base fiable, elle atténue les risques associés à la perte de données, aux mauvaises prises de décision et à l'utilisation inefficace des ressources.

Quelle est la différence entre l'infrastructure de données traditionnelle et l'infrastructure de données spécifique à l'IA ?

Alors que l'infrastructure de données traditionnelle se concentre sur l'intelligence économique générale et les rapports opérationnels, l'infrastructure de données spécifique à l'IA est optimisée pour les exigences uniques de l'apprentissage automatique. Les systèmes traditionnels privilégient souvent les données structurées et le traitement par lots, tandis que l'infrastructure d'IA gère des volumes massifs de données diverses (structurées, non structurées, semi-structurées) avec un fort accent sur le traitement en temps réel et le calcul haute performance. L'infrastructure d'IA s'intègre également plus profondément aux plateformes ML, offrant des outils spécialisés pour le versionnement des données, les magasins de fonctionnalités et l'accélération GPU/TPU, tous conçus pour rationaliser le flux de travail de développement et de déploiement de l'IA.