
ToolMage
Connexion

Best 1 Observabilité AI tools for Opérations IT

Popular Observabilité AI tools in Opérations IT include Plural, helping you work more efficiently.

Plural
Freemium

Plural

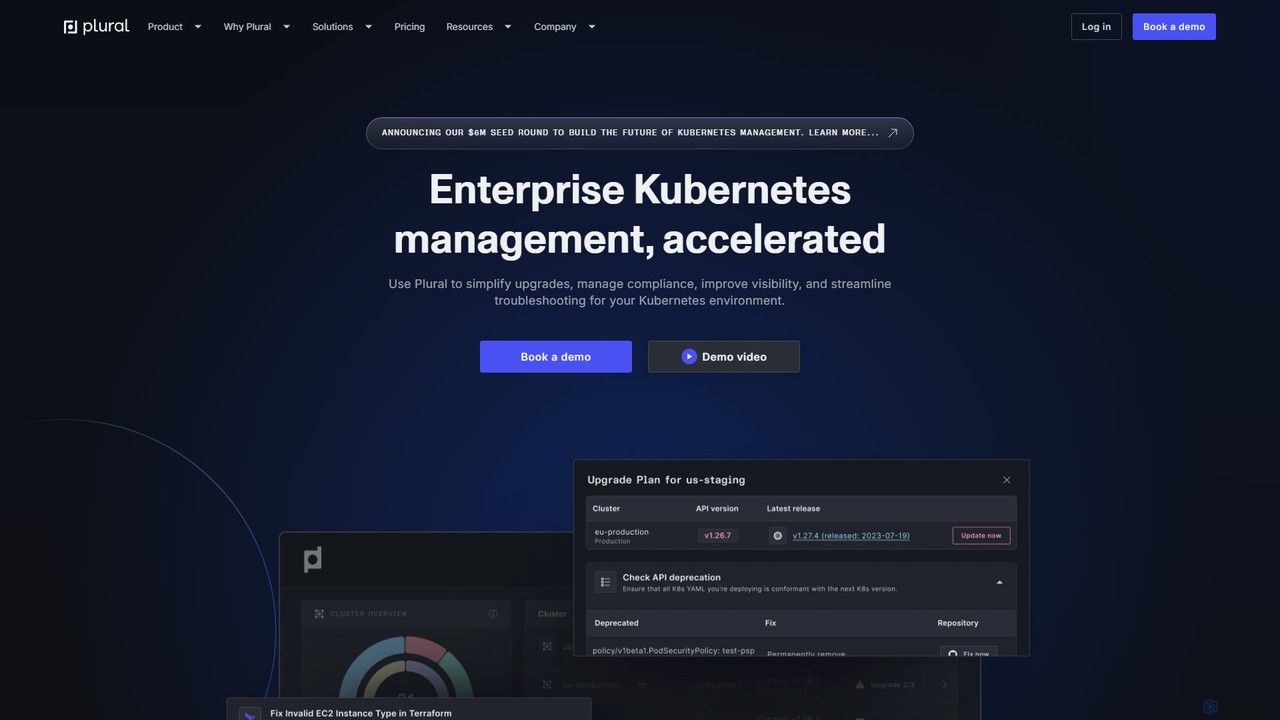
Plural est une plateforme de gestion Kubernetes d'entreprise alimentée par l'IA, conçue pour accélérer et simplifier les opérations. Elle offre une visibilité multi-cloud, automatise les mises à jour complexes, propose un dépannage piloté par l'IA et garantit une sécurité et une conformité robustes. Idéal pour les équipes DevOps et d'ingénierie de plateforme, Plural réduit les coûts opérationnels et augmente la vélocité des développeurs.

Gestion multi-cloud
Visits 66.7KFavorites 142Likes 155

About Observabilité

Les outils d'Observabilité sont des solutions basées sur l'IA conçues pour fournir des informations approfondies sur l'état interne des systèmes complexes en analysant leurs sorties externes. Ces outils exploitent les journaux (logs), les métriques et les traces pour offrir une compréhension complète du comportement des applications et des infrastructures. Ils permettent aux équipes d'opérations informatiques et de développement d'identifier les problèmes de manière proactive, de résoudre les incidents plus rapidement et d'optimiser les performances du système dans les environnements distribués modernes. En allant au-delà de la surveillance traditionnelle, l'Observabilité aide à découvrir les causes profondes des problèmes et à prédire les défaillances potentielles.

Fonctionnalités Clés

  • Gestion et Analyse des Journaux (Logs): Collecte, analyse, recherche et corrélation centralisées des données de journaux provenant de diverses sources.
  • Surveillance et Alertes de Métriques: Agrégation, visualisation et alertes en temps réel sur les indicateurs clés de performance (KPI) et les métriques de santé du système.
  • Traçage Distribué: Visibilité de bout en bout des requêtes lorsqu'elles traversent les microservices et les architectures distribuées, identifiant les latences et les erreurs.
  • Détection d'Anomalies: Identification, basée sur l'IA, de modèles inhabituels dans les données qui peuvent indiquer des problèmes émergents, souvent avant qu'ils n'affectent les utilisateurs.
  • Tableaux de Bord et Visualisation: Tableaux de bord personnalisables pour présenter des données complexes dans un format intuitif et exploitable pour des informations rapides.

Cas d'Utilisation

Les outils d'Observabilité sont essentiels pour les équipes DevOps, SRE et d'opérations informatiques gérant des applications cloud-natives, des microservices et des infrastructures complexes. Ils sont utilisés pour diagnostiquer les problèmes de production, optimiser l'utilisation des ressources et assurer la fiabilité des services. Les développeurs exploitent également ces outils pour comprendre le comportement des applications dans des scénarios réels et améliorer les performances du code.

Comment Choisir

Lors de la sélection d'une plateforme d'Observabilité, tenez compte de ses capacités d'intégration avec votre pile technologique existante, de sa scalabilité pour gérer votre volume de données et de la granularité des informations qu'elle fournit. Évaluez le modèle de coût, les politiques de rétention des données et la facilité d'utilisation de la plateforme. Recherchez des fonctionnalités telles que la détection d'anomalies basée sur l'IA, des alertes robustes et des options de visualisation personnalisables pour répondre à vos besoins opérationnels spécifiques.

Observabilité use cases

1

Accélérer l'Analyse des Causes Profondes des Incidents de Production

Les ingénieurs DevOps utilisent les outils d'Observabilité pour identifier rapidement la source des erreurs d'application ou de la dégradation des performances en production. En corrélant les journaux, les métriques et les traces distribuées à travers les microservices, ils peuvent identifier le composant exact ou le changement de code à l'origine du problème, réduisant considérablement le temps moyen de résolution (MTTR) et minimisant les interruptions de service.

2

Optimisation Proactive des Performances et Planification de la Capacité

Les équipes SRE exploitent les plateformes d'Observabilité pour surveiller en permanence les métriques de performance du système et identifier les tendances. En analysant les données historiques et les informations en temps réel, elles peuvent optimiser de manière proactive l'allocation des ressources, détecter les goulots d'étranglement potentiels avant qu'ils n'affectent les utilisateurs, et planifier précisément les besoins futurs en capacité, garantissant que le système évolue efficacement avec la demande.

3

Améliorer la Surveillance de l'Expérience Utilisateur et l'Analyse d'Impact

Les chefs de produit et les équipes de développement utilisent les outils d'Observabilité pour obtenir des informations sur l'expérience utilisateur réelle. En surveillant les métriques de performance du frontend, en traçant les parcours utilisateur et en les corrélant avec la santé du système backend, ils peuvent comprendre comment les problèmes d'infrastructure ou les erreurs d'application impactent directement la satisfaction des utilisateurs, les taux de conversion et les résultats commerciaux globaux.

4

Rationaliser la Détection et l'Investigation des Incidents de Sécurité

Les analystes de sécurité exploitent les plateformes d'Observabilité pour la gestion centralisée des journaux et la détection d'anomalies afin d'identifier les activités suspectes ou les potentielles violations. En corrélant les événements de sécurité à travers divers composants du système et en traçant leur origine, ils peuvent rapidement enquêter sur les incidents, comprendre leur portée et mettre en œuvre des contre-mesures efficaces, améliorant ainsi la posture de sécurité globale du système.

5

Valider les Nouveaux Déploiements et les Versions de Fonctionnalités

Les équipes de développement et d'assurance qualité utilisent les outils d'Observabilité pour surveiller en temps réel la santé et les performances des nouveaux déploiements de code et des versions de fonctionnalités. En comparant les métriques et les journaux avant et après un déploiement, elles peuvent rapidement détecter les régressions, les goulots d'étranglement de performance ou les erreurs inattendues, permettant un retour arrière rapide ou des correctifs d'urgence et assurant la stabilité de l'environnement de production.

6

Surveiller la Santé et l'Efficacité des Coûts de l'Infrastructure Cloud

Les équipes d'opérations cloud utilisent les plateformes d'Observabilité pour obtenir une visibilité complète de leur infrastructure cloud dynamique. Elles surveillent l'utilisation des ressources, les performances réseau et la disponibilité des services chez divers fournisseurs de cloud. Cela leur permet d'identifier les ressources sous-utilisées, d'optimiser les dépenses cloud et d'assurer la résilience et l'efficacité de leurs applications et services cloud-natifs.

Observabilité FAQ

Qu'est-ce que l'Observabilité dans les opérations informatiques ?

L'Observabilité dans les opérations informatiques fait référence à la capacité d'inférer l'état interne d'un système en examinant ses sorties externes, telles que les journaux (logs), les métriques et les traces. Elle est cruciale pour comprendre la santé, les performances et le comportement du système dans des environnements distribués complexes. Contrairement à la surveillance traditionnelle, l'Observabilité se concentre sur la réponse à la question *pourquoi* quelque chose se produit, et pas seulement *quoi*.

En quoi l'Observabilité diffère-t-elle de la Surveillance traditionnelle ?

La surveillance traditionnelle se concentre généralement sur les inconnues connues, vérifiant les métriques et les alertes prédéfinies pour les défaillances attendues. L'Observabilité, cependant, vise à aborder les inconnues inconnues en fournissant des données riches et contextuelles (journaux, métriques, traces) qui permettent aux ingénieurs d'explorer et de comprendre les comportements inattendus du système. La surveillance vous dit *si* un système est en panne ; l'Observabilité vous aide à comprendre *pourquoi* il est en panne et *comment* il en est arrivé là.

Quels sont les 'trois piliers' de l'Observabilité ?

Les 'trois piliers' de l'Observabilité sont les Journaux (Logs), les Métriques et les Traces. Les journaux sont des enregistrements discrets et horodatés d'événements au sein d'un système. Les métriques sont des valeurs numériques représentant des points de données mesurés au fil du temps, souvent agrégées (par exemple, utilisation du CPU, nombre de requêtes). Les traces offrent une vue de bout en bout du parcours d'une seule requête à travers un système distribué, montrant comment les différents services interagissent et où la latence se produit. Ensemble, ils offrent une vue holistique du comportement du système.

Qui bénéficie le plus de l'utilisation des outils d'Observabilité ?

Un large éventail de rôles bénéficie des outils d'Observabilité. Les équipes DevOps et SRE les utilisent pour la surveillance proactive, la réponse aux incidents et l'optimisation des performances. Les développeurs obtiennent des informations sur le comportement des applications en production, aidant au débogage et au développement de fonctionnalités. Les équipes d'Opérations informatiques assurent la santé et la fiabilité de l'infrastructure. Les équipes de Sécurité les exploitent pour la détection des menaces et l'investigation des incidents. Même les Chefs de produit peuvent les utiliser pour comprendre l'impact des performances du système sur l'expérience utilisateur et les métriques commerciales.

Que dois-je considérer lors du choix d'une plateforme d'Observabilité ?

Lors du choix d'une plateforme d'Observabilité, considérez plusieurs facteurs clés. Premièrement, évaluez ses capacités d'intégration avec votre pile technologique existante (fournisseurs de cloud, bases de données, files d'attente de messages). Deuxièmement, évaluez sa scalabilité et ses politiques de rétention des données pour gérer votre volume de données attendu et vos besoins de conformité. Troisièmement, recherchez des fonctionnalités robustes d'alertes et de détection d'anomalies. Enfin, considérez le modèle de coût (souvent basé sur l'ingestion/le stockage des données), la facilité d'utilisation et la qualité de ses outils de visualisation et de tableaux de bord pour des informations exploitables.