
ToolMage
Connexion

Best 1 Ingénierie de la fiabilité des sites AI tools for Opérations

Popular Ingénierie de la fiabilité des sites AI tools in Opérations include Kubiks, helping you work more efficiently.

Kubiks
Freemium

Kubiks

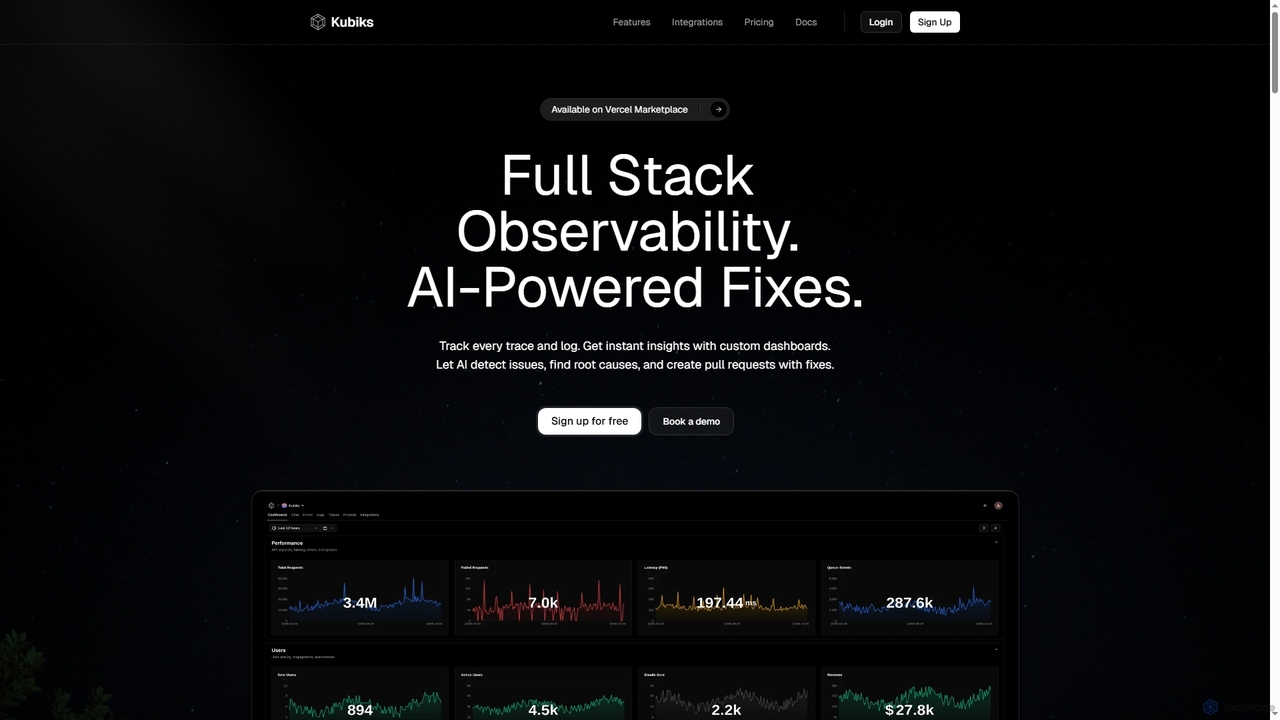
Kubiks est une plateforme d'observabilité full-stack alimentée par l'IA, offrant le traçage distribué, la journalisation et des tableaux de bord personnalisés. Elle détecte automatiquement les problèmes, identifie les causes profondes et génère des pull requests avec des correctifs, aidant les équipes d'ingénierie à déboguer plus rapidement et à résoudre les problèmes de manière proactive.

Débogage
Visits 10.8KFavorites 171Likes 175

About Ingénierie de la fiabilité des sites

L'Ingénierie de la Fiabilité des Sites (SRE) est une discipline qui applique les principes de l'ingénierie logicielle aux problèmes d'infrastructure et d'opérations, visant à créer des systèmes hautement fiables et évolutifs. Elle s'appuie sur l'automatisation, la prise de décision basée sur les données et une focalisation sur les objectifs de niveau de service (SLO) pour garantir la stabilité et la performance des services critiques. En tant que composant essentiel de la catégorie plus large des Opérations, les outils SRE permettent aux équipes de gérer de manière proactive la santé du système, de répondre efficacement aux incidents et d'améliorer continuellement la fiabilité des services.

Fonctionnalités Clés

  • Surveillance SLO/SLA: Suivi et rapport des objectifs et accords de niveau de service pour garantir l'atteinte des cibles de performance.
  • Gestion et Automatisation des Incidents: Rationalisation de la détection, de l'alerte, de la réponse et de la résolution des incidents grâce à des flux de travail automatisés.
  • Gestion du Budget d'Erreurs: Définition et suivi des niveaux acceptables d'indisponibilité, guidant les priorités de développement et d'exploitation.
  • Observabilité et Surveillance: Fourniture d'informations complètes sur le comportement du système via les journaux, les métriques et les traces pour une identification proactive des problèmes.
  • Planification de la Capacité: Prévision des besoins en ressources et optimisation de l'infrastructure pour gérer les charges anticipées et prévenir les pannes.

Scénarios Applicables

Les outils SRE sont essentiels pour les organisations gérant des systèmes complexes et distribués, tels que les grandes plateformes de commerce électronique, les fournisseurs SaaS et les services financiers. Ils permettent aux équipes SRE, aux ingénieurs DevOps et aux ingénieurs de plateforme de maintenir une haute disponibilité, de gérer la fiabilité des microservices et d'automatiser les tâches opérationnelles critiques, assurant ainsi des expériences utilisateur fluides et la continuité des activités.

Comment Choisir

Lors de la sélection d'outils SRE, privilégiez les solutions offrant des fonctionnalités d'observabilité robustes, une intégration transparente avec les pipelines CI/CD et les plateformes cloud existantes, ainsi que des capacités complètes de gestion des incidents. Considérez l'évolutivité de l'outil, ses fonctionnalités de rapport pour la conformité SLO et sa capacité à prendre en charge le suivi du budget d'erreurs. La convivialité et le support communautaire sont également cruciaux pour une adoption efficace par l'équipe.

Ingénierie de la fiabilité des sites use cases

1

Automatisation des Flux de Travail de Réponse aux Incidents

Pour les ingénieurs d'astreinte et les équipes SRE, les outils SRE basés sur l'IA automatisent la détection des anomalies et des incidents critiques à travers les systèmes distribués. Ils peuvent déclencher des alertes, initier des scripts de diagnostic et même suggérer des étapes de remédiation basées sur des données historiques, réduisant significativement le temps moyen de résolution (MTTR) et minimisant les perturbations de service lors de pannes critiques.

2

Surveillance et Application des Objectifs de Niveau de Service (SLO)

Les équipes SRE utilisent ces outils pour définir, surveiller et appliquer les Objectifs de Niveau de Service (SLO) pour les services critiques. Les outils collectent et analysent continuellement des métriques (par exemple, latence, taux d'erreur, disponibilité), fournissant des tableaux de bord en temps réel et des alertes lorsque les SLO sont menacés, permettant aux équipes d'aborder de manière proactive la dégradation des performances avant qu'elle n'impacte les utilisateurs.

3

Planification Proactive de la Capacité et Optimisation des Ressources

Les architectes d'infrastructure et les SRE exploitent les outils SRE pour une planification de capacité basée sur les données. En analysant les modèles d'utilisation historiques et en prédisant la demande future, ces outils aident à optimiser l'allocation des ressources, à prévenir les goulots d'étranglement et à garantir que les systèmes peuvent évoluer efficacement pour faire face aux pics de trafic, évitant ainsi un surprovisionnement coûteux ou des pannes de service dues à un sous-provisionnement.

4

Réalisation d'Analyses Post-Mortem Sans Blâme

Après un incident, les outils SRE facilitent une analyse post-mortem complète en agrégeant les journaux, les métriques et les traces provenant de diverses sources. Cela permet aux équipes SRE et de développement d'identifier les causes profondes, de comprendre les facteurs contributifs et de documenter les leçons apprises sans attribuer de blâme, favorisant une culture d'amélioration continue et prévenant la récurrence de problèmes similaires.

5

Mise en Œuvre et Gestion des Budgets d'Erreurs

Les propriétaires de produits et les SRE utilisent ces outils pour mettre en œuvre et gérer les budgets d'erreurs, qui quantifient la quantité acceptable d'indisponibilité pour un service. Les outils suivent la consommation du budget d'erreurs en temps réel, fournissant des signaux clairs aux équipes produit et d'ingénierie sur le moment de prioriser le travail de fiabilité par rapport au développement de nouvelles fonctionnalités, équilibrant ainsi innovation et stabilité.

6

Amélioration de l'Observabilité des Systèmes Distribués Complexes

Les ingénieurs de plateforme et les SRE déploient ces outils pour obtenir une observabilité approfondie des architectures de microservices et des applications cloud-natives. En corrélant les métriques, les journaux et les traces à travers des centaines ou des milliers de services, les outils fournissent une vue unifiée de la santé du système, permettant un débogage rapide, un réglage des performances et une compréhension holistique du comportement du système.

Ingénierie de la fiabilité des sites FAQ

Qu'est-ce que l'Ingénierie de la Fiabilité des Sites (SRE) ?

L'Ingénierie de la Fiabilité des Sites (SRE) est une approche d'ingénierie logicielle appliquée aux opérations informatiques, axée sur la construction et l'exploitation de systèmes à grande échelle et hautement fiables. Elle vise à combler le fossé entre le développement et les opérations en appliquant des principes d'ingénierie aux problèmes opérationnels, en mettant l'accent sur l'automatisation, la mesure et l'amélioration continue pour atteindre des objectifs de niveau de service (SLO) spécifiques.

En quoi l'Ingénierie de la Fiabilité des Sites (SRE) diffère-t-elle des Opérations traditionnelles ?

La SRE diffère des Opérations traditionnelles en adoptant une mentalité d'ingénierie logicielle. Alors que les Ops traditionnelles se concentrent souvent sur les tâches manuelles et les réponses réactives, la SRE met l'accent sur l'automatisation, la résolution proactive des problèmes et le traitement des opérations comme un problème logiciel. Les équipes SRE écrivent souvent du code pour automatiser les tâches, gérer les systèmes de manière programmatique et utiliser des budgets d'erreurs pour équilibrer la fiabilité et la vélocité des fonctionnalités, allant au-delà de la simple mentalité de « maintenir les lumières allumées ».

Quelles sont les métriques clés sur lesquelles les équipes SRE se concentrent ?

Les équipes SRE se concentrent principalement sur les Indicateurs de Niveau de Service (SLI), les Objectifs de Niveau de Service (SLO) et les Accords de Niveau de Service (SLA). Les SLI clés incluent la latence, le débit, le taux d'erreur et la disponibilité. Les SLO sont des cibles spécifiques pour ces SLI (par exemple, 99,9 % de disponibilité). Les SLA sont des contrats formels basés sur les SLO, souvent avec des pénalités. Les budgets d'erreurs, dérivés des SLO, sont également cruciaux pour guider les priorités de développement.

Comment les outils d'IA peuvent-ils aider l'Ingénierie de la Fiabilité des Sites ?

Les outils d'IA améliorent considérablement la SRE en automatisant les tâches répétitives, en améliorant la détection des anomalies et en prédisant les pannes potentielles. Ils peuvent analyser de vastes quantités de données de télémétrie (journaux, métriques, traces) pour identifier des modèles, corréler des événements à travers des systèmes distribués, et même suggérer des causes profondes ou des étapes de remédiation pour les incidents. Cela permet aux SRE de passer de la résolution réactive des problèmes à un travail proactif et stratégique, optimisant plus efficacement les performances et la fiabilité du système.

Que dois-je considérer lors du choix des outils SRE ?

Lors de la sélection des outils SRE, considérez leur capacité à fournir une observabilité complète (métriques, journaux, traces), une gestion des incidents et des alertes robuste, ainsi qu'un support pour la définition et le suivi des SLO et des budgets d'erreurs. Recherchez de solides capacités d'intégration avec votre infrastructure existante (fournisseurs de cloud, CI/CD, systèmes de surveillance) et une interface conviviale. L'évolutivité, la sécurité, ainsi que le support et la communauté du fournisseur sont également des facteurs essentiels.