ToolMage
Connexion

Best 2 Base de données AI tools for Ressources

Popular Base de données AI tools in Ressources include abcdindex et llm_price, helping you work more efficiently.

llm_price
Free

llm_price

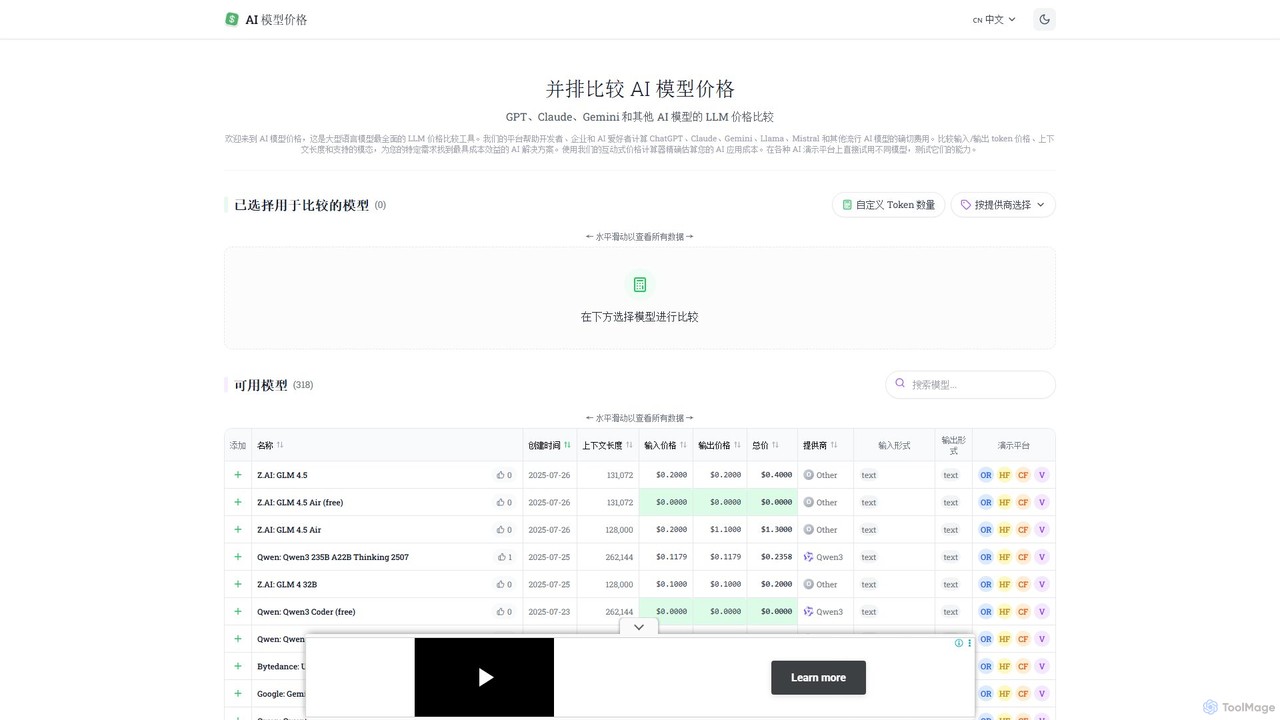
llm_price est un outil de comparaison complet pour la tarification des API des grands modèles de langage (LLM). Il permet aux développeurs, aux entreprises et aux passionnés d'IA de comparer facilement les coûts de centaines de modèles de fournisseurs tels que OpenAI, Google, Anthropic et Mistral. Avec un calculateur de coûts interactif et une analyse côte à côte des prix des jetons, des longueurs de contexte et des modalités, il simplifie le processus de sélection de la solution d'IA la plus rentable pour tout projet.

Gestion des API
Visits 13.1KFavorites 121Likes 136
abcdindex
Free

abcdindex

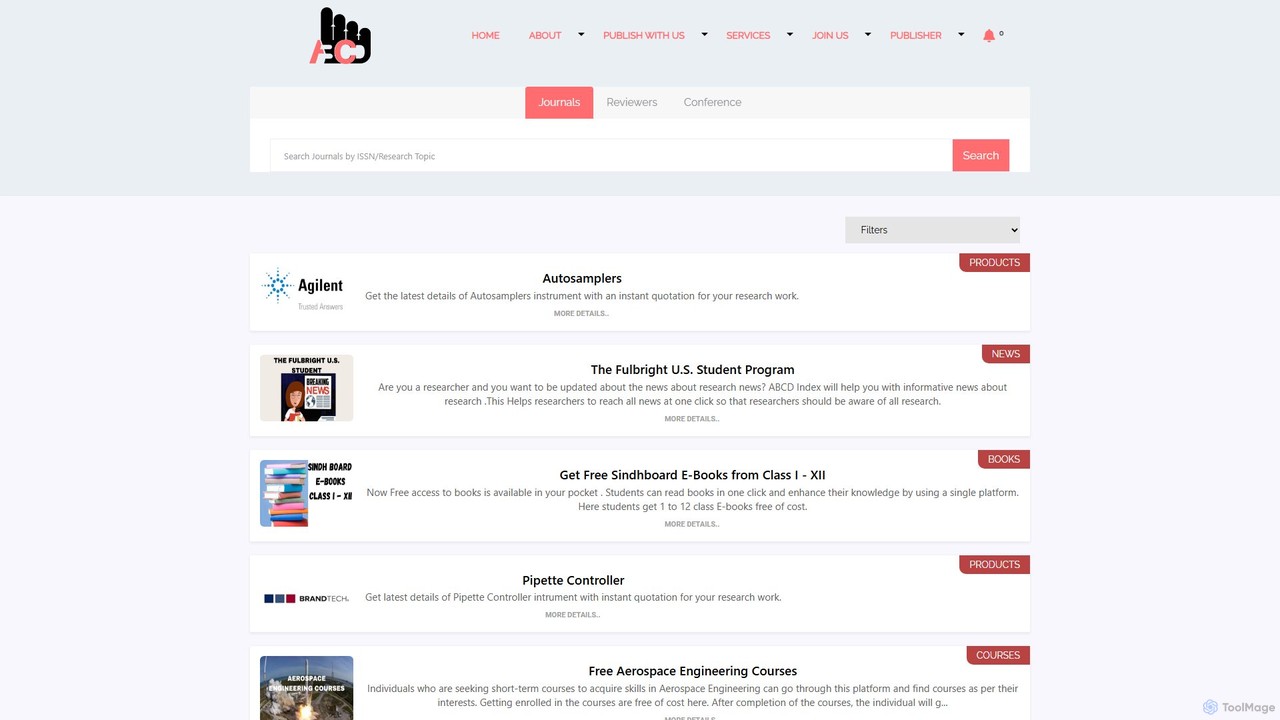
abcdindex (Academic Business Current Data Index) est une plateforme gratuite et complète pour la communauté universitaire. Elle fournit une base de données vérifiée et structurée de revues internationales, d'articles de recherche, d'opportunités de financement, de bourses et d'autres ressources académiques. La plateforme vise à aider les chercheurs, les étudiants et les éditeurs à naviguer efficacement dans le paysage académique et à éviter les publications prédatrices ou inactives en offrant des informations fiables et centralisées.

Recherche
Visits 158KFavorites 164Likes 154

About Base de données

Les bases de données pour l'IA sont des collections organisées de données structurées qui servent de ressource fondamentale pour l'entraînement, le test et le déploiement de modèles d'intelligence artificielle. Ces ressources sont spécifiquement préparées pour être consommées par des machines, contenant souvent de vastes quantités de données étiquetées ou non, telles que des images, du texte ou des chiffres. Elles fournissent la matière première essentielle pour l'apprentissage automatique, le traitement du langage naturel et les tâches de vision par ordinateur. La qualité, l'échelle et la pertinence de ces bases de données déterminent directement les performances et les capacités d'un système d'IA.

Fonctionnalités Clés

  • Données Structurées et Étiquetées : Les données sont organisées et souvent annotées avec des étiquettes, ce qui les rend adaptées aux algorithmes d'apprentissage supervisé.
  • Grande Échelle : Contiennent généralement des millions, voire des milliards de points de données pour garantir que les modèles puissent apprendre des schémas généralisables.
  • Spécificité du Domaine : Axées sur des domaines particuliers tels que la médecine, la finance ou la conduite autonome pour construire une IA spécialisée.
  • Qualité et Cohérence des Données : Nettoyées et validées pour minimiser le bruit et les biais, ce qui est crucial pour construire des modèles fiables.

Cas d'Utilisation

Les bases de données pour l'IA sont essentielles pour les scientifiques des données, les ingénieurs en apprentissage automatique et les chercheurs. Elles sont utilisées pour entraîner des systèmes de reconnaissance faciale avec des ensembles de données d'images, développer des modèles de langage à l'aide de corpus de textes massifs et construire des algorithmes de détection de fraude à partir de données de transactions historiques. Les institutions académiques utilisent également des ensembles de données standardisés pour évaluer les performances de nouveaux algorithmes d'IA.

Comment Choisir

Lors de la sélection d'une base de données pour l'IA, considérez sa pertinence par rapport à votre domaine de problème spécifique. Évaluez la qualité des données, la précision de ses étiquettes et la présence de biais potentiels. Vérifiez les termes de la licence pour vous assurer qu'elle peut être utilisée pour votre objectif prévu (par exemple, académique ou commercial). Enfin, évaluez le format et la taille des données pour confirmer la compatibilité avec vos ressources de calcul et votre chaîne d'outils.

Base de données use cases

1

Entraînement d'un modèle d'analyse d'images médicales

Un chercheur en IA dans le secteur de la santé doit développer un modèle capable de détecter les signes précoces de maladies à partir de scanners médicaux comme les radiographies ou les IRM. Il utilise une base de données spécialisée et de haute qualité contenant des milliers d'images médicales anonymisées, chacune méticuleusement annotée par des radiologues. En entraînant un modèle de vision par ordinateur sur cet ensemble de données, le système apprend à identifier des motifs subtils associés à des conditions spécifiques. L'outil d'IA qui en résulte peut aider les radiologues en mettant en évidence les zones potentiellement préoccupantes, ce qui conduit à des diagnostics plus rapides et plus précis.

2

Développement d'un modèle de Traitement du Langage Naturel (TLN)

Une équipe de science des données est chargée de créer un outil d'analyse des sentiments pour les avis clients. Pour ce faire, elle exploite une base de données textuelles à grande échelle contenant des millions d'avis sur des produits, chacun étant étiqueté comme positif, négatif ou neutre. Ce corpus sert de vérité terrain pour l'entraînement de leur modèle de TLN. Le modèle traite le texte, apprend les nuances du langage et identifie les schémas qui correspondent à différents sentiments. Après l'entraînement, l'outil peut classer automatiquement les nouveaux avis non vus, fournissant à l'entreprise des informations précieuses sur la satisfaction client à grande échelle.

3

Création d'un système de détection de fraude financière

Une entreprise de technologie financière vise à réduire les transactions frauduleuses pour ses utilisateurs. Leurs ingénieurs en apprentissage automatique utilisent une base de données historique massive de données de transactions. Cette base de données comprend des caractéristiques telles que le montant de la transaction, l'heure, le lieu et le type de commerçant, chaque transaction étant étiquetée comme légitime ou frauduleuse. En entraînant un modèle de détection d'anomalies sur ces données, le système apprend les caractéristiques du comportement transactionnel normal. Lorsqu'une nouvelle transaction se produit, le modèle peut prédire la probabilité qu'elle soit frauduleuse en temps réel, permettant à l'entreprise de bloquer les activités suspectes et de protéger ses clients.

4

Évaluation comparative de nouveaux algorithmes d'IA

Un laboratoire de recherche universitaire développe un nouvel algorithme pour la reconnaissance d'objets. Pour prouver son efficacité, il doit comparer ses performances aux méthodes de pointe existantes. Il utilise une base de données publique et standardisée comme ImageNet ou COCO, qui sont largement acceptées dans la communauté de la recherche pour l'évaluation comparative. En exécutant son nouvel algorithme et les algorithmes établis sur le même ensemble de données, il peut obtenir des métriques objectives comme la précision et la vitesse de traitement. Cela lui permet de publier ses résultats avec des données vérifiables, contribuant ainsi à l'avancement du domaine de l'IA.

5

Alimentation d'un système de questions-réponses basé sur la connaissance

Une entreprise de technologie juridique souhaite créer un assistant IA capable de répondre à des questions juridiques complexes. Au lieu d'un corpus de texte général, elle utilise une base de connaissances spécialisée — une base de données structurée contenant des statuts juridiques, de la jurisprudence et des articles universitaires, tous interconnectés via un graphe de connaissances. Lorsqu'un avocat pose une question, l'IA ne se contente pas de rechercher des mots-clés ; elle navigue dans ce graphe pour comprendre les relations et le contexte. Cela permet au système de fournir des réponses très précises, contextuelles et étayées par des citations juridiques spécifiques, agissant comme un puissant outil de recherche pour les professionnels du droit.

6

Création de données synthétiques pour les tests de modèles d'IA

Une équipe de développement d'IA construit un système de voiture autonome mais manque de données réelles suffisantes pour les cas limites rares, comme des animaux traversant soudainement la route. Ils utilisent une base de données fondamentale de scénarios de conduite pour générer de vastes quantités de données synthétiques réalistes. Ce processus leur permet de créer des milliers de variations d'un seul scénario, en modifiant les conditions météorologiques, l'éclairage et la vitesse des objets. En testant leur modèle sur cette base de données synthétique complète, ils peuvent s'assurer que l'IA est robuste et fiable dans des situations trop dangereuses ou rares pour être capturées dans la réalité, le tout sans compromettre la vie privée des utilisateurs.

Base de données FAQ

Qu'est-ce qu'une ressource de base de données pour l'IA ?

Une base de données pour l'IA est une vaste collection de données organisées spécifiquement pour l'entraînement et le test de modèles d'intelligence artificielle. Contrairement aux bases de données à usage général, celles-ci sont conçues comme des ressources, contenant souvent des millions d'exemples étiquetés (comme des images avec des descriptions ou du texte avec des étiquettes de sentiment). Elles servent de « manuels » à partir desquels les algorithmes d'apprentissage automatique apprennent à effectuer des tâches telles que la reconnaissance d'objets, la compréhension du langage ou la détection d'anomalies.

Comment choisir la bonne base de données d'IA pour un projet ?

Le choix de la bonne base de données d'IA dépend de plusieurs facteurs. Premièrement, assurez-vous que les données sont très pertinentes pour votre problème spécifique. Deuxièmement, évaluez la qualité des données, y compris leur propreté, la précision des étiquettes et les biais potentiels. Troisièmement, vérifiez l'accord de licence pour confirmer qu'il autorise votre cas d'utilisation (par exemple, commercial ou académique). Enfin, tenez compte du format et de la taille de la base de données pour vous assurer qu'elle est compatible avec votre infrastructure technique et vos outils.

Quelle est la différence entre un jeu de données public et une base de données propriétaire ?

La principale différence réside dans l'accessibilité et la propriété.

  • Les jeux de données publics (par exemple, ImageNet, Wikipedia Corpus) sont ouvertement disponibles, souvent gratuitement, principalement pour la recherche universitaire et l'évaluation comparative publique. Ils favorisent la collaboration et l'évaluation standardisée.
  • Les bases de données propriétaires sont des actifs privés appartenant à une entreprise. Elles contiennent souvent des données sensibles ou hautement spécialisées (comme les transactions des clients ou des documents internes) et offrent un avantage concurrentiel significatif pour le développement de solutions d'IA uniques.

Pourquoi la qualité des données est-elle si importante dans une base de données d'IA ?

La qualité des données est primordiale car les modèles d'IA apprennent directement des données qui leur sont fournies. Le principe de « déchet entrant, déchet sortant » est fondamental ici. Des données de haute qualité — précises, complètes, cohérentes et non biaisées — conduisent à des modèles d'IA plus fiables, précis et équitables. Inversement, des données de mauvaise qualité avec des erreurs, des biais ou des incohérences aboutiront à un modèle peu performant qui prend des décisions peu fiables, voire nuisibles.

Quels sont les types de données courants dans les bases de données d'IA ?

Les bases de données d'IA peuvent contenir une grande variété de types de données, adaptés à la tâche d'IA spécifique. Les types courants incluent :

  • Données d'image : Collections de photos ou de vidéos, souvent avec des étiquettes pour la détection d'objets ou la classification d'images.
  • Données textuelles : Vastes corpus de textes provenant de livres, d'articles ou de sites web pour l'entraînement de modèles de langage.
  • Données tabulaires : Données structurées en lignes et colonnes, comme des feuilles de calcul, utilisées pour l'analyse prédictive et les prévisions.
  • Données audio : Enregistrements de parole ou de sons, généralement avec des transcriptions, pour les systèmes de reconnaissance vocale.
  • Données de séries chronologiques : Points de données indexés dans l'ordre chronologique, tels que les cours des actions ou les relevés de capteurs, pour les modèles de prévision.